
Anwendbarkeit auf ArmSoM und Quellen
Dies ist eine Referenz für die Rockchip-Plattform und kein ArmSoM-Hardwaretest. Quelle ist das RKNN SDK User Guide V2.3.2 mit 165 chinesischen und 178 englischen Seiten. Die chinesische Fassung folgt dem chinesischen Original, Englisch, Russisch und Deutsch folgen dem englischen. Chinesische Originalabbildungen werden nur in der chinesischen Fassung verwendet; die übrigen Fassungen verwenden englische Originale. Unterstützte SoCs und Softwarevoraussetzungen der Vorlage bleiben unten erhalten; die Kompatibilität einer konkreten ArmSoM-Platine mit SDK/BSP, Kerneltreiber und RKNN Runtime wurde nicht geprüft. Vor der Bereitstellung sind SoC, NPU-Treiber, SDK-/Runtime-Versionen und Operatorunterstützung abzugleichen. Alle Leistungs-, Genauigkeits-, Speicher-, Adress- und Protokollbeispiele stammen aus der Vorlage. Es wurden weder Beispielcode ausgeführt noch Hardwaretests vorgenommen.
Die Quellen derselben Version unterscheiden sich: Das chinesische Ablaufdiagramm zur Leistungsanalyse fehlt im Englischen; der englische Text zur dünn besetzten Inferenz ergänzt eine Gewichts-Kanalzahl größer als 32; auch das Speicherbewertungsbeispiel unterscheidet sich. Quellfehler, widersprüchliche API-Beschreibungen, fehlende Werte und bereits im Original abgeschnittener Screenshottext bleiben erhalten und werden dokumentiert, nicht stillschweigend korrigiert. Formeln stehen als bearbeitbare Notation neben den Originalausschnitten; round bezeichnet die Rundungsoperation der Vorlage. Seitengenaue Einzelheiten enthalten die redaktionellen Hinweise.
EDITORIAL-NOTES · ArmSoM · RKNN-Toolkit2
1 Einführung in RKNN
1.1 Einführung in die RKNN-Werkzeugkette
1.1.1 Überblick über den RKNN-Softwarestack
Der RKNN-Softwarestack ermöglicht die schnelle Bereitstellung von KI-Modellen auf Rockchip-Chips. Die Gesamtstruktur ist nachfolgend dargestellt:
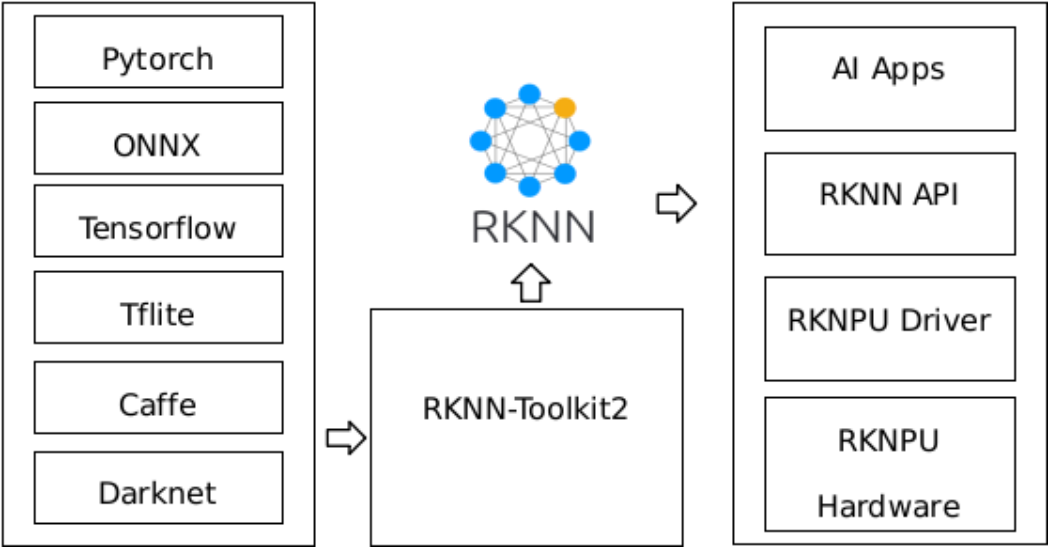
Abbildung 1-1: RKNN-Softwarestack
Um RKNPU zu verwenden, führen Sie zunächst RKNN-Toolkit2 auf dem Computer aus und konvertieren das trainierte Modell in das RKNN-Format. Anschließend stellen Sie es mithilfe der RKNN-C-API oder Python auf der Entwicklungsplatine bereit.
1.1.2 Funktionen von RKNN-Toolkit2
RKNN-Toolkit2 ist eine Entwicklungsumgebung für Modellkonvertierung, Inferenz und Modellbewertung auf dem Computer. Das grundlegende Blockdiagramm ist nachfolgend dargestellt:
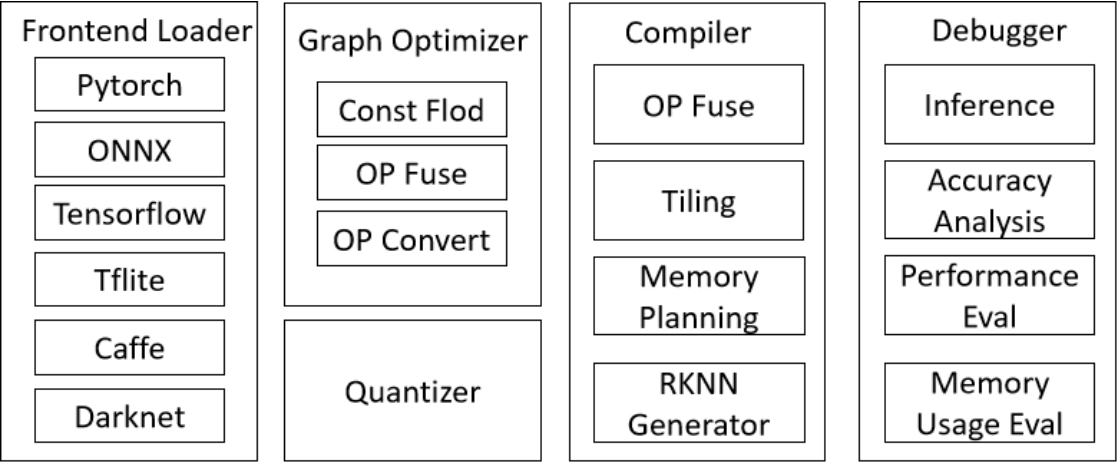
Abbildung 1-2: Softwarediagramm von RKNN-Toolkit2
Die praktische Python-Schnittstelle stellt folgende Funktionen bereit:
1. Modellkonvertierung: Umwandlung von Modellen aus PyTorch, ONNX, TensorFlow, TensorFlow Lite, Caffe, DarkNet und weiteren Formaten in RKNN-Modelle.
2. Quantisierung: Quantisierung von Gleitkommamodellen zu Festkommamodellen. Auch gemischte Quantisierung wird unterstützt.
3. Modellinferenz: Übertragen des RKNN-Modells auf das angegebene NPU-Gerät zur Inferenz und Ergebnisausgabe oder Simulieren der NPU auf dem Computer, um das RKNN-Modell auszuführen und Ergebnisse zu erhalten.
4. Leistungs- und Speicherbewertung: Übertragen des RKNN-Modells auf das angegebene NPU-Gerät, um Leistung und Speicherverbrauch bei der Ausführung auf dem tatsächlichen Gerät zu bewerten.
5. Analyse der Quantisierungsgenauigkeit: Ermittlung des Kosinusabstands und des euklidischen Abstands zwischen den Inferenzergebnissen jeder Schicht des quantisierten Modells und des Gleitkommamodells. Dadurch lassen sich Quantisierungsfehler untersuchen und Informationen zur Verbesserung der Genauigkeit gewinnen.
6. Modellverschlüsselung: Verschlüsselung des gesamten RKNN-Modells mit der angegebenen Verschlüsselungsstufe.
1.1.3 Funktionen der RKNN Runtime
Die RKNN Runtime lädt hauptsächlich RKNN-Modelle und ruft den NPU-Treiber auf, um sie auf der NPU auszuführen. Die ursprünglichen Daten durchlaufen bei der Inferenz drei Hauptschritte: Eingabevorverarbeitung, Modellausführung auf der NPU und Ausgabenachverarbeitung. Je nach Eingabeformat und Quantisierungsverfahren bietet die RKNN Runtime zwei Verarbeitungsabläufe: die allgemeine API und die Zero-Copy-API.
Allgemeine API: Ein einfacher, leicht verwendbarer Satz von Inferenzschnittstellen. Abbildung 1-3 zeigt den Ablauf. Normalisierung, Quantisierung, Datenlayoutkonvertierung und Dequantisierung erfolgen auf der CPU; die Modellinferenz läuft auf der NPU.
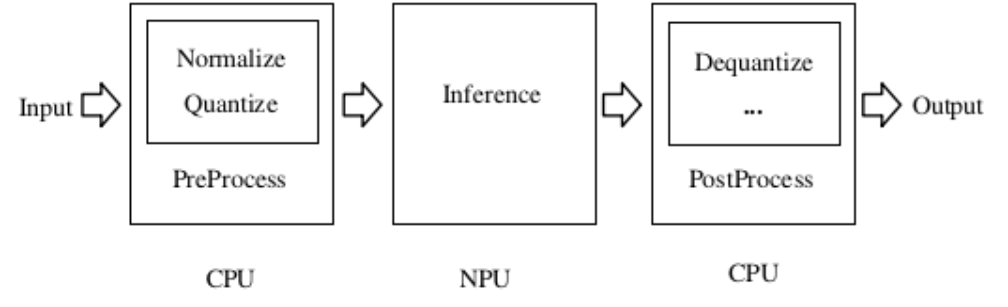
Abbildung 1-3: Datenverarbeitung der allgemeinen API
Zero-Copy-API: Der Ablauf in Abbildung 1-4 optimiert die Datenverarbeitung der allgemeinen API. Normalisierung, Quantisierung und Modellinferenz erfolgen auf der NPU; Layoutkonvertierung und Dequantisierung der NPU-Ausgabe auf CPU oder NPU. Die Zero-Copy-API verarbeitet den Eingabedatenstrom effizienter. Sie ermöglicht den Datenaustausch zwischen verschiedenen IP-Kernen ohne Kopieren und reduziert dadurch CPU- und DDR-Bandbreitenbedarf. Beispielsweise lassen sich Kameradaten oder dekodierte Daten direkt über die Zero-Copy-API in die NPU übernehmen.
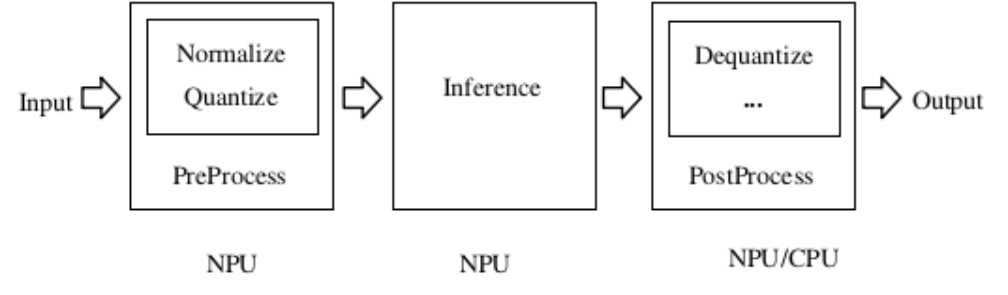
Abbildung 1-4: Datenverarbeitung der Zero-Copy-API
Besitzen die Eingabedaten nur eine virtuelle Adresse, kann ausschließlich die allgemeine API verwendet werden. Bei einer physischen Adresse oder einem Dateideskriptor (fd) sind beide APIs verwendbar.
1.2 RKNN-Entwicklungsablauf
Das Flussdiagramm veranschaulicht die grundlegenden RKNN-Entwicklungsschritte: Modellkonvertierung, Modellbewertung sowie Bereitstellung und Ausführung auf der Platine.
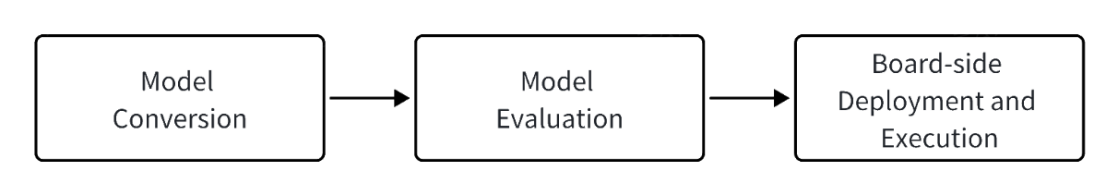
Abbildung 1-5: RKNN-Entwicklungsablauf
1.2.1 Modellkonvertierung
In diesem Schritt wird das ursprüngliche Deep-Learning-Modell für eine effiziente Inferenz auf RKNPU-Plattformen in das RKNN-Format konvertiert. Dazu gehören:
Ausgangsmodell beschaffen: Ein Deep-Learning-Modell aus gängigen Frameworks wie ONNX, PyTorch oder TensorFlow beschaffen oder trainieren.
Modell konfigurieren: Die erforderlichen Parameter in RKNN-Toolkit2 angeben, beispielsweise Mittelwerte, Normalisierung, Quantisierungsoptionen und Zielplattform.
Modell laden: Das Modell über die geeignete Ladeschnittstelle in RKNN-Toolkit2 importieren und das zum Modelltyp passende Ladeverfahren wählen.
Modell erstellen: Das RKNN-Modell mit rknn.build() erstellen. Optional kann eine Quantisierung durchgeführt werden, um die Leistung auf der Hardware zu verbessern.
Modell exportieren: Das RKNN-Modell mit rknn.export_rknn() als Datei im .rknn-Format für die spätere Bereitstellung exportieren.
Weitere Informationen finden Sie in den Abschnitten 3.1 und 4.2.1.
1.2.2 Modellbewertung
Die Modellbewertung hilft dabei, Leistung, Quantisierungsgenauigkeit und Speicherverbrauch auf der Platine zu analysieren. Sie umfasst hauptsächlich folgende Vorgänge:
Modellprüfung mit angeschlossener Platine: Python verbindet den PC mit der RKNPU-Plattform zur Inferenz und Modellvalidierung. Dazu gehören die Vorverarbeitung der Eingabedaten und die Nachverarbeitung der Ergebnisse, um die korrekte Modellausführung auf der Platine sicherzustellen.
Genauigkeitsbewertung: Mit rknn.accuracy_analysis() die Ausgaben des quantisierten Modells und des Gleitkommamodells vergleichen und Quantisierungsfehler analysieren.
Leistungsbewertung: Mit rknn.eval_perf() die Inferenzleistung auf der Plattform ermitteln, um die Modellstruktur weiter zu optimieren und die Inferenz zu beschleunigen.
Speicherbewertung: Mit rknn.eval_memory() den Speicherverbrauch auf der Platine ermitteln, um die Modellstruktur zu optimieren und den Speicherbedarf zu minimieren.
Weitere Informationen finden Sie in den Abschnitten 3.2, 3.3, 4.2.2 und 4.2.3.
1.2.3 Bereitstellung und Ausführung auf der Platine
Diese Phase umfasst die tatsächliche Bereitstellung und Ausführung des Modells. Üblicherweise gehören folgende Schritte dazu:
Modellinitialisierung: Das RKNN-Modell auf die RKNPU-Plattform laden und die Vorverarbeitung vorbereiten.
Modellvorverarbeitung: Die Eingabedaten auf die RKNPU-Plattform laden und die Inferenz vorbereiten.
Modellinferenz: Die Eingabedaten an das Modell übergeben, die Inferenz ausführen und die Ergebnisse erhalten.
Modellnachverarbeitung: Die Inferenzergebnisse abrufen, nachverarbeiten und an die Anwendung übergeben.
Modellfreigabe: Nach Abschluss der Inferenz die Modellressourcen freigeben, damit andere Aufgaben das RKNN-Modell verwenden können.
Weitere Informationen finden Sie in den Abschnitten 3.4 und 4.2.3.
Diese drei Phasen bilden den vollständigen RKNN-Entwicklungsablauf für Konvertierung, Prüfung, Bewertung und effiziente Bereitstellung von KI-Modellen auf der RKNPU.
1.3 Unterstützte Hardwareplattformen
Dieses Dokument gilt für folgende Hardwareplattformen:
RV1103, RV1103B, RV1106, RV1106B, RK2118, RK3562, RK3566-Serie, RK3568-Serie, RK3576, RK3588-Serie, RV1126B
Hinweis: RK3566_RK3568 bezeichnet in diesem Dokument die RK3566/RK3568-Serien. RK3588 bezeichnet die RK3588/RK3588S-Serien.
1.4 Glossar
RKNN-Modell: Eine Binärdatei zur Ausführung auf der RKNPU mit der Endung .rknn.
Inferenz mit angeschlossener Platine: Ausführung des Modells über die RKNN-Toolkit2-API, wobei das Modell tatsächlich auf der NPU der Entwicklungsplatine läuft.
DRM: Direct Rendering Manager, ein verbreitetes Framework für die Grafikausgabe unter Linux.
tensor: Ein mehrdimensionales Datenarray.
fd: Ein Dateideskriptor, der einen Puffer repräsentiert.
NATIVE_LAYOUT: Das native Datenlayout der NPU. Bei diesem Speicherlayout erreicht die NPU die beste Datenverarbeitungsleistung.
i8-Modell: Ein quantisiertes RKNN-Modell, das mit vorzeichenbehafteten 8-Bit-Ganzzahlen arbeitet.
fp16-Modell: Ein nicht quantisiertes RKNN-Modell, das mit 16-Bit-Gleitkommazahlen halber Genauigkeit arbeitet.
2 Einrichten der Entwicklungsumgebung
RKNN-Toolkit2 ist in zwei Versionen verfügbar: für x86 und für ARM64. Die Installation ist identisch, außer dass ARM64 Docker noch nicht unterstützt. Außerdem unterstützt ARM64 bei der Konvertierung nur Modelle aus onnx und pytorch; Modelle anderer Frameworks werden derzeit nicht unterstützt.
Unterschiede zwischen den x86- und ARM64-Versionen:
| Deep-Learning-Framework | x86 | ARM64 |
|---|---|---|
| Caffe | ✔ | ✗ |
| TensorFlow | ✔ | ✗ |
| TF Lite | ✔ | ✗ |
| ONNX | ✔ | ✔ |
| DarkNet | ✔ | ✗ |
| PyTorch | ✔ | ✔ |
Unterschiede bei den Werkzeugen:
| Benötigte Werkzeuge | x86 | ARM64 |
|---|---|---|
| adb | ✔ | ✗ |
| rknn_server | ✔ | ✗ |
| rknn runtime | ✔ | ✔ |
Unterschiede bei der Verwendung von x86 und ARM64:
Der wichtigste Unterschied betrifft Debugfunktionen wie Genauigkeitsanalyse und Inferenz. Die ARM64-Version wird unter ARM64 Linux installiert; für diese Funktionen muss lediglich librknnrt.so unter ‘/usr/lib64’ liegen. Da ARM64 adb nicht unterstützt, funktioniert sie nur auf der aktuellen Platine. Bei x86 müssen hingegen rknn_server aktualisiert und verwendet sowie adb bereitgestellt werden, um diese Debugfunktionen zu nutzen und gegebenenfalls eine andere Platine anzuschließen.
Darüber hinaus kann sich die Leistung von x86 und ARM64 bei Genauigkeitsanalyse und Quantisierung unterscheiden.
Hinweis: Zur Vorbereitung der RK2118-Entwicklungsumgebung siehe „Rockchip_RK2118_Quick_Start_RKNN_SDK_EN“.
2.1 Installation von RKNN-Toolkit2
Dieses Kapitel beschreibt zwei Installationsmethoden für RKNN-Toolkit2: Docker und Pip. Wählen Sie die für Sie geeignete Methode.
2.1.1 Installation über Docker
2.1.1.1 Docker installieren
Wenn Docker bereits installiert ist, können Sie diesen Schritt überspringen. Andernfalls installieren Sie es anhand der offiziellen Anleitung: https://docs.docker.com/install/linux/docker-ce/ubuntu/.
Hinweis: Nehmen Sie den Benutzer unbedingt in die Gruppe docker auf.
# Create docker group
sudo groupadd docker
# Add the current user to the docker group
sudo usermod -aG docker $USER
# Update and activate the docker group
newgrp docker
# Verify that sudo is not needed to execute docker commands
docker run hello-world
Bei erfolgreicher Ausführung erscheint folgendes Ergebnis:
Unable to find image 'hello-world:latest' locally
latest: Pulling from library/hello-world
719385e32844: Pull complete
Digest: sha256:88ec0acaa3ec199d3b7eaf73588f4518c25f9d34f58ce9a0df68429c5af48e8d
Status: Downloaded newer image for hello-world:latest
Hello from Docker!
2.1.1.2 Image vorbereiten
Dieser Abschnitt beschreibt zwei Möglichkeiten zur Vorbereitung der RKNN-Toolkit2-Image-Umgebung. Sie können eine davon auswählen.
1. Image-Umgebung mit Dockerfile erstellen
Im Verzeichnis docker/docker_file des RKNN-Toolkit2-Projekts befindet sich die Dockerfile-Datei zum Erstellen der RKNN-Toolkit2-Entwicklungsumgebung. Erstellen Sie das Image mit folgendem Befehl:
cd docker/docker_file/ubuntu_xx_xx_cpxx
docker build -f Dockerfile_ubuntu_xx_xx_for_cpxx -t rknn-toolkit2:x.x.x-cpxx .
2. Vorgefertigtes Docker-Image mit allen Entwicklungsumgebungen laden
Laden Sie die Projektdatei der passenden RKNN-Toolkit2-Version herunter. Nach dem Entpacken enthält das Verzeichnis docker/docker_image ein Docker-Image mit allen Entwicklungsumgebungen.
Downloadlink zum Netzspeicher: https://console.zbox.filez.com/l/I00fc3. Zugriffscode: rknn.
Laden Sie die zur Python-Version passende Image-Datei mit folgendem Befehl:
docker load --input rknn-toolkit2-x.x.x-cpxx-docker.tar.gz
2.1.1.3 Image-Informationen abfragen
Prüfen Sie nach erfolgreicher Erstellung oder dem Laden die Informationen zum Docker-Image:
docker images
Die entsprechenden RKNN-Toolkit2-Image-Informationen werden angezeigt:
REPOSITORY TAG IMAGE ID CREATED SIZE
rknn-toolkit2 x.x.x-cpxx xxxxxxxxxxxx 1 hours ago 5.89GB
2.1.1.4 Image ausführen
Führen Sie das Docker-Image mit folgendem Befehl aus. Anschließend befinden Sie sich in dessen Bash-Umgebung.
docker run -t -i --privileged -v /dev/bus/usb:/dev/bus/usb rknn-toolkit2:x.x.x-cpxx /bin/bash
Mit dem zusätzlichen Parameter -v <host src folder>: <image dst folder> können Sie den Code im Ordner examples in die Docker-Umgebung einbinden.
docker run -t -i --privileged -v /dev/bus/usb:/dev/bus/usb -v /your/rknn-toolkit2-x.x.x/examples:/examples rknn-toolkit2:x.x.x-cpxx /bin/bash
2.1.1.5 Demo ausführen
cd examples/onnx/yolov5
python test.py
Nach erfolgreicher Ausführung des Skripts sollte folgendes Ergebnis erscheinen:
class score xmin, ymin, xmax, ymax
--------------------------------------------------
person 0.884 [ 208, 244, 286, 506]
person 0.868 [ 478, 236, 559, 528]
person 0.825 [ 110, 238, 230, 534]
person 0.339 [ 79, 353, 122, 516]
bus 0.705 [ 92, 128, 554, 467]
2.1.2 Installation über Pip
2.1.2.1 Python-Umgebung installieren
Wenn die Python-Umgebung bereits installiert ist, können Sie diesen Schritt überspringen.
sudo apt-get update
sudo apt-get install python3 python3-dev python3-pip
sudo apt-get install libxslt1-dev zlib1g zlib1g-dev libglib2.0-0 libsm6 libgl1-mesa-glx libprotobuf-dev gcc
Wenn Sie RKNN-Toolkit2 in der lokalen Umgebung statt in einer virtuellen Conda-Umgebung installieren möchten, fahren Sie nach erfolgreicher Python-Installation mit Schritt 2.1.2.4 fort.
2.1.2.2 Conda installieren
Wenn mehrere Python-Versionen installiert sind, empfiehlt sich Conda zur Verwaltung der Python-Umgebung.
Prüfen Sie, ob Conda installiert ist und welche Version vorliegt. Ist Conda bereits installiert, können Sie diesen Schritt überspringen.
conda -V
# Prompt conda: command not found means conda is not installed.
# Successful installation will display the version such as: conda X.X.X
# X.X.X means version number, such as 23.9.0.
Laden Sie das Conda-Installationspaket herunter:
wget -c https://github.com/conda-forge/miniforge/releases/latest/download/Miniforge3-Linux-x86_64.sh
Installieren Sie Conda:
chmod 777 Miniforge3-Linux-x86_64.sh
bash Miniforge3-Linux-x86_64.sh
ARM64-Version:
Laden Sie das Conda-Installationspaket herunter:
wget -c https://github.com/conda-forge/miniforge/releases/latest/download/Miniforge3-Linux-aarch64.sh
Installieren Sie Conda:
chmod 777 Miniforge3-Linux-aarch64.sh
bash Miniforge3-Linux-aarch64.sh
2.1.2.3 Conda-Umgebung für RKNN-Toolkit2 erstellen
Aktivieren Sie die Conda-Basisumgebung:
source ~/miniforge3/bin/activate # Miniforge install directory path
# (base) xxx@xxx-pc:~$
Erstellen Sie eine Conda-Umgebung namens RKNN-Toolkit2 mit der empfohlenen Python-Version 3.8:
conda create -n RKNN-Toolkit2 python=3.8
Aktivieren Sie die Conda-Umgebung RKNN-Toolkit2:
conda activate RKNN-Toolkit2
# (RKNN-Toolkit2) xxx@xxx-pc:~$
2.1.2.4 RKNN-Toolkit2 installieren
Nach Aktivierung der Conda-Umgebung RKNN-Toolkit2 können Sie RKNN-Toolkit2 über die pip-Paketquelle oder ein lokales Wheel-Paket installieren:
Installation über die pip-Paketquelle
pip install rknn-toolkit2 -i https://pypi.org/simple

# If RKNN-Toolkit2 is already installed, you can upgrade it with the following command:
pip install rknn-toolkit2 -i https://pypi.org/simple --upgrade
Installation aus einem lokalen Wheel-Paket
# Please choose the appropriate requirements file based on the Python version and processor architecture:
# where cpxx is the Python version
pip install -r /rknn-toolkit2/packages/x86_64/requirements_cpxx.txt
# pip install -r /rknn-toolkit2/packages/arm64/arm64_requirements_cpxx.txt

# Install RKNN-Toolkit2
# Please choose the appropriate wheel package file based on the Python version and processor architecture:
# where x.x.x is the RKNN-Toolkit2 version number, cpxx is the Python version
pip install /rknn-toolkit2/packages/x86_64/rknn_toolkit2-x.x.x-cpxx-cpxx-manylinux_2_17_x86_64.manylinux2014_x86_64.whl
# pip install /rknn-toolkit2/packages/arm64/rknn_toolkit2-x.x.x-cpxx-cpxx-manylinux_2_17_aarch64.manylinux2014_aarch64.whl
Wenn der folgende Befehl ohne Fehler ausgeführt wird, war die Installation erfolgreich.
$ python
>>> from rknn.api import RKNN
2.2 NPU-Geräteumgebung einrichten
2.2.1 NPU-Treiberversion prüfen
Abfragebefehle:
dmesg | grep -i rknpu
# or
cat /sys/kernel/debug/rknpu/version
# or
cat /sys/kernel/debug/rknpu/driver_version
# or
cat /proc/debug/rknpu/driver_version
Abfrageergebnisse:
RKNPU driver: vX.X.X
X.X.X steht für die Versionsnummer, beispielsweise 0.9.2.
In der Rockchip-Firmware ist der RKNPU-Treiber vorinstalliert. Wenn die obigen Befehle keine NPU-Treiberversion liefern, fehlt der Treiber möglicherweise in der Fremdfirmware. Aktivieren Sie CONFIG_ROCKCHIP_RKNPU=y in der Kernelkonfiguration, kompilieren Sie den Kerneltreiber neu und flashen Sie ihn. Empfohlen wird eine RKNPU-Treiberversion >= 0.9.2.
2.2.2 Verbindungsumgebung des NPU-Geräts prüfen
Für das Debuggen mit angeschlossener Platine benötigt RKNN-Toolkit2 den RKNN Server auf dem Gerät. Dieser Hintergrund-Proxy empfängt Befehle und Daten vom Computer über USB, führt die entsprechenden Schnittstellen aus und sendet Ergebnisse zurück. Prüfen Sie deshalb, ob der RKNN Server auf dem Gerät gestartet wurde.
Hinweis: ARM64 benötigt zum Debuggen keinen RKNN Server. Überspringen Sie diesen Schritt, wenn Sie RKNN Toolkit2 auf ARM64 verwenden.
Prüfen Sie, ob auf der Entwicklungsplatine ein RKNN-Server-Prozess läuft.
adb shell
ps | grep rknn_server
Abfrageergebnisse:
702 root 1192 S grep rknn_server
Wird eine Prozess-ID für RKNN Server angezeigt, läuft der Dienst ordnungsgemäß. Andernfalls starten Sie ihn mit folgendem Befehl manuell und wiederholen die Abfrage.
RKNN Server unter Android manuell starten:
su
setenforce 0
nohup /vendor/bin/rknn_server >/dev/null&
RKNN Server unter Linux auf RK356X/RK3576/RK3588/RV1126B manuell starten:
nohup /usr/bin/rknn_server >/dev/null&
RKNN Server unter Linux auf RV1103/RV1103B/RV1106/RV1106B manuell starten:
nohup /oem/usr/bin/rknn_server >/dev/null&
Normalerweise ist RKNN Server in der Rockchip-Firmware integriert und startet automatisch beim Booten. Erfolgt kein automatischer Start oder fehlen die Dateien für den manuellen Start, installieren oder aktualisieren Sie RKNN Server manuell.
2.2.3 RKNN Server installieren und aktualisieren
Wenn RKNN Server auf der Platine fehlt, die Runtime-Bibliothek nicht vorhanden ist oder deren Versionen nicht übereinstimmen, müssen Sie die Komponenten neu installieren oder aktualisieren. Zwei grundlegende Begriffe:
1. RKNN Server: Ein Hintergrund-Proxy auf der Entwicklungsplatine. Er empfängt Daten vom Computer über USB, führt die entsprechende Schnittstelle der Runtime auf der Platine aus und sendet die Ergebnisse an den PC zurück.
2. RKNPU2-Runtime-Bibliothek
librknnrt.so: Runtime-Bibliothek für RK3562/RK3566/RK3568/RK3576/RK3588/RV1126B-Entwicklungsplatinen.
librknnmrt.so: Runtime-Bibliothek für RV1103/RV1103B/RV1106/RV1106B-Entwicklungsplatinen.
Wenn RKNN Server oder die Runtime-Bibliothek auf der Platine fehlen beziehungsweise deren Versionen nicht übereinstimmen, ist eine Neuinstallation oder Aktualisierung erforderlich.
Hinweis:
1. Für ein RKNN-Modell mit dynamischen Eingabedimensionen müssen RKNN Server und RKNPU2 Runtime Version >= 1.5.0 besitzen.
2. Für Modelle größer als 2 GB ist rknn_server Version >=2.0.0b0 erforderlich.
3. Für Plattformen mit wenig Speicher wie RV1103, RV1106, RV1103B und RV1106B wird rknn_server Version >=2.1.0 empfohlen.
4. Die Versionen von RKNN Server, Runtime-Bibliothek und RKNN-Toolkit2 müssen zueinander passen. Empfohlen wird die jeweils neueste Version aller Komponenten.
5. Der Dienst rknn_server auf RK2118 dient nicht dem Platinen-Debugging mit RKNN-Toolkit2, sondern der Kommunikation zwischen DSP und MCU.
6. Die ARM64-Version benötigt keinen RKNN Server; dessen Aktualisierung und Verwendung entfallen. Die Debugfunktionen hängen jedoch von der RKNPU-Runtime-Bibliothek ab. Stellen Sie sicher, dass deren neueste Version auf der Platine installiert ist.
2.2.3.1 Plattform RK356X/RK3576/RK3588/RV1126B
1. Android-System
Prüfen Sie die Versionen von RKNN Server und librknnrt.so. Bei unterschiedlichen Versionsnummern aktualisieren Sie beide auf dieselbe Version.
# Query rknn_server version
strings /vendor/bin/rknn_server | grep -i "rknn_server version"
# Display rknn_server version is X.X.X, such as 1.6.0
# rknn_server version: X.X.X
# Query the librknnrt.so library version

# 64-bit system
strings /vendor/lib64/librknnrt.so | grep -i "librknnrt version"
# 32-bit system
strings /vendor/lib/librknnrt.so | grep -i "librknnrt version"
# Display the librknnrt library version is X.X.X, such as 1.6.0
# librknnrt version: X.X.X
Aktualisieren Sie RKNN Server und librknnrt.so.
adb root
adb remount
64-Bit-System:
adb push runtime/Android/rknn_server/arm64/rknn_server /vendor/bin/
adb push runtime/Android/librknn_api/arm64-v8a/librknnrt.so /vendor/lib64
32-Bit-System:
adb push runtime/Android/rknn_server/arm/rknn_server /vendor/bin/
adb push runtime/Android/librknn_api/armeabi-v7a/librknnrt.so /vendor/lib
Starten Sie RKNN Server neu:
adb shell
su
chmod +x /vendor/bin/rknn_server
nohup /vendor/bin/rknn_server >/dev/null&
sync
reboot
2. Linux-System
Prüfen Sie die Versionen von RKNN Server und librknnrt.so. Bei unterschiedlichen Versionsnummern aktualisieren Sie beide auf dieselbe Version.
# Check rknn_server version
strings /usr/bin/rknn_server | grep -i "rknn_server version"
# Display rknn_server version is X.X.X, such as 1.6.0
# rknn_server version: X.X.X

# Query the librknnrt.so version
strings /usr/lib/librknnrt.so | grep -i "librknnrt version"
# Display the librknnrt version is X.X.X, such as 1.6.0
# librknnrt version: X.X.X
Aktualisieren Sie RKNN Server und librknnrt.so.
64-Bit-System:
adb push runtime/Linux/rknn_server/aarch64/usr/bin/* /usr/bin
adb push runtime/Linux/librknn_api/aarch64/librknnrt.so /usr/lib64
32-Bit-System:
adb push runtime/Linux/rknn_server/armhf/usr/bin/* /usr/bin
adb push runtime/Linux/librknn_api/armhf/librknnrt.so /usr/lib
Starten Sie RKNN Server neu:
adb shell
chmod +x /usr/bin/rknn_server
nohup /usr/bin/rknn_server >/dev/null&
restart_rknn.sh
2.2.3.2 Plattform RV1103/RV1103B/RV1106/RV1106B
Prüfen Sie die Versionen von rknn_server und librknnmrt.so. Bei unterschiedlichen Versionsnummern aktualisieren Sie beide auf dieselbe Version.
# Query rknn_server version
strings /oem/usr/bin/rknn_server | grep -i "rknn_server version"
# Display rknn_server version is X.X.X, such as 1.6.0
# rknn_server version: X.X.X

# Query the librknnrt.so version
strings /oem/usr/lib/librknnmrt.so | grep -i "librknnmrt version"
# Display the librknnrt version is X.X.X, such as 1.6.0
# librknnmrt version: X.X.X
Aktualisieren Sie RKNN Server und librknnmrt.so. RV1103, RV1103B, RV1106 und RV1106B verwenden denselben RKNN Server und dieselbe librknnmrt.so.
adb push runtime/Linux/rknn_server/armhf-uclibc/usr/bin/* /oem/usr/bin
adb push runtime/Linux/librknn_api/armhf-uclibc/librknnmrt.so /oem/usr/lib
Starten Sie RKNN Server neu:
adb shell
chmod +x /oem/usr/bin/rknn_server
nohup /oem/usr/bin/rknn_server >/dev/null&
restart_rknn.sh
2.2.4 Ausführliche RKNN-Server-Protokolle anzeigen
2.2.4.1 Android-System
Öffnen Sie das Geräteterminal und legen Sie die Protokollstufe fest:
adb shell
su
setenforce 0
setprop persist.vendor.rknn.server.log.level 5
Beenden Sie den aktuellen RKNN-Server-Dienstprozess:
kill -9 `pgrep rknn_server`
Falls RKNN Server nicht automatisch neu startet, starten Sie ihn manuell und zeigen die ausführlichen Protokolle an:
nohup /vendor/bin/rknn_server >/dev/null&
logcat
2.2.4.2 Linux-System
Öffnen Sie das Geräteterminal und legen Sie die Protokollstufe fest:
adb shell
export RKNN_SERVER_LOGLEVEL=5
Starten Sie RKNN Server neu, um ausführliche Protokolle anzuzeigen:
Führen Sie auf der Plattform RK356X / RK3576 / RK3588 / RV1126B folgenden Befehl aus:
nohup /usr/bin/rknn_server >/dev/null&
Führen Sie auf der Plattform RV1103 / RV1103B / RV1106 / RV1106B folgende Befehle aus:
nohup /oem/usr/bin/rknn_server >/dev/null&
3 Grundlegende RKNN-Anleitung
3.1 Modellkonvertierung
RKNN-Toolkit2 bietet Modellkonvertierung, Leistungsanalyse, Bereitstellung, Debugging und weitere Funktionen. Dieser Abschnitt behandelt die Modellkonvertierung als eine der Kernfunktionen: Deep-Learning-Modelle verschiedener Frameworks werden in das auf RKNPU ausführbare RKNN-Format umgewandelt. Das Flussdiagramm erläutert diesen Ablauf.
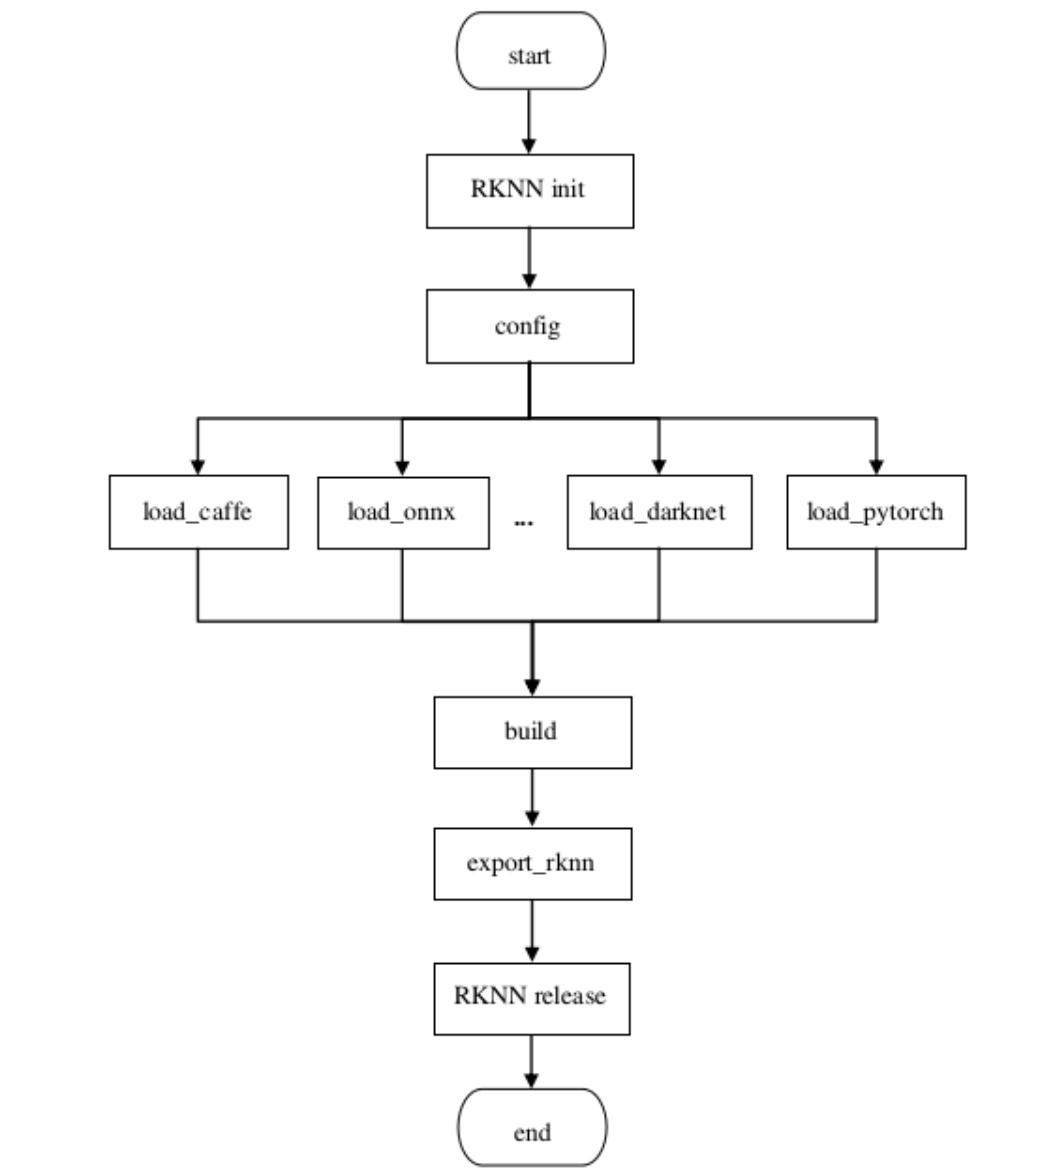
Abbildung 3-1: Ablauf der Modellkonvertierung
RKNN-Toolkit2 unterstützt die Modellkonvertierung für folgende verbreitete Deep-Learning-Frameworks:
Caffe (empfohlene Version 1.0)
TensorFlow (empfohlene Versionen 1.12.0~2.8.0)
TensorFlow Lite (empfohlen: Schema version = 3)
ONNX (empfohlene Versionen 1.7.0~1.10.0)
PyTorch (empfohlene Versionen 1.6.0~1.13.1)
Darknet (empfohlen: Commit ID = 810d7f7)
Trainieren oder beschaffen Sie vortrainierte Modelle dieser Frameworks und konvertieren Sie sie für eine effizientere Bereitstellung und Inferenz auf der RKNPU-Plattform in RKNN.
3.1.1 RKNN initialisieren und das Objekt freigeben
Zunächst muss das RKNN-Objekt initialisiert werden. Dies ist der erste Schritt des gesamten Ablaufs.
RKNN-Objekt initialisieren:
Initialisieren Sie das RKNN-Objekt mit dem Konstruktor RKNN(). Dabei können Sie die Parameter verbose und verbose_file übergeben.
verbose legt fest, ob ausführliche Protokollinformationen auf dem Bildschirm erscheinen.
Wenn verbose_file angegeben und verbose auf True gesetzt ist, werden die Protokollinformationen zusätzlich in die angegebene Datei geschrieben.
Codebeispiel:
rknn = RKNN(verbose=True, verbose_file='./mobilenet_build.log')
Geben Sie nach Abschluss aller RKNN-Vorgänge die Ressourcen frei. Dies ist der letzte Schritt des Ablaufs:
Ressourcen freigeben:
Geben Sie das rknn-Objekt mit release() frei.
Codebeispiel:
rknn.release()
3.1.2 Config-Konfiguration
Vor der Konvertierung sind Einstellungen für die Korrektheit und Leistung der Modellkonvertierung erforderlich. Über rknn.config() lassen sich beispielsweise Eingabemittelwerte, Normalisierung und Quantisierung konfigurieren. Häufig verwendete Parameter:
mean_values und std_values legen Eingabemittelwerte und Normalisierungswerte fest. Sie werden bei der Quantisierung verwendet, sodass beim Inferenzaufruf über die C-API keine erneute Mittelwertsubtraktion und Normalisierung der Bilder nötig ist. Dadurch verkürzt sich die Bereitstellungszeit.
quant_img_RGB2BGR steuert, ob beim Laden eines Quantisierungsbildes zunächst RGB nach BGR konvertiert wird. Der Standardwert ist false. Die Einstellung wirkt während der Quantisierungskalibrierung, nicht während der Modellinferenz; die entsprechende Eingabevorverarbeitung muss der Benutzer selbst durchführen. Ausführliche Hinweise stehen in Abschnitt 10.3. Hinweis: Bei quant_img_RGB2BGR= True erfolgt zuerst RGB2BGR und anschließend die Verarbeitung mit mean_values und std_values.
target_platform legt die Zielplattform des RKNN-Modells fest. Unterstützt werden RV1103, RV1103B, RV1106, RV1106B, RV1126B, RK2118, RK3562, RK3566, RK3568, RK3576 und RK3588.
quantized_algorithm bestimmt den Algorithmus zur Berechnung der Quantisierungsparameter jeder Schicht: normal, mmse oder kl_divergence. Standard ist normal. Einzelheiten stehen in den Abschnitten 3.1.7, 6.1 und 6.2.
quantized_method unterstützt layer oder channel und bestimmt, ob die Gewichte einer Schicht gemeinsame Parameter verwenden. Standard ist channel. Einzelheiten stehen in den Abschnitten 3.1.7, 6.1 und 6.2.
optimization_level ändert die Optimierungsstufe und ermöglicht das Abschalten einiger oder aller Optimierungsregeln bei der Modellkonvertierung. Der Standardwert 3 aktiviert alle Optimierungen. Bei 2 oder 1 werden einige Optionen deaktiviert, die die Genauigkeit bestimmter Modelle beeinflussen können. Bei 0 sind alle Optimierungen deaktiviert.
quantized_dtype legt den Quantisierungstyp fest. Unterstützt wird INT8 mit linearer asymmetrischer Quantisierung; Standard ist ‘asymmetric_quantized-8’.
custom_string fügt dem RKNN-Modell eine benutzerdefinierte Zeichenfolge hinzu, etwa dessen Versionsinformation. Sie lässt sich mit RKNN_QUERY_CUSTOM_STRING abfragen und ermöglicht eine modellspezifische Behandlung bei der Bereitstellung. Standard ist None.
dynamic_input unterstützt dynamische Eingaben, indem die Funktion anhand mehrerer vom Benutzer angegebener Eingabeformen nachgebildet wird. Standard ist None. Einzelheiten stehen in Abschnitt 5.4.
Die vollständige Beschreibung von rknn.config() finden Sie im API-Handbuch; oben sind nur einige häufig verwendete Parameter aufgeführt.
Codebeispiel:
rknn.config(
    mean_values=[[103.94, 116.78, 123.68]],
    std_values=[[58.82, 58.82, 58.82]],
    quant_img_RGB2BGR=False,
    target_platform='rk3566')
3.1.3 Schnittstellen zum Laden von Modellen
Verwenden Sie die zum jeweiligen Modelltyp passende Ladeschnittstelle. RKNN-Toolkit2 bietet unterschiedliche Schnittstellen für Caffe, TensorFlow, TensorFlow Lite, ONNX, PyTorch und weitere Frameworks. Nachfolgend eine kurze Übersicht:
Caffe laden:
Laden Sie das Caffe-Modell mit rknn.load_caffe().
Geben Sie den Pfad zur Modelldatei .prototxt und zur Gewichtsdatei .caffemodel an.
Bei mehreren Eingabeschichten können Sie die Reihenfolge ihrer Namen angeben.
Codebeispiel:
ret = rknn.load_caffe(model='./mobilenet_v2.prototxt', blobs='./mobilenet_v2.caffemodel')
TensorFlow laden:
Laden Sie das TensorFlow-Modell mit rknn.load_tensorflow().
Geben Sie den Pfad zur TensorFlow-Modelldatei .pb, Namen und Form des Eingabeknotens sowie den Namen des Ausgabeknotens an.
Codebeispiel:
ret = rknn.load_tensorflow(tf_pb='./ssd_mobilenet_v1_coco_2017_11_17.pb',
              inputs=['Preprocessor/sub'],
              outputs=['concat', 'concat_1'],
              input_size_list=[[1, 300, 300, 3]])
TensorFlow Lite laden:
Laden Sie das TensorFlow-Lite-Modell mit rknn.load_tflite().
Geben Sie den Pfad zur TensorFlow-Modelldatei mit der Endung .tflite an.
Codebeispiel:
ret = rknn.load_tflite(model='./mobilenet_v1.tflite')
ONNX laden:
Laden Sie das ONNX-Modell mit rknn.load_onnx().
Geben Sie den Pfad zur ONNX-Modelldatei .onnx an.
Codebeispiel:
ret = rknn.load_tflite(model='./mobilenet_v1.tflite')
DarkNet laden:
Laden Sie das DarkNet-Modell mit rknn.load_darknet().
Geben Sie den Pfad zur DarkNet-Modelldatei .cfg und zur Gewichtsdatei .weights an.
Codebeispiel:
ret = rknn.load_darknet(model='./yolov3-tiny.cfg', weight='./yolov3.weights')
PyTorch laden:
Laden Sie das PyTorch-Modell mit rknn.load_pytorch().
Geben Sie den Pfad zur PyTorch-Modelldatei .pt an; das Modell muss im torchscript-Format vorliegen.
Codebeispiel:
ret = rknn.load_pytorch(model='./resnet18.pt', input_size_list=[[1, 3, 224, 224]])
Wählen Sie die zum Modelltyp passende Ladeschnittstelle, damit das Modell konvertiert werden kann.
3.1.4 RKNN-Modell erstellen
Nach dem Laden des Ausgangsmodells erstellen Sie das RKNN-Modell mit rknn.build(). Optional lässt sich quantisieren, um die Modellgröße zu verringern und die RKNPU-Leistung zu verbessern. Parameter von rknn.build():
do_quantization steuert die Modellquantisierung; empfohlen wird True.
dataset gibt den Datensatz für die Quantisierungskalibrierung an. Er wird als Textdatei bereitgestellt.
Beispiel für dataset.txt:
./imgs/ILSVRC2012_val_00000665.JPEG
./imgs/ILSVRC2012_val_00001123.JPEG
./imgs/ILSVRC2012_val_00001129.JPEG
./imgs/ILSVRC2012_val_00001284.JPEG
./imgs/ILSVRC2012_val_00003026.JPEG
./imgs/ILSVRC2012_val_00005276.JPEG
Codebeispiel
ret = rknn.build(do_quantization=True, dataset='./dataset.txt')
3.1.5 RKNN-Modell exportieren
Nach der Erstellung mit rknn.build() können Sie das RKNN-Modell mit rknn.export_rknn() zur Bereitstellung als .rknn-Datei speichern. Parameter dieser Schnittstelle:
export_path ist der Pfad zur exportierten Modelldatei.
cpp_gen_cfg kann optional C++-Bereitstellungsbeispiele erzeugen.
Codebeispiel
ret = rknn.export_rknn(export_path='./mobilenet_v1.rknn')
Diese Vorgänge und Schnittstellen decken die Modellkonvertierung in RKNN-Toolkit2 ab. Je nach Anforderungen und Anwendungsszenario lassen sich Konfiguration und Quantisierungsalgorithmen anpassen, um die spätere Bereitstellung zu erleichtern.
3.1.6 Modellkonvertierungswerkzeug RKNN_Convert
RKNN_CONVERT ist ein Modellkonvertierungswerkzeug von RKNN-Toolkit2, das die oben beschriebenen APIs kapselt. Zur befehlsbasierten Konvertierung genügt es, die yml-Konfigurationsdatei des Modells zu bearbeiten. Nachfolgend ein Aufrufbeispiel für rknn_convert und die unterstützten Parameter:
python -m rknn.api.rknn_convert -t rk3588 -i ./model_config.yml -o ./output_path
Mit diesen Befehlen und Parametern wird das Modell in RKNN konvertiert und im angegebenen Ausgabepfad gespeichert. Unterstützte Befehlsparameter:
-i: Pfad zur Modellkonfigurationsdatei .yml.
-o: Ausgabeverzeichnis des konvertierten Modells.
-t: target_platform; Zielplattform rv1103, rv1103b, rv1106, rv1106b, rv1126b, rk2118, rk3562, rk3566, rk3568, rk3576 oder rk3588.
-e: Optionale Bewertung von Laufzeit und Speicherverbrauch auf der Platine. Zum Aktivieren -e angeben. Die Platine muss angeschlossen und target_platform korrekt gesetzt sein, sonst entsteht ein Fehler. Bei mehreren Geräten wählen Sie die Geräte-ID mit -d device_id.
-a: Optionale Genauigkeitsbewertung des erzeugten rknn-Modells. Für die Simulatorbewertung geben Sie -a “xx1.jpg xx2.jpg” in der Befehlszeile an. Zur Genauigkeitsanalyse zusammen mit -d verwenden.
-v: Optionale Ausgabe ausführlicher Protokollinformationen auf dem Bildschirm; zum Aktivieren -v in der Befehlszeile angeben.
-d: Optionaler Parameter. Für ein einzelnes adb-Gerät -d verwenden, für mehrere -d device_id. device_id lässt sich mit adb devices abfragen.
Beispiel einer yaml-Konfiguration:
models:
  # model output name
  name: object_detection
  # Original model framework
  platform: onnx
  # Model input file path
  model_file_path: ./object_detection.onnx
  # Describe information such as input and output shapes
  subgraphs:
   # model input tensor shape
   input_size_list:
    - 1,3,512,512
   # input tensor name
   inputs:
    - data
   # output tensor name
   outputs:
    - conv6-1
    - conv6-2
    - conv6-3
  # quantification flag
  quantize: true
  # Quantify dataset file path (relative yml path)
  dataset: ./dataset.txt
  configs:
   quantized_dtype: asymmetric_quantized-8
   # rknn.config mean_values
   mean_values: [127.5,127.5,127.5]
   # rknn.config std_values
   std_values: [128.0,128.0,128.0]
   # rknn.config quant_img_RGB2BGR
   quant_img_RGB2BGR: false
   # rknn.config quantized_algorithm
   quantized_algorithm: normal
Die Konfigurationsdatei enthält Modellname, ursprüngliches Framework, Modelldateipfad, Ein- und Ausgabeinformationen sowie die Quantisierungseinstellung. Passen Sie die entsprechenden Dateien an die Anforderungen des Modells an.
Die Beschreibung der yml-Konfiguration folgt unten:
Tabelle 3-1: yml-Parameter der Modellkonvertierungskonfiguration
| Parameter | Einzutragender Inhalt |
|---|---|
| -name | Name der Modellausgabedatei |
| -platform | Framework des ursprünglichen Modells; unterstützt werden tensorflow, tflite, caffe, onnx, pytorch, darknet |
| -model_file_path | Pfad zur ursprünglichen Modelldatei bei Modellen mit nur einer Datei, beispielsweise tensorflow, tflite, onnx, pytorch |
| -quantize | Ob Quantisierung verwendet wird |
| -dataset | Pfad zum Quantisierungsdatensatz (relativer Pfad genügt). Bei aktiviertem accuracy_analysis ist diese Option erforderlich |
| -prototxt_file_path | prototxt-Datei des Modells bei Verwendung von caffe |
| -caffemodel_file_path | caffemodel-Datei des Modells bei Verwendung von caffe |
| -darknet_cfg_path | cfg-Datei des Modells bei Verwendung von darknet |
| -darknet_weights_path | Gewichtsdatei des Modells bei Verwendung von darknet |
| -subgraphs | Beschreibt Ein- und Ausgabeformen sowie weitere Modellinformationen. Dieser Parameter und seine Unterparameter sind normalerweise optional. Außer bei bestimmten Frameworks können die Standardwerte des Modells verwendet werden |
| —-input_size_list (Unterparameter) |
Form des Eingabetensors |
| —-inputs (Unterparameter) |
Name des Eingabetensors |
| —-outputs (Unterparameter) |
Name des Ausgabetensors |
| -configs | Entsprechende Konfiguration von rknn.config() |
| —-quantized_dtype (Unterparameter) |
Quantisierungstyp für RKNN-Toolkit2: [asymmetric_quantized-8] kann eingetragen werden. Ohne Angabe wird der Standardwert verwendet |
| —-mean_values (Unterparameter) |
Mittelwerte der Modelleingaben. Bei einem RGB-Eingang beispielsweise [123.675,116.28,103.53], bei mehreren Eingängen beispielsweise [[123,116,103],[255,255,255]] |
| —-std_values (Unterparameter) |
Standardabweichungen der Modelleingaben. Bei einem RGB-Eingang beispielsweise [58.395,58.295,58.391], bei mehreren Eingängen beispielsweise [[127,127,127], [255,255,255]] |
| —- quant_img_RGB2BGR (Unterparameter) |
Ob beim Laden von Quantisierungsbildern RGB2BGR ausgeführt wird. Standardwert false |
| —-quantized_algorithm (Unterparameter) |
Quantisierungsalgorithmus: [‘normal’, ‘kl_divergence’, ‘mmse’]; Standardwert normal |
| —-quantized_method (Unterparameter) |
Quantisierungsmethode für RKNN_toolkit2: [‘layer’, ‘channel’]; Standardwert channel |
| —-optimization_level (Unterparameter) |
Optimierungsstufe. Standardwert 3 verwendet alle standardmäßigen Optimierungsoptionen |
| —-model_pruning (Unterparameter) |
Modell-Pruning zur Verringerung der Modellgröße. Standardwert false; true aktiviert die Funktion |
| —-quantize_weight (Unterparameter) |
Verringert bei quantize=false die Größe des rknn-Modells durch Quantisierung einiger Gewichte. Standardwert false; true aktiviert die Funktion |
| —-single_core_mode (Unterparameter) |
Ob nur Einkernmodelle erzeugt werden, um Größe und Speicherbedarf von RKNN-Modellen zu verringern. Standardwert false. Derzeit nur für RK3576/RK3588 gültig. Standardwert false. |
3.1.7 Modellquantisierung in RKNN-Toolkit2
RKNN-Toolkit2 bietet zwei Quantisierungsverfahren und drei Quantisierungsalgorithmen. Sie werden über quantized_algorithm und quantized_method in rknn.config() gewählt. Nachfolgend werden die Algorithmen und Verfahren zur Merkmalsquantisierung erläutert:
Drei Quantisierungsalgorithmen:
1. Normal: Maximum und Minimum des Quantisierungsbereichs werden aus den maximalen und minimalen Gleitkommawerten der Modellmerkmale bestimmt. Der Algorithmus ist schnell, liefert bei ungleichmäßiger Merkmalsverteilung jedoch schlechtere Ergebnisse. Empfohlen werden üblicherweise etwa 20–100 Kalibrierungsbeispiele.
2. MMSE: Die Bereichsgrenzen werden durch Minimierung des mittleren quadratischen Fehlers zwischen ursprünglichen Gleitkommazahlen und quantisierten, anschließend dequantisierten Werten ermittelt. Dies mindert teilweise Genauigkeitsverluste durch große Ausreißer. Die iterative Suche ist langsamer, aber meist genauer als normal. Empfohlen werden etwa 20–50 Beispiele; die Anzahl kann abhängig von der Quantisierungsdauer angepasst werden.
3. KL-Divergence: Gleitkomma- und Festkommawerte der Merkmale werden als zwei Verteilungen dargestellt. Durch unterschiedliche Schwellen werden die Verteilungen aktualisiert; ihre Ähnlichkeit wird anhand der KL-Divergenz bewertet, um die Bereichsgrenzen festzulegen. Der Algorithmus ist langsamer als normal, aber deutlich schneller als mmse. In manchen Fällen, etwa bei ungünstiger Merkmalsverteilung, erzielt er bessere Ergebnisse. Empfohlen werden üblicherweise etwa 20–100 Bilder.
Zwei Quantisierungsverfahren:
1. Layer: Alle Kanäle derselben Netzwerkschicht werden gemeinsam quantisiert und verwenden dieselben Quantisierungsparameter.
2. Channel: Jeder Kanal derselben Netzwerkschicht wird unabhängig mit eigenen Parametern quantisiert. Die Genauigkeit ist meist höher als bei Layer.
Wählen Sie Algorithmus und Merkmalsquantisierungsverfahren anhand der tatsächlichen Ergebnisse und Modellanforderungen. Ausführliche Anleitungen und Grundlagen stehen in Kapitel 6.
3.2 Modellbewertung
3.2.1 Modellinferenz
Nach der Konvertierung in RKNN lässt sich die Inferenz im Simulator oder auf der Platine ausführen. Verarbeiten Sie die Ergebnisse nach, um ihre Korrektheit zu prüfen. Bei falschen Ergebnissen verwenden Sie die Genauigkeitsanalyse des quantisierten Modells und überprüfen Vor- und Nachverarbeitung.
Initialisierungsparameter von rknn.init_runtime():
target: Zielhardwareplattform. Standard ist None; die Inferenz läuft dann im Simulator. Für tatsächliche Ergebnisse auf der Platine geben Sie die entsprechende Plattform an: RV1103 / RV1103B / RV1106 / RV1106B / RV1126B / RK3562 / RK3566 / RK3568 / RK3576 / RK3588.
device_id: Gerätekennung. Standard ist None. Ist target gesetzt, wird ein einzelnes Gerät für die Inferenz gewählt. Bei mehreren angeschlossenen Platinen muss die entsprechende Geräte-ID angegeben werden. Für Inferenz über Netzwerk-ADB führen Sie zunächst manuell adb connect [IP] aus und geben anschließend die Gerätekennung an, üblicherweise eine IP-Adresse oder eine IP-Adresse mit Portnummer. adb devices listet alle angeschlossenen Geräte auf.
perf_debug: Aktiviert den Debugmodus bei der Leistungsbewertung. Standard ist False; rknn.eval_perf() liefert die Gesamtlaufzeit des Modells. Bei True wird zusätzlich die Laufzeit jeder Schicht ausgegeben. RV1103, RV1103B, RV1106 und RV1106B unterstützen dies nicht.
eval_mem: Aktiviert den Speicherbewertungsmodus. Standard ist false. Nach dem Setzen auf True kann rknn.eval_memory() den Speicherverbrauch während der Modellausführung ermitteln.
Parameter von rknn.inference():
inputs: Liste der Inferenzeingaben im ndarray-Format.
data_format: Liste der Eingabedatenlayouts, nur für vierdimensionale Eingaben gültig. Zulässig sind NCHW und NHWC. Standard ist None, also NHWC für alle Eingaben.
Codebeispiel:
ret = rknn.init_runtime(target=platform, device_id='515e9b401c060c0b')

# Preprocess
image_src = cv2.imread(IMG_PATH)
img = preprocess(image_src)

# Inference
outputs = rknn.inference(inputs=[img])

# Postprocess
outputs = postprocess(outputs)
Hinweis:
1. Tritt bei der Inferenz auf RV1103 oder RV1106 der Fehler „E RKNN: failed to allocate fd, ret: -1, errno: 12“ auf, führen Sie im Platinenterminal RkLunch-stop.sh aus, um andere speicherbelegende Anwendungen zu schließen.
2. In der ARM64-Version unterstützt rknn.init_runtime() device_id nicht.
3.2.2 Analyse der Modellgenauigkeit
Bei Problemen mit den Inferenzergebnissen eines quantisierten Modells können Sie mit rknn.accuracy_analysis() die Genauigkeit analysieren und jede Operatorschicht prüfen.
Parameter der Genauigkeitsanalyse rknn.accuracy_analysis():
inputs: Liste der Eingabedateipfade in den Formaten jpg, png, bmp oder npy.
output_dir: Speicherverzeichnis, standardmäßig ‘./snapshot’.
Target: Zielhardwareplattform, standardmäßig None. Ist target auf RV1103 / RV1103B / RV1106 / RV1106B / RV1126B / RK3562 / RK3566 / RK3568 / RK3576 / RK3588 gesetzt, werden die Laufzeitergebnisse jeder Schicht für die Genauigkeitsanalyse ermittelt.
device_id: Geräte-ID. Standard ist None; die Analyse erfolgt nur im Simulator. Bei gesetztem target wird ein Gerät gewählt. Sind mehrere Geräte angeschlossen, geben Sie die entsprechende ID an. Für die Analyse über Netzwerk-ADB verbinden Sie sich manuell mit adb connect [IP] und geben anschließend die Gerätekennung an, üblicherweise eine IP-Adresse oder eine IP-Adresse mit Portnummer.
Hinweis:
1. Die Genauigkeitsanalyse kann fehlschlagen, wenn das Modell zu groß und der Speicherplatz auf der Platine unzureichend ist. Prüfen Sie ihn mit df -h im Platinenterminal. Entfernen Sie bei Platzmangel unnötige Dateien, damit die Partition von output_dir genügend Platz für Ergebnisdateien bietet.
2. Nach dem Laden mit rknn.load_rknn() ist die Genauigkeitsanalyse nicht verfügbar, da dem RKNN-Modell die Informationen des Ausgangsmodells fehlen.
3. In der ARM64-Version unterstützt rknn.accuracy_analysis() device_id nicht.
Codebeispiel:
ret = rknn.accuracy_analysis(inputs=[img_path], target=platform, device_id='515e9b401c060c0b')
Ergebnisse der Genauigkeitsanalyse:
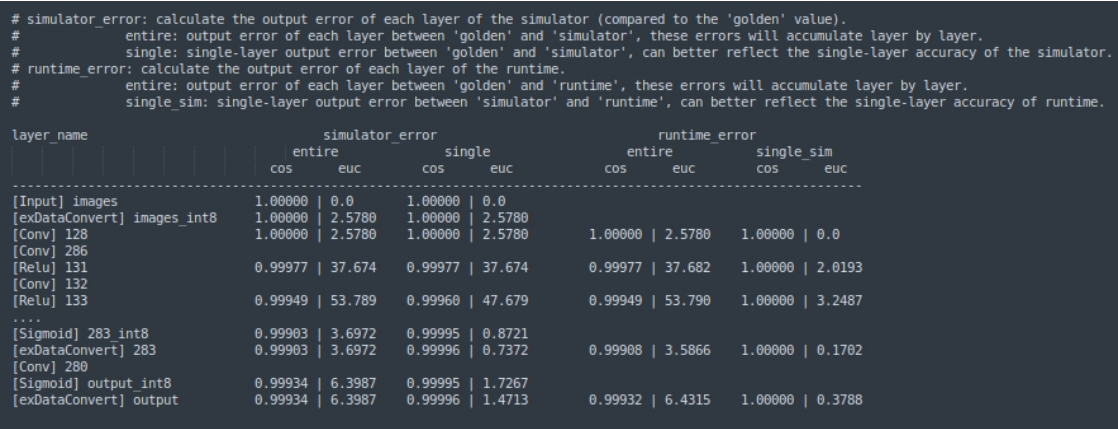
# simulator_error: calculate the output error of each layer of the simulator (compared to the 'golden' value).
# entire: output error of each layer between 'golden' and 'simulator', these errors will accumulate layer by layer.
# single: single-layer output error between 'golden' and 'simulator', can better reflect the single-layer accuracy of the simulator.
# runtime_error: calculate the output error of each layer of the runtime.
# entire: output error of each layer between 'golden' and 'runtime', these errors will accumulate layer by layer.
# single_sim: single-layer output error between 'simulator' and 'runtime', can better reflect the single-layer accuracy of runtime.
| layer_name | simulator_error entire cos | simulator_error entire euc | simulator_error single cos | simulator_error single euc | runtime_error entire cos | runtime_error entire euc | runtime_error single_sim cos | runtime_error single_sim euc |
|---|---|---|---|---|---|---|---|---|
| [Input] images | 1.00000 | 0.0 | 1.00000 | 0.0 | ||||
| [exDataConvert] images_int8 | 1.00000 | 2.5780 | 1.00000 | 2.5780 | ||||
| [Conv] 128 | 1.00000 | 2.5780 | 1.00000 | 2.5780 | 1.00000 | 2.5780 | 1.00000 | 0.0 |
| [Conv] 286 | ||||||||
| [Relu] 131 | 0.99977 | 37.674 | 0.99977 | 37.674 | 0.99977 | 37.682 | 1.00000 | 2.0193 |
| [Conv] 132 | ||||||||
| [Relu] 133 | 0.99949 | 53.789 | 0.99960 | 47.679 | 0.99949 | 53.790 | 1.00000 | 3.2487 |
| … | ||||||||
| [Sigmoid] 283_int8 | 0.99903 | 3.6972 | 0.99995 | 0.8721 | ||||
| [exDataConvert] 283 | 0.99903 | 3.6972 | 0.99996 | 0.7372 | 0.99908 | 3.5866 | 1.00000 | 0.1702 |
| [Conv] 280 | ||||||||
| [Sigmoid] output_int8 | 0.99934 | 6.3987 | 0.99995 | 1.7267 | ||||
| [exDataConvert] output | 0.99934 | 6.3987 | 0.99996 | 1.4713 | 0.99932 | 6.4315 | 1.00000 | 0.3788 |
Abbildung 3-2: Ergebnisse der Genauigkeitsanalyse
Die Genauigkeitsergebnisse sind in vier Spalten unterteilt:
| simulator_error | entire | Kosinus- und euklidischer Abstand zwischen dem Simulatorergebnis vom Anfang bis zur aktuellen Schicht und dem Referenzergebnis. |
| single | Bei Verwendung der Referenzeingabe der aktuellen Schicht werden Kosinus- und euklidischer Abstand zwischen Simulator- und Referenzergebnis verglichen. | |
| runtime_error | entire | Kosinus- und euklidischer Abstand zwischen tatsächlichem Ergebnis und Referenzergebnis vom Anfang bis zum Ende der aktuellen Schicht. |
| single_sim | Bei Verwendung der Referenzeingabe der aktuellen Schicht werden Kosinus- und euklidischer Abstand zwischen dem tatsächlichen Schichtergebnis auf der Platine und dem Simulatorergebnis verglichen. |
3.2.3 Bewertung der Modellleistung
rknn.eval_perf() gibt die aktuellen Hardwarefrequenzen und die Ergebnisse der Modellleistungsbewertung aus. fix_freq bestimmt, ob versucht werden soll, die CPU-/NPU-/DDR-Frequenzen zu fixieren. Zum Fixieren True setzen, andernfalls False; Standard ist True. Wenn perf_debug bei rknn.init_runtime() auf True gesetzt wurde, werden die Laufzeiten jeder Schicht und die Gesamtlaufzeit ausgegeben; bei False nur die Gesamtlaufzeit.
Hinweis:
1. RV1103, RV1103B, RV1106 und RV1106B unterstützen perf_debug=True nicht und können nur die Gesamtlaufzeit des Modells ausgeben.
Codebeispiel:
ret = rknn.init_runtime(target=platform, perf_debug=True)
perf_detail = rknn.eval_perf()
Nachfolgend ein Beispiel der Frequenzausgabe nach eval_perf auf RK3588; die unterstützten Frequenzen können je nach Firmware variieren. Wegen der großen und kleinen CPU-Kerne des RK3588 enthält die CPU-Spalte mehrere Frequenzwerte in KHz. NPU- und DDR-Frequenzen werden in Hz angegeben.
CPU Current Frequency List:
  - 1800000
  - 2256000
  - 2304000
NPU Current Frequency List:
  - 1000000000
DDR Current Frequency List:
  - 2112000000
Ergebnis der Leistungsbewertung:
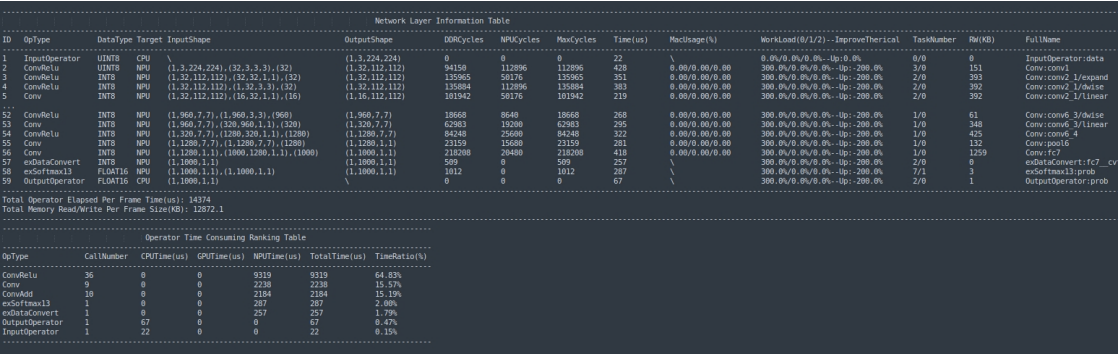
Network Layer Information Table
ID | OpType | DataType | Target | InputShape | OutputShape | DDRCycles | NPUCycles | MaxCycles | Time(us) | MacUsage(%) | WorkLoad(0/1/2)--ImproveTherical | TaskNumber | RW(KB) | FullName
1 | InputOperator | UINT8 | CPU | \ | (1,3,224,224) | 0 | 0 | 0 | 22 | \ | 0.0%/0.0%/0.0%--Up:0.0% | 0/0 | 0 | InputOperator:data
2 | ConvRelu | UINT8 | NPU | (1,3,224,224),(32,3,3,3),(32) | (1,32,112,112) | 94150 | 112896 | 112896 | 428 | 0.00/0.00/0.00 | 300.0%/0.0%/0.0%--Up:-200.0% | 3/0 | 151 | Conv:conv1
3 | ConvRelu | INT8 | NPU | (1,32,112,112),(32,32,1,1),(32) | (1,32,112,112) | 135965 | 50176 | 135965 | 351 | 0.00/0.00/0.00 | 300.0%/0.0%/0.0%--Up:-200.0% | 2/0 | 393 | Conv:conv2_1/expand
4 | ConvRelu | INT8 | NPU | (1,32,112,112),(1,32,3,3),(32) | (1,32,112,112) | 135884 | 112896 | 135884 | 383 | 0.00/0.00/0.00 | 300.0%/0.0%/0.0%--Up:-200.0% | 2/0 | 392 | Conv:conv2_1/dwise
5 | Conv | INT8 | NPU | (1,32,112,112),(16,32,1,1),(16) | (1,16,112,112) | 101942 | 50176 | 101942 | 219 | 0.00/0.00/0.00 | 300.0%/0.0%/0.0%--Up:-200.0% | 2/0 | 392 | Conv:conv2_1/linear
...
52 | ConvRelu | INT8 | NPU | (1,960,7,7),(1,960,3,3),(960) | (1,960,7,7) | 18668 | 8640 | 18668 | 268 | 0.00/0.00/0.00 | 300.0%/0.0%/0.0%--Up:-200.0% | 1/0 | 61 | Conv:conv6_3/dwise
53 | Conv | INT8 | NPU | (1,960,7,7),(320,960,1,1),(320) | (1,320,7,7) | 62983 | 19200 | 62983 | 295 | 0.00/0.00/0.00 | 300.0%/0.0%/0.0%--Up:-200.0% | 1/0 | 348 | Conv:conv6_3/linear
54 | ConvRelu | INT8 | NPU | (1,320,7,7),(1280,320,1,1),(1280) | (1,1280,7,7) | 84248 | 25600 | 84248 | 322 | 0.00/0.00/0.00 | 300.0%/0.0%/0.0%--Up:-200.0% | 1/0 | 425 | Conv:conv6_4
55 | Conv | INT8 | NPU | (1,1280,7,7),(1,1280,7,7),(1280) | (1,1280,1,1) | 23159 | 15680 | 23159 | 281 | 0.00/0.00/0.00 | 300.0%/0.0%/0.0%--Up:-200.0% | 1/0 | 132 | Conv:pool6
56 | Conv | INT8 | NPU | (1,1280,1,1),(1000,1280,1,1),(1000) | (1,1000,1,1) | 218208 | 20480 | 218208 | 418 | 0.00/0.00/0.00 | 300.0%/0.0%/0.0%--Up:-200.0% | 1/0 | 1259 | Conv:fc7
57 | exDataConvert | INT8 | NPU | (1,1000,1,1) | (1,1000,1,1) | 509 | 0 | 509 | 257 | \ | 300.0%/0.0%/0.0%--Up:-200.0% | 2/0 | 0 | exDataConvert:fc7__cv
58 | exSoftmax13 | FLOAT16 | NPU | (1,1000,1,1),(1,1000,1,1) | (1,1000,1,1) | 1012 | 0 | 1012 | 287 | \ | 300.0%/0.0%/0.0%--Up:-200.0% | 7/1 | 3 | exSoftmax13:prob
59 | OutputOperator | FLOAT16 | CPU | (1,1000,1,1) | \ | 0 | 0 | 0 | 67 | \ | 300.0%/0.0%/0.0%--Up:-200.0% | 2/0 | 1 | OutputOperator:prob

Total Operator Elapsed Per Frame Time(us): 14374
Total Memory Read/Write Per Frame Size(KB): 12872.1

Operator Time Consuming Ranking Table
OpType | CallNumber | CPUTime(us) | GPUTime(us) | NPUTime(us) | TotalTime(us) | TimeRatio(%)
ConvRelu | 36 | 0 | 0 | 9319 | 9319 | 64.83%
Conv | 9 | 0 | 0 | 2238 | 2238 | 15.57%
ConvAdd | 10 | 0 | 0 | 2184 | 2184 | 15.19%
exSoftmax13 | 1 | 0 | 0 | 287 | 287 | 2.00%
exDataConvert | 1 | 0 | 0 | 257 | 257 | 1.79%
OutputOperator | 1 | 67 | 0 | 0 | 67 | 0.47%
InputOperator | 1 | 22 | 0 | 0 | 22 | 0.15%
Abbildung 3-3: Ergebnisse der Leistungsbewertung
Beschreibung einiger Parameter:
| Parameter | Beschreibung |
|---|---|
| ID | ID jedes Operators |
| OpType | Typ jedes Operators |
| DataType | Eingabedatentyp |
| Target | Hardware zur Ausführung des Operators (CPU/NPU/GPU) |
| InputShape | Eingabeform |
| OutputShape | Ausgabeform |
| DDRCycles | Taktzyklen für DDR-Lese- und Schreibzugriffe |
| NPUCycles | Anzahl der NPU-Taktzyklen |
| MaxCycles | Maximum von DDR Cycles und NPU Cycles |
| Time(us) | Berechnungszeit des Operators (us) |
| MacUsage(%) | MAC-Auslastung |
| WorkLoad(0/1/2) | Auslastung der Kerne 0/1/2 (nur RK3588) |
| WorkLoad(0/1/2) | Auslastung der Kerne 0/1 (nur RK3576) |
| RW(KB) | Gesamte gelesene und geschriebene Datenmenge (KB) |
| FullName | Vollständiger Operatorname |
| Total Operator Elapsed Per Frame Time(us) |
Gesamtzeit der Modellinferenz für ein Einzelbild |
| Total Memory Read/Write Per Frame Size(KB) |
Gesamter Speicherbandbreitenverbrauch für die Inferenz eines Einzelbilds |
| CallNumber | Anzahl der Operatorausführungen pro Einzelbild |
| CPUTime(us) | Gesamtzeit dieses Operators auf der CPU pro Einzelbild |
| GPUTime(us) | Gesamtzeit dieses Operators auf der GPU pro Einzelbild |
| NPUTime(us) | Gesamtzeit dieses Operators auf der NPU pro Einzelbild |
| TotalTime(us) | Gesamtzeit dieses Operators pro Einzelbild |
| TimeRatio(%) | Verhältnis der Gesamtzeit dieses Operators pro Einzelbild zur gesamten Verarbeitungszeit eines Einzelbilds |
3.2.4 Bewertung des Modellspeicherverbrauchs
rknn.eval_memory() bewertet den Speicherverbrauch des Modells. Ist eval_mem in rknn.init_runtime() auf True gesetzt, wird zusätzlich der Speicherverbrauch der einzelnen Bestandteile ausgegeben.
Codebeispiel:
ret = rknn.init_runtime(target=platform, eval_mem=True)
memory_detail = rknn.eval_memory()
Ergebnis der Speicherbewertung:
======================================================
      Memory Profile Info Dump
======================================================
NPU model memory detail(bytes):
  Weight Memory: 8.67 MiB
  Internal Tensor Memory: 7.42 MiB
  Other Memory: 3.03 MiB
  Total Memory: 19.12 MiB

INFO: When evaluating memory usage, we need consider
the size of model, current model size is: 11.86 MiB
======================================================
Beschreibung einiger Parameter:
| Total Weight Memory | Speicherbedarf der Modellgewichte (MB) |
|---|---|
| Total Internal Tensor Memory |
Tensor-Speicherbedarf der Modellmerkmale (MB) |
| Other Memory | Sonstiger Speicher, beispielsweise Registerkonfiguration und Ein-/Ausgabetensoren (MB) |
| Total Memory | Gesamter Speicherbedarf des Modells (MB) |
3.3 Inferenz auf der Platine mit dem C-Demo
Dieses Kapitel beschreibt die Aufrufreihenfolge der allgemeinen API. Den Zero-Copy-Ablauf finden Sie in Abschnitt 5.2. Aufrufreihenfolge der allgemeinen RKNN-API:
1. rknn_init() initialisiert das Modell;
2. rknn_query() fragt die Ein- und Ausgabeattribute des Modells ab;
3. Eingabe vorverarbeiten;
4. rknn_inputs_set() konfiguriert die Eingabedaten;
5. rknn_run() führt die Modellinferenz aus;
6. rknn_outputs_get() ruft die Ausgabedaten ab;
7. Ausgabe nachverarbeiten;
8. rknn_outputs_release() gibt den Ausgabespeicher frei;
9. rknn_destroy() gibt die RKNN-Ressourcen frei.
Abbildung 3-4 zeigt den Ablauf. Die gelb beschrifteten Schritte kennzeichnen Benutzeraktionen für die zyklische Dateneingabe.
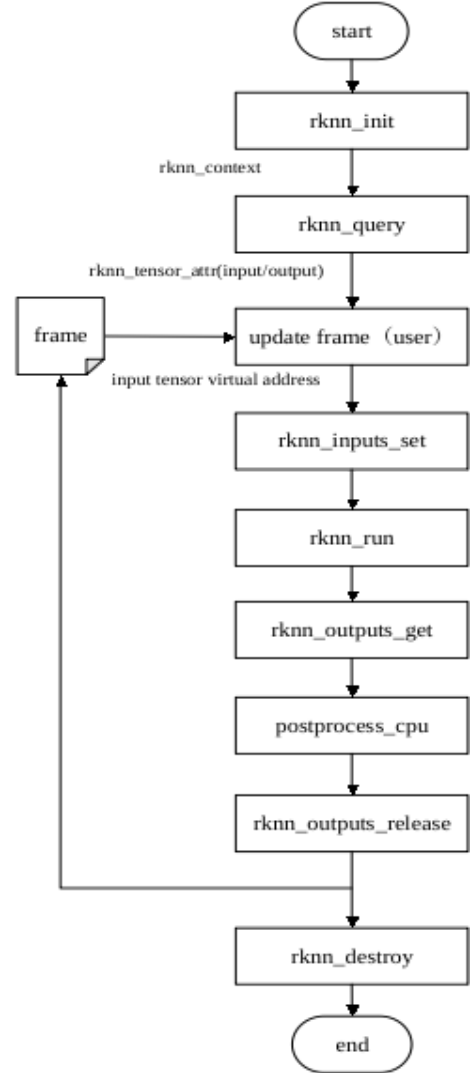
Abbildung 3-4: Ablauf der allgemeinen API
Codebeispiel für die allgemeine API:
// Init RKNN model
ret = rknn_init(&ctx, model, model_len, 0, NULL);

// Get Model Input Output Number
rknn_input_output_num io_num;
ret = rknn_query(ctx, RKNN_QUERY_IN_OUT_NUM, &io_num, sizeof(io_num));

// Get Model Input Info
rknn_tensor_attr input_attrs[io_num.n_input];
memset(input_attrs, 0, sizeof(input_attrs));
for (int i = 0; i < io_num.n_input; i++)
{
  input_attrs[i].index = i;
  ret = rknn_query(ctx, RKNN_QUERY_INPUT_ATTR, &(input_attrs[i]), sizeof(rknn_tensor_attr));
}

// Get Model Output Info
rknn_tensor_attr output_attrs[io_num.n_output];
memset(output_attrs, 0, sizeof(output_attrs));
for (int i = 0; i < io_num.n_output; i++)
{
  output_attrs[i].index = i;
  ret = rknn_query(ctx, RKNN_QUERY_OUTPUT_ATTR, &(output_attrs[i]), sizeof(rknn_tensor_attr));
}

rknn_input inputs[io_num.n_input];
rknn_output outputs[io_num.n_output];
memset(inputs, 0, sizeof(inputs));
memset(outputs, 0, sizeof(outputs));

// Pre-process
// Read Image
image_buffer_t src_image;
memset(&src_image, 0, sizeof(image_buffer_t));
ret = read_image(image_path, &src_image);

// Set Input Data
inputs[0].index = 0;
inputs[0].type = RKNN_TENSOR_UINT8;
inputs[0].fmt = RKNN_TENSOR_NHWC;
inputs[0].size = src_image.size;
inputs[0].buf = src_image.virt_addr;

ret = rknn_inputs_set(rknn_ctx, io_num.n_input, inputs);

// Run
ret = rknn_run(rknn_ctx, nullptr);

// Get Output Data
ret = rknn_outputs_get(rknn_ctx, io_num.n_output, outputs, NULL);

// Post-process
post_process(outputs, results);

// Release RKNN Output
rknn_outputs_release(rknn_ctx, io_num.n_output, outputs);

if (rknn_ctx != 0)
{
  rknn_destroy(rknn_ctx);
}
3.4 Python-Inferenz auf der Platine
RKNN-Toolkit Lite2 stellt eine Python-Schnittstelle für die Modellinferenz auf der Platine bereit und erleichtert die Entwicklung von KI-Anwendungen mit Python.
Hinweis: Konvertieren Sie vor der Entwicklung mit RKNN-Toolkit Lite2 die aus den Deep-Learning-Frameworks exportierten Modelle mit RKNN-Toolkit2 in RKNN. Einzelheiten stehen in Abschnitt 3.1.
3.4.1 Anforderungen an die Systemumgebung
Für RKNN-Toolkit Lite2 ist folgende Umgebung erforderlich:
Tabelle 3-2: RKNN-Toolkit-Lite2-Laufzeitumgebung
| OS | Debian 10 / 11 (aarch64) |
|---|---|
| Python-Version | 3.7 / 3.8 / 3.9 / 3.10 / 3.11 |
| Python-Abhängigkeiten | ‘numpy’ ‘ruamel.yaml’ ‘psutils’ |
3.4.2 Werkzeuge installieren
Installieren Sie RKNN-Toolkit Lite2 mit pip3 install. Installationsschritte:
Falls python3/pip3 und weitere Programme fehlen, installieren Sie diese zunächst mit apt-get, beispielsweise:
sudo apt-get update
sudo apt-get install -y python3 python3-dev python3-pip gcc
Hinweis: Manche Abhängigkeiten müssen aus Quellcode kompiliert werden und benötigen python3-dev und gcc. Beide Pakete werden daher bereits hier installiert, um spätere Kompilierungsfehler zu vermeiden.
Installieren Sie die Abhängigkeiten opencv-python und numpy, beispielsweise:
sudo apt-get install -y python3-opencv
sudo apt-get install -y python3-numpy
Hinweis:
1. RKNN-Toolkit Lite2 selbst benötigt opencv-python nicht; das Beispiel verwendet dieses Modul jedoch zur Bildverarbeitung.
2. Die Installation von numpy über pip3 kann unter Debian10-Firmware fehlschlagen. Empfohlen wird das oben gezeigte Verfahren.
RKNN-Toolkit Lite2 installieren
Die plattformspezifischen Pakete liegen im SDK-Verzeichnis rknn-toolkit-lite2/packages. Wechseln Sie in packages und führen Sie folgenden Installationsbefehl aus:
# Python 3.7
pip3 install rknn_toolkit_lite2-x.y.z-cp37-cp37m-linux_aarch64.whl
# Python 3.8
pip3 install rknn_toolkit_lite2-x.y.z-cp38-cp38-linux_aarch64.whl
# Python 3.9
pip3 install rknn_toolkit_lite2-x.y.z-cp39-cp39-linux_aarch64.whl
# Python 3.10
pip3 install rknn_toolkit_lite2-x.y.z-cp310-cp310-linux_aarch64.whl
# Python 3.11
pip3 install rknn_toolkit_lite2-x.y.z-cp311-cp311-linux_aarch64.whl
3.4.3 Grundlegender Ablauf von RKNN-Toolkit Lite2
Der grundlegende Ablauf zur Bereitstellung eines RKNN-Modells mit RKNN-Toolkit Lite2 ist nachfolgend dargestellt:
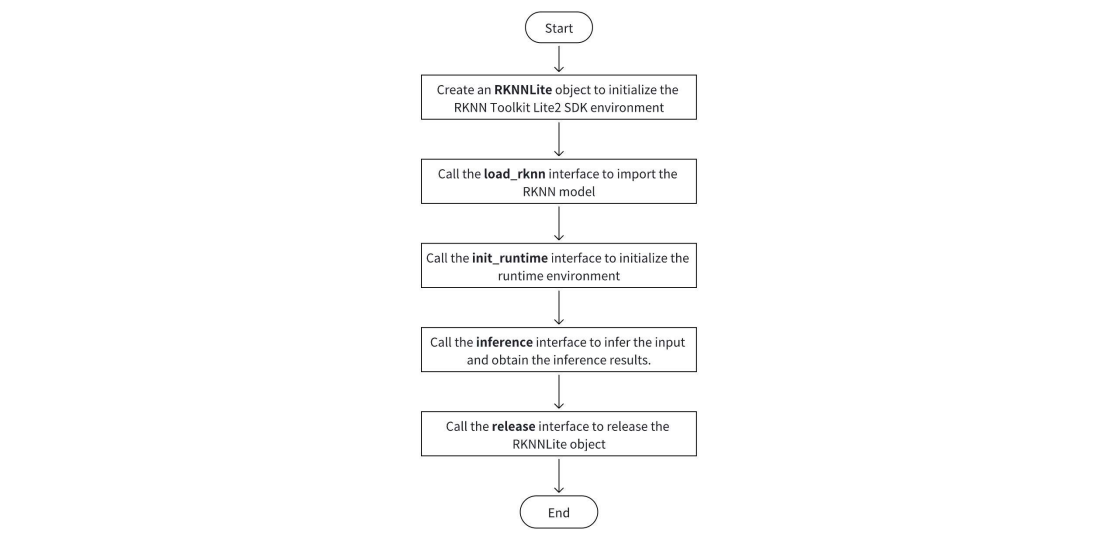
Abbildung 3-5: Ablauf von RKNN-Toolkit Lite2
Hinweis:
1. Laden Sie vor dem Aufruf von inference die Eingabedaten, verarbeiten Sie diese vor und setzen Sie die Schnittstellenparameter entsprechend den Eingabeinformationen.
2. Nach dem Aufruf von inference müssen die Ergebnisse normalerweise nachverarbeitet werden, um die Funktionen der übergeordneten Anwendung umzusetzen.
3.4.4 Ausführungsbeispiel für RKNN-Toolkit Lite2
Unter SDK/rknn-toolkit-lite2/examples befindet sich eine Bildklassifikationsanwendung auf Basis von RKNN-Toolkit Lite2. Sie lädt über dessen Schnittstellen das Resnet18-RKNN-Modell, klassifiziert das Eingabebild und gibt die fünf besten Ergebnisse (top5) aus.
Schritte zum Ausführen des Demos:
1. Eine Entwicklungsplatine mit installiertem RKNN-Toolkit Lite2 vorbereiten;
2. SDK/rknn-toolkit-lite2/examples auf die Platine übertragen;
3. In examples/resent18 wechseln und das Demo mit folgenden Befehlen ausführen;
python test.py
Das Ergebnis ist nachfolgend dargestellt:
model: resnet18
-----TOP 5-----
[812]: 0.999676 [class: space shuttle]
[404]: 0.000249 [class: airliner]
[657]: 0.000014 [class: missile]
[833]: 0.000009 [class: bullet train, bullet | submarine, pigboat, sub, U-boat]
[466]: 0.000009 [class: bullet train, bullet | submarine, pigboat, sub, U-boat]
3.4.5 Ausführliche Beschreibung der RKNN-Toolkit-Lite2-API
Dieses Kapitel beschreibt ausführlich die Verwendung aller von RKNN-Toolkit Lite2 bereitgestellten APIs.
3.4.5.1 RKNNLite initialisieren und freigeben
Rufen Sie bei der Verwendung von RKNN-Toolkit Lite2 RKNNLite() auf, um ein RKNNLite-Objekt zu initialisieren. Nach der Verwendung gibt dessen Methode rknn_lite.release() die Ressourcen frei.
Bei der Initialisierung von RKNNLite können verbose und verbose_file für ausführliche Protokollierung gesetzt werden. verbose steuert die Bildschirmausgabe. Ist verbose_file angegeben und verbose true, wird das Protokoll zusätzlich in die angegebene Datei geschrieben.
Codebeispiel:
# Output detailed log information to the screen and write it to the inference.log file
rknn_lite = RKNNLite(verbose=True, verbose_file='./inference.log')
# Only print detailed log information on the screen
rknn_lite = RKNNLite(verbose=True)
…
rknn_lite.release()
3.4.5.2 RKNN-Modell laden
| API | load_rknn |
|---|---|
| Beschreibung | RKNN-Modell laden |
| Parameter | Pfad zum RKNN-Modell |
| Rückgabewert | 0: erfolgreich -1: fehlgeschlagen |
Codebeispiel:
# Load the resnet18.rknn model from the current directory
ret = rknn_lite.load_rknn('./resnet_18.rknn')
3.4.5.3 init_runtime initialisieren
init_runtime muss vor der Modellinferenz aufgerufen werden.
| API | init_runtime |
|---|---|
| Beschreibung | Laufzeitumgebung initialisieren |
| Parameter | core_mask: Konfiguration der NPU-Kerne. Optionen: - RKNNLite.NPU_CORE_AUTO: automatische Auswahl eines freien NPU-Kerns - RKNNLite.NPU_CORE_0: Ausführung auf NPU0 - RKNNLite.NPU_CORE_1: Ausführung auf NPU1 - RKNNLite.NPU_CORE_2: Ausführung auf NPU2 - RKNNLite.NPU_CORE_0_1: Ausführung auf NPU0 und NPU1 gleichzeitig - RKNNLite.NPU_CORE_0_1_2: Ausführung auf NPU0, NPU1 und NPU2 gleichzeitig - RKNNLite.NPU_CORE_ALL: Ausführung auf allen NPU-Kernen Standardwert NPU_CORE_AUTO — automatische Zuteilung. Hinweis: Dieser Parameter gilt nur für RK3576/RK3588. |
| Rückgabewert | 0: erfolgreich -1: fehlgeschlagen |
Codebeispiel:
# to initialize the init_runtime
ret = rknn_lite.init_runtime(core_mask=RKNNLite.NPU_CORE_AUTO)
if ret != 0:
  print('Init runtime environment failed')
  exit(ret)
3.4.5.4 Modellinferenz
| API | inference |
|---|---|
| Beschreibung | Inferenz für die angegebene Eingabe ausführen und Ergebnis zurückgeben |
| Parameter | inputs: Eingabedaten, beispielsweise mit OpenCV eingelesene Bilder (bei vierdimensionaler Eingabe muss manuell auf 4 Dimensionen erweitert werden). Typ list, Listenelemente vom Typ ndarray. |
| data_format: Datenformat vom Typ list; je Eingang sind “nhwc” und “nchw” zulässig, nur für vierdimensionale Eingaben wirksam. Standardwert None. Ohne Angabe muss der Puffer bei vierdimensionaler Eingabe nach NHWC, sonst nach dem vom Modelleingang verlangten Format angeordnet sein. Bei Angabe muss eine nicht vierdimensionale Eingabe weiterhin dem Modellformat entsprechen, unabhängig von “nhwc” oder “nchw”; eine vierdimensionale Eingabe muss dem angegebenen Format entsprechen. Bei Modellen mit mehreren Eingängen müssen alle Eingänge angegeben werden. | |
| Rückgabewert | results: Inferenzergebnisse vom Typ Python list, Elemente vom Typ ndarray |
Nachfolgend ein Codebeispiel für die Modellinferenz anhand einer Klassifikationsaufgabe:
# Get input data
img = cv2.imread('./space_shuttle_224.jpg')
img = cv2.cvtColor(img, cv2.COLOR_BGR2RGB)
img = np.expand_dims(img, 0)

# Inference
outputs = rknn_lite.inference(inputs=[img])

# Show the classification results
show_top5(outputs)
3.4.5.5 SDK-Version abfragen
| API | get_sdk_version |
|---|---|
| Beschreibung | Versionsinformationen von Laufzeit, Treiber und RKNN-Modell abrufen. Hinweis: Vor dem Aufruf müssen Modellladen und Initialisierung der Laufzeitumgebung abgeschlossen sein. |
| Parameter | None |
| Rückgabewert | sdk_version: Versionsinformationen von Laufzeit, Treiber und RKNN-Modellen als Python string |
Codebeispiel:
# Get SDK version information
……
sdk_version = rknn_lite.get_sdk_version()
……
Zurückgegebene Informationen:
==============================================
RKNN VERSION:
 API: 1.5.2 (71720f3fc@2023-08-21T09:29:52)
 DRV: 0.7.2
==============================================
3.4.5.6 Verfügbare Plattformen zur Modellausführung abfragen
| API | list_support_target_platform |
|---|---|
| Beschreibung | Chipplattformen abfragen, auf denen das angegebene RKNN-Modell ausgeführt werden kann |
| Parameter | rknn_model: Pfad zum RKNN-Modell. Ohne Pfadangabe werden die von RKNN-Toolkit Lite2 unterstützten Chipplattformen nach Kategorien ausgegeben |
| Rückgabewert | support_target_platform: Chipplattformen, auf denen das Modell ausgeführt werden kann. Ist der RKNN-Modellpfad leer oder nicht vorhanden, wird None zurückgegeben |
Codebeispiel:
rknn_lite.list_support_target_platform(rknn_model=’mobilenet_v1.rknn’)
Das Ergebnis ist nachfolgend dargestellt:
**************************************************
Target platforms filled in RKNN model: ['rk3566']
Target platforms supported by this RKNN model: ['RK3566', 'RK3568']
**************************************************
3.5 API für Matrixmultiplikation
Die Matmul-API ist ein separater Satz von C-APIs der Runtime für Matrixmultiplikation auf der NPU. RV1103/RV1103B/RV1106/RV1106B/RK2118 werden noch nicht unterstützt. Matrixmultiplikation ist eine wichtige Operation der linearen Algebra und wird wie folgt definiert:
C=AB,
wobei A eine M×K-Matrix, B eine K×N-Matrix und C eine M×N-Matrix ist.
3.5.1 Eigenschaften und Verwendung
Die Matmul-API wird hauptsächlich für Parameterberechnungen im Deep Learning verwendet. Matrixmultiplikation kommt beispielsweise in den Hauptmodulen der verbreiteten Transformer-Architektur zum Einsatz, insbesondere im Self-Attention-Mechanismus und in Feedforward-Netzwerkschichten. Ihre Effizienz ist daher entscheidend für die Gesamtleistung des Transformer-Modells. Eigenschaften:
Effizienz: Die zugrunde liegende Implementierung der Matmul-API verwendet RKNPU und bietet hohe Leistung bei niedrigem Energieverbrauch.
Flexibilität: Ein RKNN-Modell muss nicht geladen werden. Unterstützt werden die im Edge Computing verbreiteten Eingabetypen int4, int8 und float16, eine separate Speicherallokationsschnittstelle und ein Mechanismus für externen Speicher. Benutzer können den Ein- und Ausgabespeicher der Matrizen selbst verwalten und wiederverwenden.
3.5.2 Flussdiagramm der Matmul-API
Binden Sie beim Kompilieren die Headerdatei rknn_matmul_api.h ein; sie enthält die Strukturen und Schnittstellen der Matmul-API.
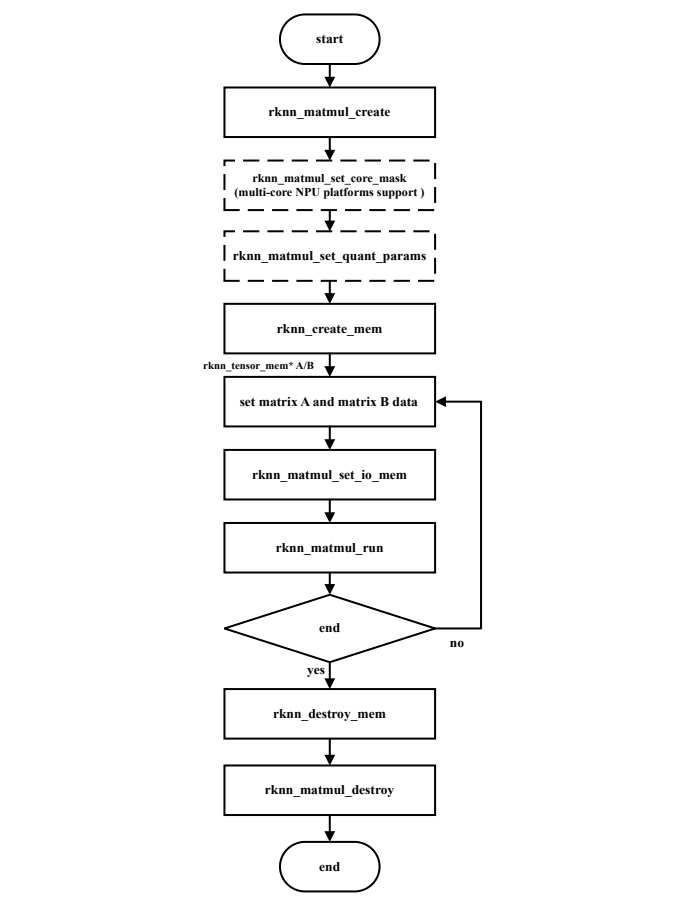
Abbildung 3-6: Grundlegender Ablauf der Matmul-API
Schritte zur Verwendung der Matmul-API:
1. Kontext erstellen: rknn_matmul_info mit M, K, N, Datentypen und Datenlayouts der Ein- und Ausgabematrizen sowie weiteren Informationen konfigurieren. Anschließend rknn_matmul_create zur Kontextinitialisierung aufrufen. Danach den Strukturzeiger rknn_matmul_io_attr mit den Tensorinformationen der Ein- und Ausgabematrizen abrufen.
2. NPU-Kern auswählen, nur auf Mehrkern-NPU-Plattformen: rknn_matmul_set_core_mask aufrufen und die Maske für den gewünschten Kern setzen. Ohne diesen Aufruf wird auf Mehrkern-NPUs standardmäßig automatisch ein freier Kern gewählt.
3. Quantisierungsparameter der Matrizen A, B und C setzen: rknn_matmul_set_quant_params mit einer rknn_quant_params-Struktur mit den entsprechenden Werten aufrufen. Ohne diesen Aufruf gelten für jede Matrix scale=1.0 und zero_point=0.
4. Ein- und Ausgabespeicher mit rknn_create_mem entsprechend den Größen der Matrixtensoren anlegen.
5. Die Eingangsmatrizen A und B entsprechend Form und Datentyp mit Daten füllen. Die Quantisierungsparameter passend zum Quantisierungsverfahren setzen.
6. Ein- und Ausgabespeicher setzen: rknn_matmul_set_io_mem trägt die mit Daten gefüllte Eingangsmatrix und den Ausgabespeicher in den Kontext ein. Neben der Speicheradresse ordnet die Schnittstelle die Daten gemäß dem festgelegten Layout um. Sie muss nach dem Befüllen oder Aktualisieren der Eingabedaten aufgerufen werden und unterscheidet sich damit von rknn_set_io_mem in der Zero-Copy-API.
7. Nach dem Festlegen des Ein- und Ausgabespeichers die Matrixmultiplikation mit rknn_matmul_run ausführen.
8. Nach der Multiplikation das Ergebnis entsprechend dem festgelegten Layout aus dem Ausgabespeicher lesen.
9. Nach der Ausführung Speicher und Kontext mit rknn_destroy_mem beziehungsweise rknn_matmul_destroy freigeben.
3.5.3 Erweiterte Verwendung der Matmul-API
Beim Erstellen des Kontexts muss rknn_matmul_info gesetzt werden. Die Struktur beschreibt Größen, Datentypen und Layouts der Ein- und Ausgabematrizen für die Multiplikation. B_layout und AC_layout legen leistungsoptimierte Datenlayouts fest. Die Strukturdefinition steht in folgender Tabelle:
Tabelle 3-3: Felder von rknn_matmul_info
| Feld | Datentyp | Beschreibung |
|---|---|---|
| M | int32_t | Zeilenzahl von Matrix A |
| K | int32_t | Spaltenzahl von Matrix A |
| N | int32_t | Spaltenzahl von Matrix B |
| type | rknn_matmul_type | Datentypen der Ein- und Ausgabematrizen: RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT32: A ist float16, B ist float16, C ist float32; RKNN_INT8_MM_INT8_TO_INT32: A ist int8, B ist int8, C ist int32; RKNN_INT8_MM_INT8_TO_INT8: A ist int8, B ist int8, C ist int8; RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT16: A ist float16, B ist float16, C ist float16; RKNN_FLOAT16_MM_INT8_TO_FLOAT32: A ist float16, B ist int8, C ist float32; RKNN_FLOAT16_MM_INT8_TO_FLOAT16: A ist float16, B ist int8, C ist float16; RKNN_FLOAT16_MM_INT4_TO_FLOAT32: A ist float16, B ist int4, C ist float32; RKNN_FLOAT16_MM_INT4_TO_FLOAT16: A ist float16, B ist int4, C ist float16; RKNN_INT8_MM_INT8_TO_FLOAT32: A ist int8, B ist int8, C ist float32; RKNN_INT4_MM_INT4_TO_INT16: A ist int4, B ist int4, C ist int16; RKNN_INT8_MM_INT4_TO_INT32: A ist int8, B ist int4, C ist int32; |
| B_layout | int16_t | Datenanordnung von Matrix B. RKNN_MM_LAYOUT_NORM: ursprüngliche Form KxN; RKNN_MM_LAYOUT_NATIVE: Hochleistungslayout; RKNN_MM_LAYOUT_TP_NORM: Form nach Transposition, also NxK. |
| B_quant_type | int16_t | Quantisierungsmethode für Matrix B. RKNN_QUANT_TYPE_PER_LAYER_SYM: symmetrische Quantisierung von Matrix B pro Schicht; RKNN_QUANT_TYPE_PER_LAYER_ASYM: asymmetrische Quantisierung von Matrix B pro Schicht; RKNN_QUANT_TYPE_PER_CHANNEL_SYM: symmetrische Quantisierung von Matrix B pro Kanal; RKNN_QUANT_TYPE_PER_CHANNEL_ASYM: asymmetrische Quantisierung von Matrix B pro Kanal; RKNN_QUANT_TYPE_PER_GROUP_SYM: symmetrische Quantisierung von Matrix B pro Gruppe; RKNN_QUANT_TYPE_PER_GROUP_ASYM: asymmetrische Quantisierung von Matrix B pro Gruppe; |
| AC_layout | int16_t | Datenanordnung der Matrizen A und C. RKNN_MM_LAYOUT_NORM: ursprüngliche Formen; RKNN_MM_LAYOUT_NATIVE: Hochleistungslayout. Die Spezifikation steht in 3.5.4. |
| AC_quant_type | int16_t | Datenanordnung der Matrizen A und C. RKNN_MM_LAYOUT_NORM: ursprüngliche Formen; RKNN_MM_LAYOUT_NATIVE: Hochleistungslayout. |
| iommu_domain_id | int32_t | Index der IOMMU-Adressraumdomäne des Matrixkontexts. IOMMU-Adressraum und Kontext entsprechen einander eins zu eins; jeder Adressraum ist 4GB groß. Der Parameter dient vor allem bei großen Matrizen A, B und C dazu, in eine andere Domäne zu wechseln, wenn der von der NPU belegte Speicher einer Domäne 4GB überschreitet. |
| group_size | int16_t | Anzahl der Elemente pro Gruppe; nur bei aktivierter Gruppenquantisierung wirksam. |
| reserved | int8_t[] | Reservierte Felder |
Die ursprüngliche Form von A ist MxK, von B KxN und von C MxN.
3.5.3.1 Matrixmultiplikation mit vorgegebenen Quantisierungsparametern
Soll das Matrixprodukt höherer Bitbreite in Daten niedrigerer Bitbreite quantisiert werden, etwa bei A und B vom Typ int8 sowie C vom Typ int8, müssen Quantisierungsparameter gesetzt werden. Sie bestehen aus scale und zero_point und werden durch rknn_quant_params dargestellt. Die Parameter für A und C setzt rknn_matmul_set_quant_params. Nach erfolgreicher Einstellung lassen sich die Parameter für B im Per-Channel-Modus mit rknn_matmul_get_quant_params abfragen. Die Struktur rknn_quant_params ist nachfolgend beschrieben:
Tabelle 3-4: Strukturdefinition von rknn_quant_params
| Feld | Datentyp | Beschreibung |
|---|---|---|
| name | char[] | Name der Matrix |
| scale | float* | Startadresse des Quantisierungsparameter-Arrays scale |
| scale_len | int32_t | Länge des Quantisierungsparameter-Arrays scale |
| zp | int32_t* | Startadresse des Quantisierungsparameter-Arrays zero_point |
| zp_len | int32_t | Länge des Quantisierungsparameter-Arrays zero_point |
Matmul unterstützt Per-Layer, Per-Channel und Per-Group mit folgenden Parametern:
Per-Layer: Die Arrays scale und zp haben die Länge 1.
Per-Channel: Die Arrays scale und zp haben die Länge N.
Per-Group: Die Arrays scale und zp haben die Länge N*K/group_size. group_size legt die Elementanzahl pro Gruppe fest; Elemente derselben Gruppe teilen die Quantisierungsparameter group_size, wie im Original formuliert.
Unterstützt werden symmetrische und asymmetrische Quantisierung. Bei symmetrischer Quantisierung sind alle zp gleich 0, bei asymmetrischer nicht alle.
3.5.3.2 Matrixmultiplikation mit dynamischer Eingabeform
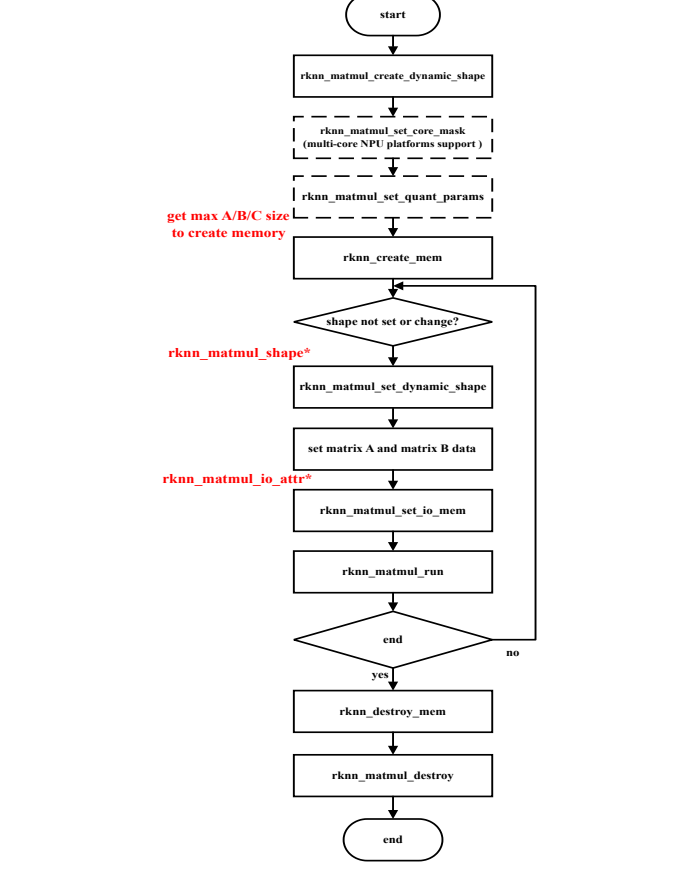
Abbildung 3-7: Matmul-API-Ablauf für dynamische Eingabeformen
Der Ablauf für dynamische Eingabeformen ist oben dargestellt. Gegenüber dem grundlegenden Matmul-API-Ablauf bestehen folgende Unterschiede:
1. Kontext erstellen: Anzahl und Werte der Formen sowie rknn_matmul_info mit Datentypen und Layouts der Ein- und Ausgabematrizen konfigurieren. M, K und N in rknn_matmul_info müssen bei dynamischen Formen nicht gesetzt werden. Den Kontext mit rknn_matmul_create_dynamic_shape initialisieren. Anschließend das
Strukturarray rknn_matmul_io_attr mit den Ein- und Ausgabetensorinformationen aller Formkonfigurationen abrufen.
2. Ein- und Ausgabespeicher erstellen: Die maximale Tensorgröße aus rknn_matmul_io_attr bestimmen und mit rknn_create_mem Speicher für die maximalen Ein- und Ausgabematrixgrößen anlegen.
3. Die aktuelle Eingabeform mit rknn_matmul_set_dynamic_shape und einem Zeiger auf rknn_matmul_shape festlegen.
4. Speicher mit rknn_matmul_set_io_mem setzen: Die gefüllte Eingangsmatrix und der Ausgabespeicher werden in den Kontext eingetragen. rknn_tensor_mem* bezeichnet den zuvor angelegten Speicher maximaler Größe; rknn_matmul_tensor_attr* enthält die zur aktuellen Form passenden Matrixattribute.
3.5.4 Leistungsoptimiertes Datenlayout
Aufgrund der spezialisierten NPU-Hardwarearchitektur ist das Lesen der ursprünglichen Formen MxK und KxN sowie das Schreiben von C in MxN nicht optimal. Spezielle Datenanordnungen erhöhen die Leistung. AC_layout steuert das leistungsoptimierte Layout für A und C, B_layout für B.
Die ursprünglichen Formen von A, B und C seien MxK, KxN und MxN. Dann gelten folgende Layouts:
1. Bei AC_layout=RKNN_MM_LAYOUT_NORM und B_layout=RKNN_MM_LAYOUT_NORM haben A, B und C die Formen [M,K], [K,N] und [M,N].
2. Bei AC_layout=RKNN_MM_LAYOUT_NATIVE und B_layout=RKNN_MM_LAYOUT_NATIVE zeigt die folgende Tabelle die Anordnung von A, B und C für verschiedene Chips und Datentypen. Divisionsergebnisse werden aufgerundet, überschüssige Bereiche mit 0 gefüllt.
3. Bei B_layout=RKNN_MM_LAYOUT_NORM hat B die Form [K,N], bei B_layout=RKNN_MM_LAYOUT_TP_NORM die Form [N,K]. Letzteres wird effizienter ausgeführt.
Tabelle 3-5: Leistungsoptimierte Formen von A, B und C auf den einzelnen Chipplattformen
| Form | RK3562 | RK3566/RK3568 | RK3576/RV1126B | RK3588 |
|---|---|---|---|---|
| A(int4) | nicht unterstützt | nicht unterstützt | [K/32,M,32] | [K/32,M,32] |
| B(int4) | nicht unterstützt | nicht unterstützt | [N/64,K/32,64,32]* | [N/64,K/32,64,32] |
| C(int16) | nicht unterstützt | nicht unterstützt | [N/8,M,8] | [N/8,M,8] |
| A(int8) | [K/16,M,16] | [K/8, M, 8] | [K/16,M,16] | [K/16,M,16] |
| B(int8) | [N/16,K/32,16,32] | [N/16,K/32,16,32] | [N/32,K/32,32,32]* | [N/32,K/32,32,32] |
| C(int32) | [N/4,M,4] | [N/4,M,4] | [N/4,M,4] | [N/4,M,4] |
| A(float16) | [K/8,M,8] | [K/4,M,4] | [K/8,M,8] | [K/8,M,8] |
| B(float16) | [N/8,K/32,8,32] | [N/8,K/16,8,16] | [N/16,K/32,16,32] | [N/16,K/32,16,32] |
| C(float32) | [N/4,M,4] | [N/4,M,4] | [N/4,M,4] | [N/4,M,4] |
Hinweis
Die Tabelle setzt gleiche Datentypen für A und B voraus. RK3576/RV1126B unterstützt Eingaben unterschiedlicher Typen. Dabei entspricht das leistungsoptimierte Layout von B dem B-Layout des Falls gleicher Typen, das zu Typ C gehört. Sind beispielsweise A vom Typ int4, B float16 und C float32, lautet das leistungsoptimierte B-Layout [N/16,K/32,16,32]. rknn_B_normal_layout_to_native_layout konvertiert die ursprüngliche Form von B in dieses Layout.
Für RK3566/RK3568 und int8 zeigt die folgende Abbildung die Elementzuordnung von A bei der Umwandlung von [M,K] nach [K/8,M,8]:
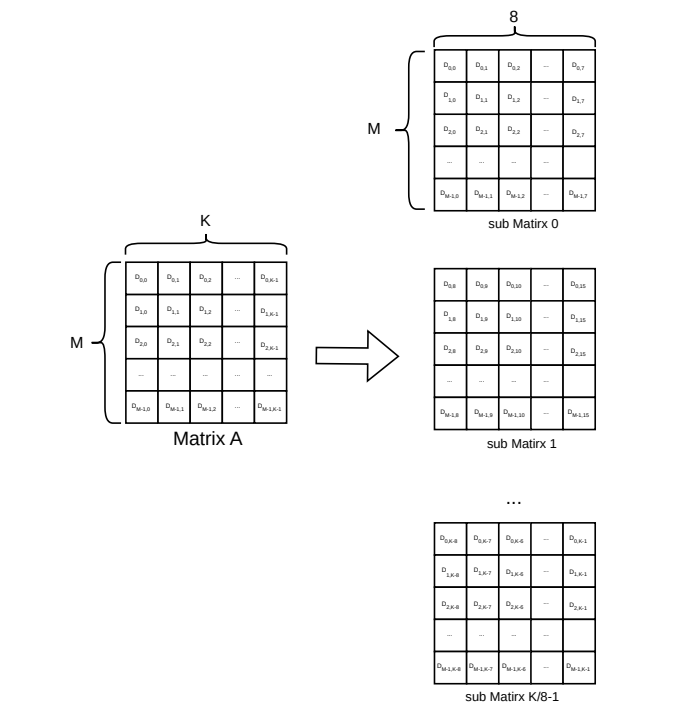
Abbildung 3-8: Elementzuordnung der int8-Matrix A bei der Umwandlung von [M,K] nach [K/8,M,8]
Zum Element (i, j) von A gehört Di, j. Links steht eine Matrix mit shape=[M,K]; rechts sind von oben nach unten insgesamt K/8 Teilmatrizen mit jeweils shape=[M,8] angeordnet.
Codebeispiel zur Umwandlung von A oder C aus der ursprünglichen in die leistungsoptimierte Form:
template <typename Ti, typename To>
void norm_layout_to_perf_layout(Ti *src, To *dst, int32_t M, int32_t K, int32_t subK)
{
  int outter_size = (int)std::ceil(K * 1.0f / subK);
  for (int i = 0; i < outter_size; i++)
  {
    for (int m = 0; m < M; m++)
    {
      for (int j = 0; j < subK; j++)
      {
        int ki = i * subK + j;
        if (ki >= K)
        {
          dst[i * M * subK + m * subK + j] = 0;
        }
        else
        {
          dst[i * M * subK + m * subK + j] = src[m * K + ki];
        }
      }
    }
  }
}
Für RK3566/RK3568 zeigt die folgende Abbildung die Elementzuordnung der int8-Matrix B bei der Umwandlung von [K,N] nach [N/16,K/32,16,32]:
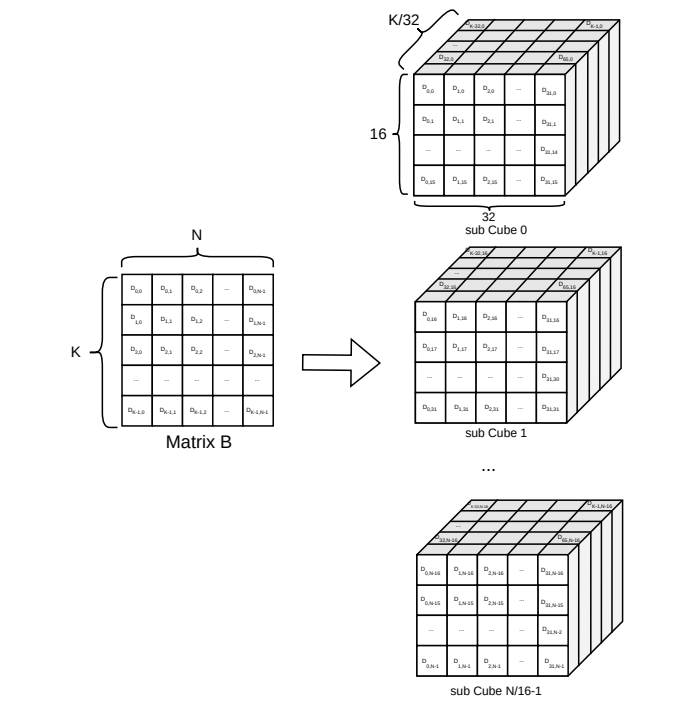
Abbildung 3-9: Elementzuordnung der int8-Matrix B bei der Umwandlung von [K,N] nach [N/16,K/32,16,32]
Zum Element (i, j) von B gehört Di, j. Links steht eine Matrix mit shape=[K,N]; jeder kleine Würfel rechts hat shape=[K/32,16,32]. Von oben nach unten sind insgesamt N/16 Würfel angeordnet.
Codebeispiel zur Umwandlung von B aus der ursprünglichen in die leistungsoptimierte Form:
template <typename Ti, typename To>
void norm_layout_to_native_layout(Ti *src, To *dst, int32_t K, int32_t N, int32_t subN, int32_t subK)
{
  int N_remain = (int)std::ceil(N * 1.0f / subN);
  int K_remain = (int)std::ceil(K * 1.0f / subK);
  for (int i = 0; i < N_remain; i++)
  {
    for (int j = 0; j < K_remain; j++)
    {
      for (int n = 0; n < subN; n++)
      {
        int ni = i * subN + n;
        for (int k = 0; k < subK; k++)
        {
          int ki = j * subK + k;
          if (ki < K && ni < N)
          {
            dst[((i * K_remain + j) * subN + n) * subK + k] = src[ki * N + ni];
          }
          else
          {
            dst[((i * K_remain + j) * subN + n) * subK + k] = 0;
          }
        }
      }
    }
  }
}
Hinweis
Vollständiges Matmul-API-Beispiel: https://github.com/airockchip/rknn-toolkit2/tree/master/rknpu2/examples/rknn_matmul_api_demo
3.5.4.1 Einschränkungen der Matrixspezifikation
Die Matmul-API ist auf der NPU-Hardwarearchitektur implementiert und unterliegt deren Spezifikation. Für die Parameter gelten folgende Einschränkungen:
AC_layout und B_layout können unabhängig gesetzt werden. Das Original nennt RKNN_MM_LAYOUT_NORM oder RKNN_MM_LAYOUT_TP_NORM für beide Parameter auf allen Plattformen und schränkt anschließend ein, dass RKNN_MM_LAYOUT_TP_NORM auf allen außer RK3566/RK3568 unterstützt wird. Dieser Widerspruch des Originals bleibt zur Prüfung erhalten.
MATMUL unterstützt unterschiedliche Ein- und Ausgabebitbreiten. Die von den Plattformen unterstützten Matrixdatentypen sind in folgender Tabelle zusammengefasst:
Tabelle 3-6: Von Matmul unterstützte Datentypen der Matrizen A, B und C
| Nummer | RK3562 | RK3566/RK3568 | RK3576/RV1126B | RK3588 |
|---|---|---|---|---|
| 1 | RKNN_INT8_MM_INT8_TO_INT32 | RKNN_INT8_MM_INT8_TO_INT32 | RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT16 | RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT16 |
| 2 | RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT32 | RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT32 | RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT32 | RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT32 |
| 3 | RKNN_INT8_MM_INT8_TO_INT32 | RKNN_INT8_MM_INT8_TO_INT32 | ||
| 4 | RKNN_FLOAT16_MM_INT8_TO_FLOAT32 | RKNN_INT8_MM_INT8_TO_FLOAT32 | ||
| 5 | RKNN_FLOAT16_MM_INT4_TO_FLOAT16 | RKNN_INT8_MM_INT8_TO_INT8 | ||
| 6 | RKNN_FLOAT16_MM_INT4_TO_FLOAT32 | RKNN_INT4_MM_INT4_TO_INT16 | ||
| 7 | RKNN_INT8_MM_INT4_TO_INT32 |
Das Gleitkommaformat float16 folgt IEEE-754. Weitere Informationen finden Sie unter IEEE-754 half.
Größenbeschränkungen für K und N:
Tabelle 3-7: Größenbeschränkungen für K und N je Chipplattform
| RK3562 | RK3566/RK3568 | RK3576/RV1126B | RK3588 | |
|---|---|---|---|---|
| Größenbegrenzung für K (int4) |
nicht unterstützt | nicht unterstützt | * | auf 32 ausgerichtet |
| Größenbegrenzung für K (int8) |
K <= 10240 und K mod 32 = 0 |
K <= 10240 und K mod 32 = 0 |
auf 32 ausgerichtet | auf 32 ausgerichtet |
| Größenbegrenzung für K (float16) |
K <= 10240 und K mod 32 = 0 |
K <= 10240 und K mod 32 = 0 |
auf 32 ausgerichtet | auf 32 ausgerichtet |
| Größenbegrenzung für N (int4) |
nicht unterstützt | nicht unterstützt | * | N <= 8192 und N mod 64 = 0 |
| Größenbegrenzung für N (int8) |
N <= 4096 und N mod 16 = 0 |
N <= 4096 und N mod 16 = 0 |
N <= 4096 und N mod 32 = 0 |
N <= 4096 und N mod 32 = 0 |
| Größenbegrenzung für N (float16) |
N <= 4096 und N mod 16 = 0 |
N <= 4096 und N mod 16 = 0 |
N <= 4096 und N mod 32 = 0 |
N <= 4096 und N mod 32 = 0 |
Hinweis
* bedeutet, dass Größen- und Ausrichtungsbeschränkungen denen von B entsprechen, die zum Datentyp A auf derselben Plattform gehören. Beispielsweise gelten für B in RKNN_FLOAT16_MM_INT4_TO_FLOAT32 dieselben Beschränkungen wie in RKNN_FLOAT16_MM_FLOAT16_TO_FLOAT32.
Für RK3588:
Bei K > 8192 werden die B-Daten in T Segmente aufgeteilt.
int T = std::ceil(K / 8192);
Beispiel: normal layout -> native layout, K = 20488, N = 4096, T = 3; die Daten werden in 3 Segmente aufgeteilt.
subN = rknn_matmul_io_attr.B.dims[2];
subK = rknn_matmul_io_attr.B.dims[3];
Form von K,N während der Umwandlung:
                     (8196, 4096) (4096 / subN, 8196 / subK, subN, subK)
 (K, N) = (20488, 4096)->(8196, 4096)->(4096 / subN, 8196 / subK, subN, subK)
         normal layout (4096, 4096) (4096 / subN, 4096 / subK, subN, subK)
                   T normal layout T native layout
Für die direkte Datenkonvertierung wird rknn_B_normal_layout_to_native_layout empfohlen.
Für RK3576/RV1126B:
Bei K > 4096 werden die B-Daten in T Segmente aufgeteilt.
int T = std::ceil(K / 4096);
Beispiel: normal layout -> native layout, K = 10240, N = 2048, T = 3; die Daten werden in 3 Segmente aufgeteilt.
subN = rknn_matmul_io_attr.B.dims[2];
subK = rknn_matmul_io_attr.B.dims[3];
Form von K,N während der Umwandlung:
                        (4096, 2048) (2048 / subN, 4096 / subK, subN, subK)
(K, N) = (10240, 2048) -> (4096, 2048) -> (2048 / subN, 4096 / subK, subN, subK)
        normal layout (2048, 2048) (2048 / subN, 2048 / subK, subN, subK)
                     T normal layout T native layout
Für die direkte Datenkonvertierung wird rknn_B_normal_layout_to_native_layout empfohlen.
4 Beispiele
RKNN stellt Beispiele für verschiedene Modelle bereit, darunter MobileNet und YOLOv5. Der Quellcode befindet sich unter https://github.com/airockchip/rknn_model_zoo/tree/main/examples.
Die folgenden Schritte verwenden RK3588 Linux, Ubuntu22.04 und Python3.8 in einer Conda-Umgebung. Die Einrichtung der Entwicklungsumgebung steht in Kapitel 2. Zur Bereitstellung auf anderen Plattformen siehe Rockchip_RKNPU_Quick_Start_RKNN_SDK.
4.1 Bereitstellungsbeispiel: MobileNet
Anhand von MobileNet zeigt dieses Kapitel den schnellen Einstieg in Modellkonvertierung, Ausführung mit angeschlossener Platine, Bewertung und Bereitstellung auf der Platine.
4.1.1 Modellkonvertierung
1. In rknn_model_zoo/examples/mobilenet/python wechseln:
cd rknn_model_zoo/examples/mobilenet/python
2. Modell konvertieren und Bildinferenz ausführen:
python mobilenet.py --model ../model/mobilenetv2-12.onnx --target rk3588
Der Befehl führt die Inferenz im Simulator auf dem Computer aus. Das konvertierte Modell wird standardmäßig unter rknn_model_zoo/examples/mobilenet/model/mobilenet_v2.rknn gespeichert.
4.1.2 Modell auf dem Gerät ausführen
1. In rknn_model_zoo/examples/mobilenet/python wechseln:
cd rknn_model_zoo/examples/mobilenet/python
2. Modell auf dem Gerät ausführen:
python mobilenet.py --target rk3588 --npu_device_test
Nach diesem Befehl wird die Modellinferenz auf dem Gerät ausgeführt.
Ausgabe:
-----TOP 5-----
[494] score=0.99 class="n03017168 chime, bell, gong"
[469] score=0.00 class="n02939185 caldron, cauldron"
[653] score=0.00 class="n03764736 milk can"
[747] score=0.00 class="n04023962 punching bag, punch bag, punching ball, punchball"
[505] score=0.00 class="n03063689 coffeepot"
4.1.3 Modellbewertung
RKNN bietet Genauigkeitsbewertung im Simulator und auf dem Gerät sowie Laufzeit- und Speicherbewertung zur Unterstützung der Optimierung und Bereitstellung von RKNN-Modellen.
4.1.3.1 Genauigkeitsbewertung
1. In rknn_model_zoo/examples/mobilenet/python wechseln:
cd rknn_model_zoo/examples/mobilenet/python
2. Modellgenauigkeit analysieren:
python mobilenet.py --target rk3588 --accuracy_analysis --npu_device_test
Ausgabe der Modellgenauigkeitsanalyse:
# simulator_error: calculate the output error of each layer of the simulator (compared to the 'golden' value).
# entire: output error of each layer between 'golden' and 'simulator', these errors will accumulate layer by layer.
# single: single-layer output error between 'golden' and 'simulator', can better reflect the single-layer accuracy of the simulator.
layer_name simulator_error
                  entire single
                cos euc cos euc
---------------------------------------------------------------
...
[Conv] 464 0.99202 | 4.1079 0.99998 | 0.1981
[Conv] output_conv 0.99308 | 13.235 0.99992 | 1.4133
[Reshape] output_int8 0.99308 | 13.235 0.99993 | 1.3043
[exDataConvert] output 0.99308 | 13.235 0.99993 | 1.3043

# runtime_error: calculate the output error of each layer of the runtime.
# entire: output error of each layer between 'golden' and 'runtime', these errors will accumulate layer by layer.
# single_sim: single-layer output error between 'simulator' and 'runtime', can better reflect the single-layer accuracy of runtime.
layer_name runtime_error
                  entire single_sim
                cos euc cos euc
---------------------------------------------------------------
...
[Conv] 464 0.99210 | 4.2718 1.00000 | 0.0
[Conv] output_conv 0.99203 | 14.847 1.00000 | 0.2007
[Reshape] output_int8
[exDataConvert] output 0.99203 | 14.847 1.00000 | 0.0
4.1.3.2 Laufzeitbewertung
1. In rknn_model_zoo/examples/mobilenet/python wechseln:
cd rknn_model_zoo/examples/mobilenet/python
2. Modelllaufzeit bewerten:
python mobilenet.py --target rk3588 --eval_perf
Ausgabe der Modelllaufzeitbewertung:
---------------------------------------------------------------
    Network Layer Information Table
---------------------------------------------------------------
ID OpType DataType Target Time(us) ...
---------------------------------------------------------------
1 InputOperator UINT8 CPU 17
2 ConvClip UINT8 NPU 331
3 ConvClip INT8 NPU 429
4 Conv INT8 NPU 292
....
55 Conv INT8 NPU 374
56 Reshape INT8 CPU 61
57 OutputOperator INT8 CPU 11
---------------------------------------------------------------
Total Operator Elapsed Per Frame Time(us): 12631
Total Memory Read/Write Per Frame Size(KB): 10563
---------------------------------------------------------------

---------------------------------------------------------------
    Operator Time Consuming Ranking Table
---------------------------------------------------------------
OpType CallNumber ... NPUTime(us) TotalTime(us) TimeRatio(%)
---------------------------------------------------------------
ConvClip 35 8436 8436 66.79%
Conv 9 2093 2093 16.57%
ConvAdd 10 2013 2013 15.94%
Reshape 1 0 61 0.48%
InputOperator 1 0 17 0.13%
OutputOperator 1 0 11 0.09%
---------------------------------------------------------------
4.1.3.3 Speicherbewertung
1. In rknn_model_zoo/examples/mobilenet/python wechseln:
cd rknn_model_zoo/examples/mobilenet/python
2. Modellspeicherverbrauch bewerten:
python mobilenet.py --target rk3588 --eval_memory
Ausgabe der Modellspeicherbewertung:
---------------------------------------------------------------
    Network Layer Information Table
---------------------------------------------------------------
ID OpType DataType Target Time(us) ...
---------------------------------------------------------------
1 InputOperator UINT8 CPU 17
2 ConvClip UINT8 NPU 331
3 ConvClip INT8 NPU 429
4 Conv INT8 NPU 292
....
55 Conv INT8 NPU 374
56 Reshape INT8 CPU 61
57 OutputOperator INT8 CPU 11
---------------------------------------------------------------
Total Operator Elapsed Per Frame Time(us): 12631
Total Memory Read/Write Per Frame Size(KB): 10563
---------------------------------------------------------------

---------------------------------------------------------------
    Operator Time Consuming Ranking Table
---------------------------------------------------------------
OpType CallNumber ... NPUTime(us) TotalTime(us) TimeRatio(%)
---------------------------------------------------------------
ConvClip 35 8436 8436 66.79%
Conv 9 2093 2093 16.57%
ConvAdd 10 2013 2013 15.94%
Reshape 1 0 61 0.48%
InputOperator 1 0 17 0.13%
OutputOperator 1 0 11 0.09%
---------------------------------------------------------------
4.1.4 Modell auf dem Gerät bereitstellen
1. Den Pfad zum gcc-Cross-Compiler im Skript build-linsx.sh des Projekts rknn_model_zoo angeben; der Skriptname wurde aus dem Original übernommen.
GCC_COMPILER=~/opts/gcc-linaro-6.3.1-2017.05-x86_64_aarch64-linux-gnu/bin/aarch64-linux-gnu
Zum Herunterladen und Installieren des gcc-Cross-Compilers siehe Rockchip_RKNPU_Quick_Start_RKNN_SDK.
2. Kompilierung
cd rknn_model_zoo
./build-linux.sh -t rk3588 -a aarch64 -d mobilenet
3. Ausführbare Datei auf die Platine übertragen:
adb push install/rk3588_linux_aarch64/rknn_mobilenet_demo /userdata/
4. Modell auf dem Gerät ausführen:
adb shell

cd /userdata/rknn_mobilenet_demo
export LD_LIBRARY_PATH=./lib
./rknn_mobilenet_demo model/mobilenet_v2.rknn model/bell.jpg
Ausgabe:
-----TOP 5-----
[494] score=0.993227 class=n03017168 chime, bell, gong
[469] score=0.002560 class=n02939185 caldron, cauldron
[747] score=0.000466 class=n04023962 punching bag, punch bag, punching ball, punchball
[792] score=0.000466 class=n04208210 shovel
[618] score=0.000405 class=n03633091 ladle
4.2 Bereitstellungsbeispiel: YOLOv5
4.2.1 Modellkonvertierung
1. Modell herunterladen.
cd rknn_model_zoo/examples/yolov5/model
./download_model.sh
2. Modell konvertieren:
cd rknn_model_zoo/examples/yolov5/python
python convert.py ../model/yolov5s_relu.onnx rk3588 i8 ../model/yolov5.rknn
Das konvertierte Modell wird unter rknn_model_zoo/examples/yolov5/model/yolov5.rknn gespeichert.
4.2.2 Modell auf dem Gerät ausführen
1. In rknn_model_zoo/examples/yolov5/python wechseln:
cd rknn_model_zoo/examples/yolov5/python
2. Modell auf dem Gerät ausführen:
python yolov5.py --model_path ../model/yolov5.rknn --target rk3588 --img_show
Das Standardeingabebild ist model/bus.jpg. Das Ergebnis ist nachfolgend dargestellt:
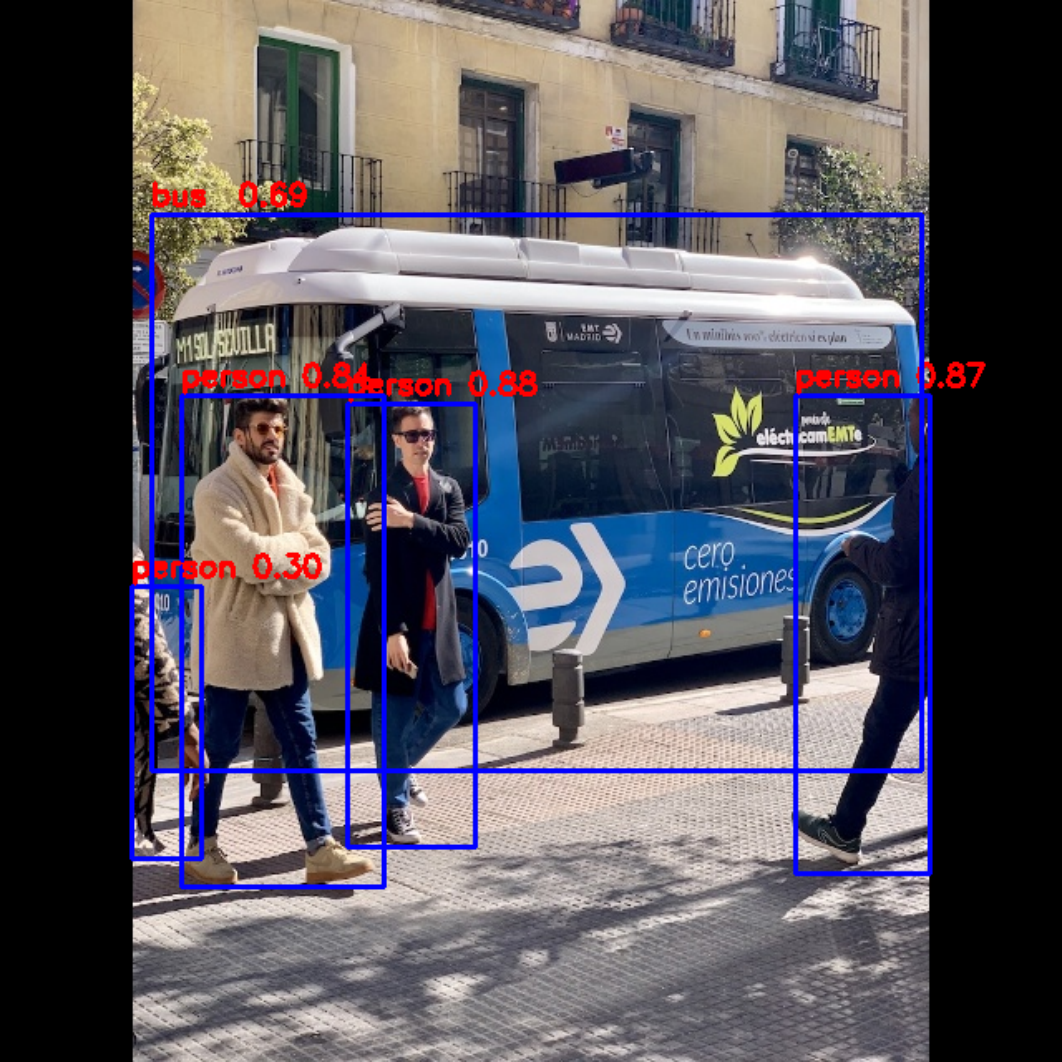
Abbildung 4-1: RKNN-Ausgabebild des Python-Demos
4.2.3 Modell auf dem Gerät bereitstellen
1. Den Pfad zum gcc-Cross-Compiler im Skript build-linsx.sh des Projekts rknn_model_zoo angeben; der Skriptname wurde aus dem Original übernommen.
GCC_COMPILER=~/opts/gcc-linaro-6.3.1-2017.05-x86_64_aarch64-linux-gnu/bin/aarch64-linux-gnu
Zum Herunterladen und Installieren des gcc-Cross-Compilers siehe Rockchip_RKNPU_Quick_Start_RKNN_SDK.
2. Kompilierung:
cd rknn_model_zoo
./build-linux.sh -t rk3588 -a aarch64 -d yolov5
3. Ausführbare Datei auf das Gerät übertragen:
adb push install/rk3588_linux_aarch64/rknn_yolov5_demo /userdata/
4. Modell auf dem Gerät ausführen:
adb shell
cd userdata/rknn_yolov5_demo
export LD_LIBRARY_PATH=./lib
./rknn_yolov5_demo model/yolov5.rknn model/bus.jpg
5. Ergebnis von der Platine zur lokalen Anzeige herunterladen. Im Terminal des lokalen Computers folgenden Befehl ausführen:
adb pull /userdata/rknn_yolov5_demo/out.png .
Ausgabebild:
Abbildung 4-2: RKNN-Ausgabebild des C-Demos
5 Erweiterte RKNN-Anleitung
5.1 Datenformate
RKNN verwendet vier Datenformate: NHWC, NCHW, NC1HWC2 und UNDEFINE. NHWC und NCHW sind im Deep Learning verbreitet und werden nicht weiter erläutert. Dieser Abschnitt behandelt Speicherung und Konvertierung des für die RKNPU-Hardware vorgesehenen NC1HWC2-Formats.
Abbildung 5-1: RKNPU-NC1HWC2-Datenformat und Speicherung
In Abbildung 5-1 bezeichnet die Zahl 0 die Speicherung eines C2-Datenblocks; C2 wird durch die Plattform bestimmt. Tabelle 5-1 enthält die C2-Beschränkungen; C1 ist der aufgerundete Wert von C/C2. Die Speicherreihenfolge entspricht den aufsteigenden Zahlen: zunächst 0–15, dann 16–31. Auf RK3568 entspricht beispielsweise der int8-Merkmalsform (1, 13, 4, 4) die NC1HWC2-Form (1, 2, 4, 4, 8): C2=8 und C1=2. In den C2-Blöcken 16–31 sind jeweils nur die ersten fünf Elemente gültig; die übrigen drei sind ungültige Ausrichtungsfüllwerte.
Tabelle 5-1: C2 auf verschiedenen RKNPU-Hardwareplattformen
| RV1103/RV1106 | RV1103B/RV1106B | RK2118 | RK3562 | RK3566/RK3568 | RK3576/RK3588/RV1126B | |
|---|---|---|---|---|---|---|
| int8 | 16 | 8 | / | 16 | 8 | 16 |
| float16 | 8 | / | 4 | 8 | 4 | 8 |
Nachfolgend wird die Konvertierung von NC1HWC2 in NCHW und NHWC im Speicher erläutert. Auf RK3568 entspricht gemäß den Ausrichtungsanforderungen der int8-Merkmalsform (1, 13, 2, 2) die NC1HWC2-Form (1, 2, 2, 2, 8). Die Speicherung ist unten dargestellt; rote Bereiche sind ungültige Ausrichtungsfüllwerte.
Abbildung 5-2: Aufgeschlüsselte NC1HWC2-Datenanordnung
Nach Entfernen der ungültigen Daten und Konvertierung nach NCHW, also (1, 13, 2, 2), ergibt sich folgende Speicheranordnung:
Abbildung 5-3: NCHW-Layout
Nach Entfernen der ungültigen Daten und Konvertierung nach NHWC, also (1, 2, 2, 13), ergibt sich folgende Speicheranordnung:
Abbildung 5-4: NHWC-Layout
Codebeispiel für die Konvertierung:
1. NC1HWC2 nach NCHW: Konvertierung von int8-Daten im NC1HWC2-Format in int8-NCHW.
/*
 *src: represents the address of NC1HWC2 tensor
 *dst: represents the address of the NCHW tensor
 *dims: represents the shape information of NC1HWC2
 *channel: represents the value of C in NCHW
 * h : represents the value of h in NCHW
 * w: represents the value of w in NCHW
 */
int NC1HWC2_to_NCHW(const int8_t* src, int8_t* dst, int* dims, int channel, int h, int w)
{
  int batch = dims[0];
  int C1 = dims[1];
  int C2 = dims[4];
  int hw_src = dims[2] * dims[3];
  int hw_dst = h * w;
  for (int i = 0; i < batch; i++) {
    src = src + i * C1 * hw_src * C2;
    dst = dst + i * channel * hw_dst;
    for (int c = 0; c < channel; ++c) {
    int plane = c / C2;
    const int8_t* src_c = plane * hw_src * C2 + src;
    int offset = c % C2;
    for (int cur_h = 0; cur_h < h; ++cur_h)
      for (int cur_w = 0; cur_w < w; ++cur_w) {
      int cur_hw = cur_h * w + cur_w;
      dst[c * hw_dst + cur_h * w + cur_w] = src_c[C2 * cur_hw + offset];
      }
    }
  }

  return 0;
}
2. NC1HWC2 nach NHWC: Konvertierung von int8-Daten im NC1HWC2-Format in int8-NHWC.
/*
 *src: represents the address of NC1HWC2 tensor
 *dst: represents the address of the NCHW tensor
 *dims: represents the shape information of NC1HWC2
 *channel: represents the value of C in NCHW
 * h : represents the value of h in NCHW
 * w: represents the value of w in NCHW
 */
int NC1HWC2_to_NHWC(const int8_t* src, int8_t* dst, int* dims, int channel, int h, int w)
{
  int batch = dims[0];
  int C1 = dims[1];
  int C2 = dims[4];
  int hw_src = dims[2] * dims[3];
  int hw_dst = h * w;
  for (int i = 0; i < batch; i++) {
    src = src + i * C1 * hw_src * C2;
    dst = dst + i * channel * hw_dst;
    for (int cur_h = 0; cur_h < h; ++cur_h) {
      for (int cur_w = 0; cur_w < w; ++cur_w) {
        int cur_hw = cur_h * dims[3] + cur_w;
        for (int c = 0; c < channel; ++c) {
          int plane = c / C2;
          const auto* src_c = plane * hw_src * C2 + src;
          int offset = c % C2;
          dst[cur_h * w * channel + cur_w * channel + c] = src_c[C2 * cur_hw + offset];
        }
      }
    }
  }
  return 0;
}
5.2 Zero-Copy-Schnittstelle der RKNN Runtime
5.2.1 Einführung in Zero-Copy
Auf RK3562/RK3566/RK3568/RK3576/RK3588/RV1126B stehen die allgemeine API und die Zero-Copy-API zur Verfügung; RV1103/RV1103B/RV1106/RV1106B unterstützen nur letztere. Zero-Copy-Beispiele liegen unter examples/rknn_zero_copy im rknpu2-Projekt. Informationen und Quellcode: https://github.com/airockchip/rknn-toolkit2/tree/master/rknpu2.
Bei der RKNN-Inferenz durchlaufen die ursprünglichen Daten Eingabeverarbeitung, Modellausführung auf der NPU und Ausgabeverarbeitung. Abhängig von Eingabeformat und Quantisierungsverfahren kommen allgemeine API oder Zero-Copy-API zum Einsatz, wie dargestellt in
Abbildung 5-5 und 5-6. Bei jeder Frame-Aktualisierung kopiert die allgemeine API extern allokierte Daten zur Laufzeit in den NPU-Eingabespeicher. Zero-Copy verwendet vorab allokierten Speicher der NPU oder anderer Subsysteme wie DRM direkt, reduziert Kopieraufwand und Bandbreitenbedarf und verbessert die Leistung. Bei ausschließlich virtueller Eingabeadresse ist nur die allgemeine API nutzbar; bei physischer Adresse oder fd beide APIs. Allgemeine API und Zero-Copy-API dürfen nicht gemeinsam aufgerufen werden.
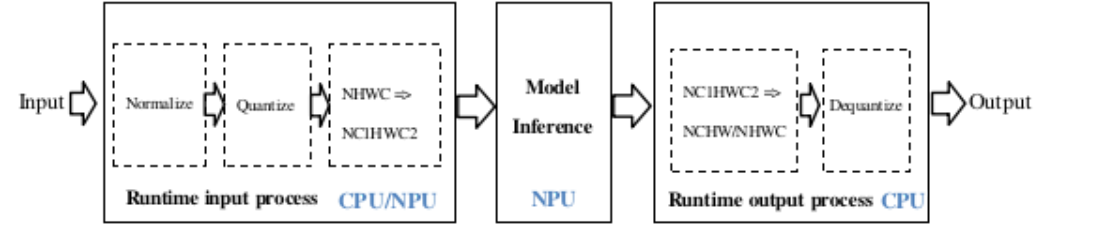
Abbildung 5-5: Datenverarbeitung der allgemeinen API
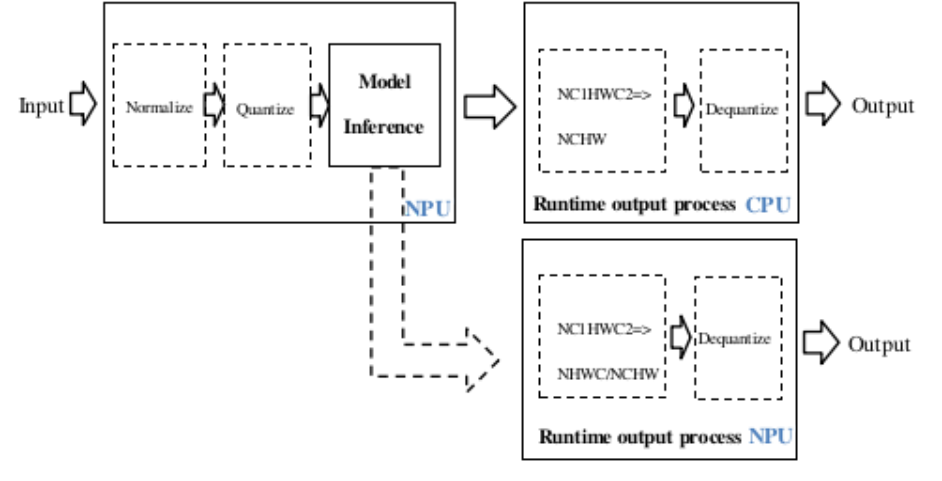
Abbildung 5-6: Datenverarbeitung der Zero-Copy-API
Allgemeine API
In Abbildung 5-5 erfolgen Normalisierung, Quantisierung, Formatkonvertierung und Dequantisierung auf der CPU; die Inferenz auf der NPU. Sind die Zero-Copy-Eingabeausrichtungen erfüllt, laufen Normalisierung und Quantisierung auf der NPU, die CPU muss die Eingabedaten jedoch weiterhin in den Modelleingabepuffer kopieren.
Zero-Copy-API
Der Ablauf in Abbildung 5-6 optimiert die allgemeine API. Normalisierung, Quantisierung und Inferenz laufen auf der NPU; Ausgabeformatkonvertierung und Dequantisierung auf CPU oder NPU. Der Eingabedatenstrom wird effizienter als mit der allgemeinen API verarbeitet.
Die Voraussetzungen für Zero-Copy stehen in folgender Tabelle:
Tabelle 5-2: Ausrichtungsanforderungen für Zero-Copy-Eingaben
| Eingangsdimensionen | Ausrichtungsanforderungen für den Eingang | |
|---|---|---|
| RV1103B/RV1106B/RK3566/RK3568 | RV1103/RV1106/RV1126B/RK3562/RK3576/RK3588 | |
| 4 Dimensionen; Kanalzahl 1, 3, 4 | Breite auf 8 Byte ausgerichtet | Breite auf 16 Byte ausgerichtet |
| Nicht 4 Dimensionen | Gesamtgröße auf 8 Byte ausgerichtet | Gesamtgröße auf 16 Byte ausgerichtet |
5.2.2 Zero-Copy-Ablauf der C-API
Die Zero-Copy-API verwendet rknn_tensor_memory. Die Struktur muss vor der Inferenz angelegt und gesetzt werden; danach werden ihre Speicherinformationen gelesen. Je nach externer Allokation von Modellbestandteilen (Ein-/Ausgabe, Gewichte, interne Ergebnisse) und Speicherdarstellung (fd, physische Adresse usw.) ergeben sich drei typische Abläufe in Abbildung 5-7 bis 5-9. Rot kennzeichnet spezielle Zero-Copy-Schnittstellen und -Strukturen, kursiv die zwischen Aufrufen übergebenen Strukturen.
1. Ein- und Ausgabespeicher wird durch die Runtime allokiert
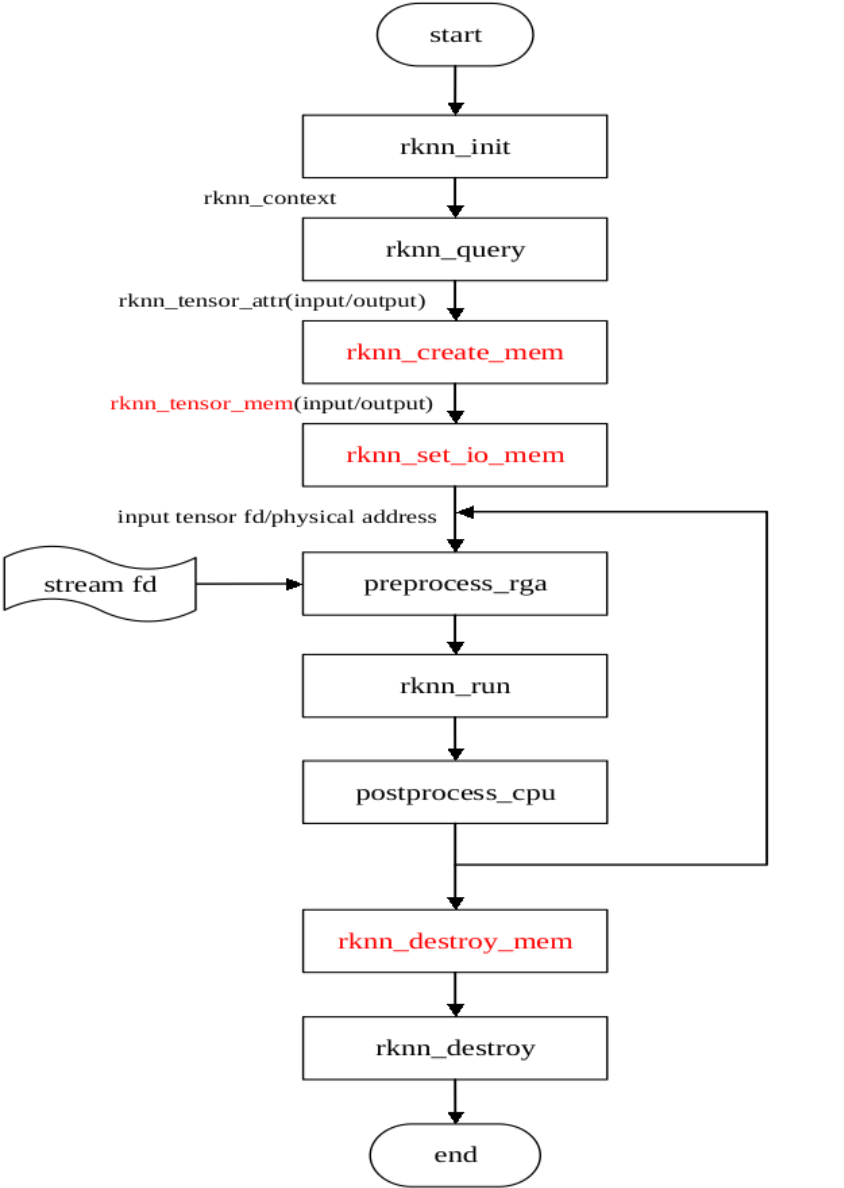
Abbildung 5-7: Zero-Copy-API mit intern allokiertem Ein- und Ausgabespeicher
In Abbildung 5-7 erstellt die Runtime rknn_tensor_memory mit rknn_create_mem(); rknn_set_io_mem() setzt die Strukturen für Ein- und Ausgabespeicher.
Die mit rknn_create_mem() erzeugte Struktur enthält Dateideskriptor und physische Adresse. RGA verwendet die von der NPU allokierten Speicherinformationen. preprocess_rga() bezeichnet die RGA-Schnittstelle, stream_fd ihren Eingabequellpuffer und postprocess_cpu() die CPU-Nachverarbeitung.
2. Ein- und Ausgabespeicher wird extern allokiert
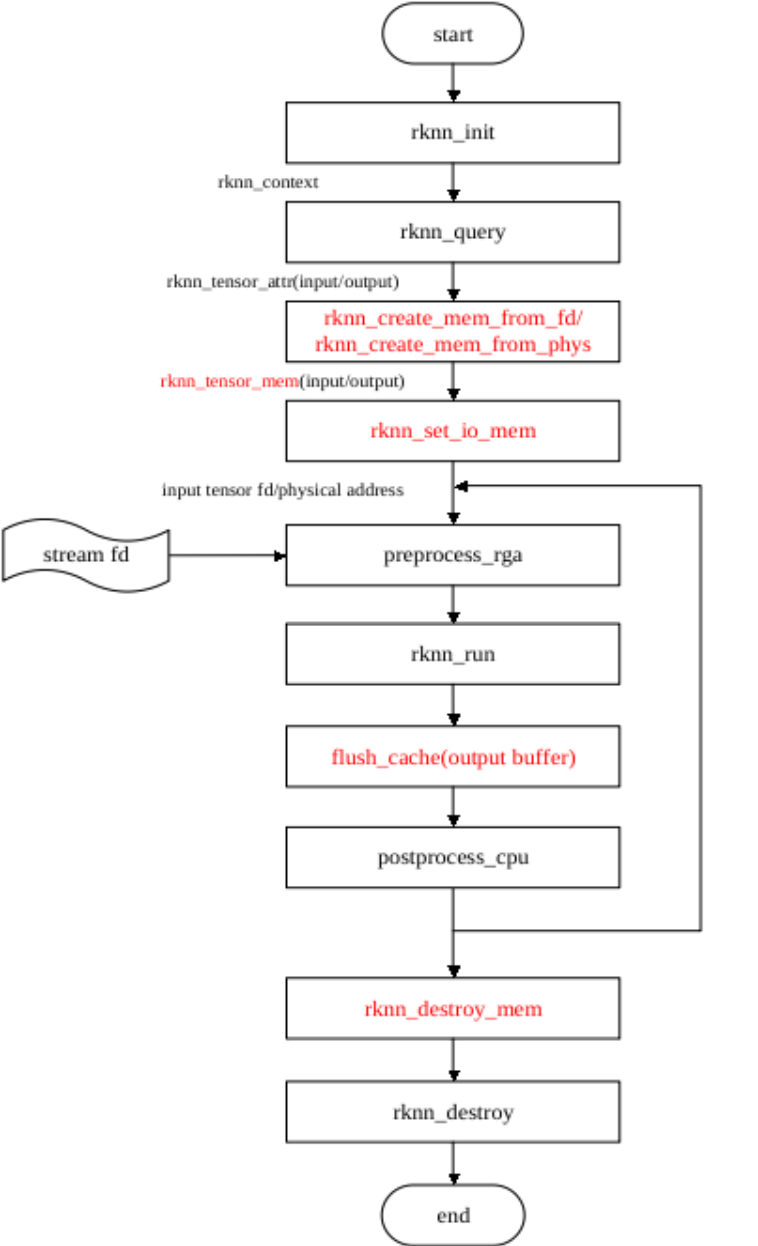
Abbildung 5-8: Zero-Copy-API mit extern allokiertem Ein- und Ausgabespeicher
In Abbildung 5-8 wird externer Speicher mit rknn_create_mem_from_fd()/rknn_create_mem_from_phys() als rknn_tensor_memory eingebunden und mit rknn_set_io_mem() für Ein- und Ausgabe gesetzt. flush_cache bedeutet, dass der Benutzer die zum allokierten Speichertyp passende Schnittstelle zum Flushen des Ausgabecaches aufrufen muss.
3. Ein-/Ausgabe-, Gewichts- und interner Tensorspeicher wird extern allokiert
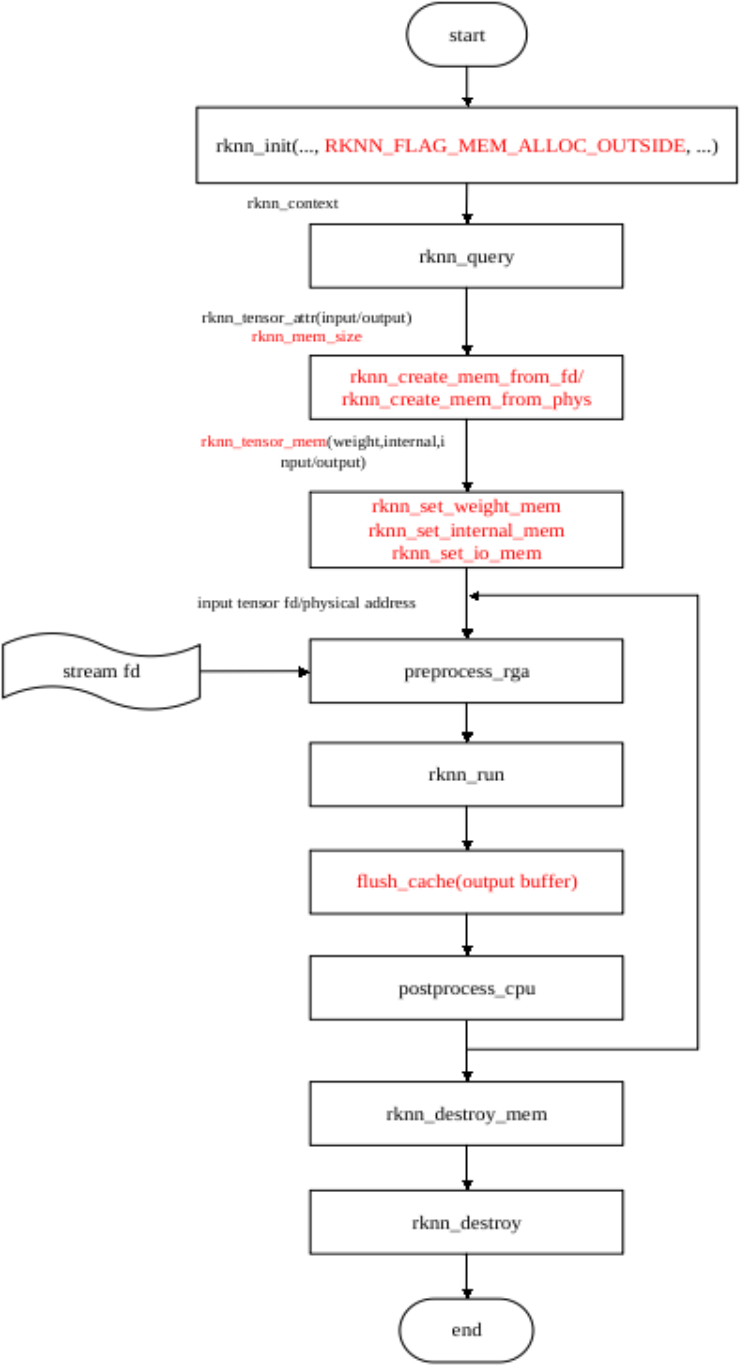
Abbildung 5-9: Zero-Copy-API mit externem Ein-/Ausgabe-, Gewichts- und internem Tensorspeicher
In Abbildung 5-9 wird externer Speicher für Ein-/Ausgaben, Gewichte und interne Ergebnisse mit rknn_create_mem_from_fd()/rknn_create_mem_from_phys() als rknn_tensor_memory eingebunden. rknn_set_io_mem() setzt Ein- und Ausgabe; rknn_set_weight_mem()/rknn_set_internal_mem() setzen Gewichts- und internen Ergebnisspeicher.
5.2.3 Verwendung der Zero-Copy-C-API
Nachfolgend wird der Zero-Copy-Ablauf mit intern allokiertem Ein- und Ausgabespeicher erläutert, den das Original als Abbildung 5-6 bezeichnet:
rknn_query()
Eingabe:
Fragen Sie die Attribute mit RKNN_QUERY_NATIVE_INPUT_ATTR ab, nicht mit RKNN_QUERY_INPUT_ATTR. Die Vorverarbeitung richtet sich nach dem abgefragten Format/Layout. Das so ermittelte Layout und der Typ sind für die Hardware optimal.
Eingabefälle für rknn_query():
1. Bei RKNN_TENSOR_NCHW ist die Eingabe üblicherweise vierdimensional und vom Typ bool oder int64. Auch die an die NPU übertragenen Daten müssen in NCHW vorliegen.
2. Bei RKNN_TENSOR_NHWC ist die Eingabe üblicherweise vierdimensional, vom Typ float32/float16/int8/uint8 und besitzt 1, 3 oder 4 Kanäle. Daten werden in NHWC übertragen. Bei pass_through=1 muss die Breite abhängig vom abgefragten w_stride möglicherweise am Stride ausgerichtet werden.
3. Bei RKNN_TENSOR_NC1HWC2 ist die Eingabe üblicherweise vierdimensional, vom Typ float16/int8 und hat nicht 1, 3 oder 4 Kanäle. Bei pass_through=0 liegen die Daten in NHWC vor; die Schnittstelle konvertiert sie auf der CPU nach NC1HWC2. Bei pass_through=1 müssen sie in NC1HWC2 vorliegen, und der Benutzer muss extern konvertieren.
4. Bei RKNN_TENSOR_UNDEFINED ist die Eingabe üblicherweise nicht vierdimensional. Die Daten werden gemäß dem Eingabeformat des ONNX-Modells an die NPU übergeben. Die NPU führt weder mean/std-Verarbeitung noch Layoutkonvertierung aus.
Weicht die benötigte Eingabekonfiguration von der abgefragten rknn_tensor_attr-Struktur ab, kann sie geändert werden. Unterstützte Typänderungen stehen in Tabelle 5-3. Wichtig: Wird uint8 abgefragt, aber float32 benötigt, muss size vervierfacht und der Typ auf RKNN_TENSOR_FLOAT32 geändert werden. Diese Konfiguration ist nicht hardwareoptimal; die Schnittstelle verwendet intern die CPU zur Typkonvertierung.
Tabelle 5-3: Änderbare Eingabedatentypen
| Mit rknn_query ermittelter Eingabedatentyp | |||||||
|---|---|---|---|---|---|---|---|
| bool | int8 | float16 | int16 | int32 | int64 | ||
| Vom Benutzer geänderter Eingabedatentyp | bool | Y | |||||
| int8 | Y | ||||||
| uint8 | Y | Y | |||||
| float32 | Y | Y | |||||
| float16 | Y | ||||||
| int16 | Y | ||||||
| int32 | Y | ||||||
| int64 | Y |
Ausgabe:
Fragen Sie die Attribute mit RKNN_QUERY_NATIVE_OUTPUT_ATTR ab, nicht mit RKNN_QUERY_OUTPUT_ATTR. Die Verarbeitung richtet sich nach dem abgefragten Format/Layout. Das so ermittelte Layout und der Typ sind für die Hardware optimal.
Für eine vierdimensionale Ausgabe im NHWC-Layout verwenden Sie RKNN_QUERY_NATIVE_NHWC_OUTPUT_ATTR. Damit wird das native NHWC-Ausgabelayout der NPU direkt abgefragt.
Ausgabefälle für rknn_query():
1. Bei RKNN_TENSOR_NC1HWC2 ist die Ausgabe üblicherweise vierdimensional; der
Datentyp ist float16/int8. Wird NCHW benötigt, muss NC1HWC2 extern nach NCHW konvertiert werden.
2. Bei RKNN_TENSOR_UNDEFINED ist die Ausgabe üblicherweise nicht vierdimensional; der
Datentyp ist float16/int8. Eine externe Layoutkonvertierung ist nicht erforderlich.
3. Bei RKNN_TENSOR_NCHW ist die Ausgabe üblicherweise vierdimensional und vom Typ
float16/int8. Eine externe Layoutkonvertierung ist nicht erforderlich.
4. Bei RKNN_TENSOR_NHWC ist die Ausgabe üblicherweise vierdimensional und vom Typ
float16/int8. Dies entsteht üblicherweise durch eine Layoutabfrage mit RKNN_QUERY_NATIVE_NHWC_OUTPUT_ATTR.
Weicht die benötigte Ausgabe von der abgefragten rknn_tensor_attr-Struktur ab, kann diese gemäß Tabelle 5-4 und 5-5 geändert werden. Wichtig: Ist der Ausgabetyp int8, aber float32 gewünscht, muss size vervierfacht und der Typ auf RKNN_TENSOR_FLOAT32 geändert werden. Diese Änderung ist nicht hardwareoptimal; die Schnittstelle konvertiert den Typ intern auf der CPU.
Tabelle 5-4: Änderbare Ausgabedatentypen
| Mit rknn_query ermittelter Ausgabedatentyp | |||||||
|---|---|---|---|---|---|---|---|
| bool | int8 | float16 | int16 | int32 | int64 | ||
| Vom Benutzer geänderter Ausgabedatentyp | bool | Y | |||||
| int8 | Y | ||||||
| uint8 | |||||||
| float32 | Y | Y | |||||
| float16 | Y | ||||||
| int16 | Y | ||||||
| int32 | Y | ||||||
| int64 | Y |
Tabelle 5-5: Ausgabelayouttypen
| Mit rknn_query ermitteltes Ausgabelayout | |||||
|---|---|---|---|---|---|
| NC1HWC2 | NCHW | NHWC | UNDEFINED | ||
| Vom Benutzer festgelegtes Ausgabelayout | NC1HWC2 | Y | |||
| NCHW | Y | Y | |||
| NHWC | Y | ||||
| UNDEFINED | Y |
Die Zero-Copy-NPU-Ausgabekonfigurationen für RK3562/RK3566/RK3568/RK3576/RK3588/RV1126B stehen in Tabelle 5-6, diejenigen für RV1103/RV1103B/RV1106/RV1106B in Tabelle 5-7.
Tabelle 5-6: Zero-Copy-NPU-Ausgabekonfigurationen für RK3562/RK3566/RK3568/RK3576/RK3588/RV1126B
| Modelltyp | Ausgabedatentyp | Ausgangsdimensionen | Unterstütztes Ausgabelayout |
|---|---|---|---|
| int8-Modell | int8/float16/float32 | 4 Dimensionen | NCHW/NC1HWC2/NHWC |
| Nicht 4 Dimensionen | UNDEFINE | ||
| float16-Modell | float16/float32 | 4 Dimensionen | NCHW/NC1HWC2/NHWC |
| Nicht 4 Dimensionen | UNDEFINE |
Tabelle 5-7: Zero-Copy-NPU-Ausgabekonfigurationen für RV1103/RV1103B/RV1106/RV1106B
| Model type | Output data type | Output dimensions | Supported output layout |
|------------|------------------|-------------------|-------------------------|
| int8 Model | int8/float16 | 4 dimensions | NCHW/NC1HWC2/NHWC |
| | | Not 4 dimensions | UNDEFINE |
rknn_create_mem
Die Zero-Copy-API verwendet rknn_tensor_memory: Vor der Inferenz wird die Struktur erstellt und gesetzt, danach werden ihre Speicherinformationen gelesen. Bleiben Layout und Typ aus RKNN_QUERY_NATIVE_INPUT_ATTR/RKNN_QUERY_NATIVE_OUTPUT_ATTR unverändert, wird die Speichergröße direkt aus size_with_stride übernommen. Bei Änderungen von Layout oder Typ muss sie entsprechend angepasst werden. Beispielsweise ist für float32 statt int8-Ausgabe die vierfache Größe erforderlich.
rknn_set_io_mem
rknn_set_io_mem() setzt rknn_tensor_mem mit den Ein-/Ausgabespeicherinformationen des Modells. Wie rknn_init() muss es nur einmal zu Beginn aufgerufen werden; anschließend wird rknn_run() wiederholt ausgeführt.
5.3 Mehrkern-NPU konfigurieren
RK3588 bietet höhere Rechenleistung durch 3 NPU-Kerne, RK3576 durch 2. Dieser Abschnitt erläutert die Konfiguration der Mehrkern-NPU zur Verbesserung der Inferenzeffizienz.
Hinweis: Mehrkernbetrieb eignet sich für rechenintensive Netze. Kleine Netze profitieren wenig; das Umschalten zwischen Einzel- und Mehrkernbetrieb kann die Leistung sogar verschlechtern, da dafür CPU-Eingriffe nötig sind.
5.3.1 Mehrkernbetrieb konfigurieren
In Python-Anwendungen werden die NPU-Kerne für die Modellausführung über core_mask in init_runtime() von RKNN-Toolkit2 oder RKNN-Toolkit Lite2 festgelegt. Ausführliche Parameterbeschreibung:
In Python-Anwendungen werden die NPU-Kerne für die Modellausführung über core_mask in init_runtime() von RKNN-Toolkit2 oder RKNN-Toolkit Lite2 festgelegt. Ausführliche Parameterbeschreibung:
Tabelle 5-8: Parameter core_mask der Schnittstelle init_runtime
| Parameter | Beschreibung |
|---|---|
| core_mask | NPU-Kerne für die Modellausführung festlegen. Unterstützt werden: - NPU_CORE_AUTO: automatische Auswahl eines freien NPU-Kerns - NPU_CORE_0: Ausführung auf NPU0 - NPU_CORE_1: Ausführung auf NPU1 - NPU_CORE_2: Ausführung auf NPU2 - NPU_CORE_0_1: Ausführung auf NPU0 und NPU1 gleichzeitig - NPU_CORE_0_1_2: Ausführung auf NPU0, NPU1 und NPU2 gleichzeitig - NPU_CORE_ALL: Auswahl der Anzahl verwendeter NPU-Kerne abhängig von der Plattform Standardwert NPU_CORE_AUTO. Hinweis: In RKNN-Toolkit Lite2 muss dem Wert RKNNLite vorangestellt werden, beispielsweise RKNNLite.NPU_CORE_AUTO; in RKNN-Toolkit2 RKNN, beispielsweise RKNN.NPU_CORE_AUTO. |
NPU-Kern in RKNN-Toolkit2 einstellen, Beispiel:
# Init runtime environment
print('--> Init runtime environment')
ret = rknn.init_runtime(target='rk3588', core_mask=RKNN.NPU_CORE_0)
if ret != 0:
  print('Init runtime environment failed!')
  exit(ret)
print('done')
NPU-Kern in RKNN-Toolkit Lite2 einstellen, Beispiel:
......
# Init runtime environment
print('--> Init runtime environment')
ret = rknn_lite.init_runtime(core_mask=RKNNLite.NPU_CORE_0)
if ret != 0:
  print('Init runtime environment failed')
  exit(ret)
print('done')
......
In C/C++-Anwendungen wird der NPU-Kern für die Modellausführung mit rknn_set_core_mask() festgelegt. Beschreibung von core_mask:
Tabelle 5-9: Parameter core_mask der Schnittstelle rknn_set_core_mask
| Parameter | Beschreibung |
|---|---|
| core_mask | NPU-Kerne für die Modellausführung festlegen. Unterstützt werden: - RKNN_NPU_CORE_AUTO: automatische Auswahl eines freien NPU-Kerns - RKNN_NPU_CORE_0: Ausführung auf NPU0 - RKNN_NPU_CORE_1: Ausführung auf NPU1 - RKNN_NPU_CORE_2: Ausführung auf NPU2 - RKNN_NPU_CORE_0_1: Ausführung auf NPU0 und NPU1 gleichzeitig - RKNN_NPU_CORE_0_1_2: Ausführung auf NPU0, NPU1 und NPU2 gleichzeitig - RKNN_NPU_CORE_ALL: Auswahl der Anzahl verwendeter NPU-Kerne abhängig von der Plattform |
Beispiel zur NPU-Kernkonfiguration über die C/C++-API:
// rknn_context ctx;
rknn_core_mask core_mask = RKNN_NPU_CORE_0;
int ret = rknn_set_core_mask(ctx, core_mask);
5.3.2 Mehrkern-Ausführungsstatus prüfen
Dieser Abschnitt erläutert das Verhalten des RKNN-Modells im Mehrkernmodus.
Für Inferenz auf einem angeschlossenen RKNPU-Gerät mit RKNN-Toolkit2 setzen Sie perf_debug beim Aufruf von rknn.init_runtime() auf True und rufen anschließend rknn.eval_perf() für schichtweise Laufzeitinformationen auf. Beispiel:
# Init runtime environment
ret = rknn.init_runtime(target='rk3588', device_id='29d5dd97766a5c27', perf_debug=True)
if ret != 0:
  print('Init runtime environment failed!')
  exit(ret)

# Eval performance
rknn.eval_perf()
Bei direkter Ausführung auf dem Gerät setzen Sie vor dem Anwendungsstart RKNN_LOG_LEVEL auf 4 oder höher. Dadurch werden Informationen zu jeder Schicht ausgegeben. Einstellung:
# Using the python interface provided by RKNN-Toolkit Lite2, just set verbose to True when creating the RKNNLite object.
rknnlite = RKNNLite(verbose=True)

# Using the C/C++ interface, you need to set the following environment variables before running the binary program
export RKNN_LOG_LEVEL=4
Für das lenet-Modell erscheint nach diesen Einstellungen ein Protokoll wie unten. Zur übersichtlichen Darstellung wurden unter anderem InputShape, OutputShape, DDR Cycles, NPU Cycles, Total Cycles, Time(us), MacUsage(%), Task Number, Lut Number, RW(kb) und FullName entfernt:
ID OpType DataType Target WorkLoad(0/1/2)-ImproveTherical
1 InputOperator UINT8 CPU 100.0%/0.0%/0.0% - Up:0.0%
2 Conv UINT8 NPU 50.0%/50.0%/0.0% - Up:50.0%
3 MaxPool INT8 NPU 100.0%/0.0%/0.0% - Up:0.0%
4 Conv INT8 NPU 50.0%/50.0%/0.0% - Up:50.0%
5 MaxPool INT8 NPU 100.0%/0.0%/0.0% - Up:0.0%
6 ConvRelu INT8 NPU 48.1%/51.9%/0.0% - Up:48.1%
7 Conv INT8 NPU 100.0%/0.0%/0.0% - Up:0.0%
8 Softmax INT8 CPU 0.0%/0.0%/0.0% - Up:0.0%
9 OutputOperator FLOAT16 CPU 0.0%/0.0%/0.0% - Up:0.0%
Total Operator Elapsed Time(us): 591
Total Memory RW Amount(MB): 0
Die Spalte WorkLoad(0/1/2)-ImproveTherical erscheint nur bei Mehrkern-NPUs. Sie beschreibt die Aufgabenverteilung jeder Schicht auf die Kerne und die theoretische Leistungsverbesserung. „50.0%/50.0%/0.0% - Up:50.0%“ bedeutet beispielsweise 50% Berechnung auf Core0 und 50% auf Core1 sowie theoretisch 50% Verbesserung gegenüber Einzelkernbetrieb. Ohne Verbesserung, etwa „100.0%/0.0%/0.0% - Up:0.0%“, kommen folgende Ursachen infrage:
Die Schichtlast liegt unter der Granularität der Mehrkern-Aufgabenverteilung; deshalb läuft die Schicht auf einem Kern.
Der NPU-Treiber implementiert für diesen Operatortyp noch keine Mehrkern-Aufteilung; Unterstützung ist für spätere Versionen vorgesehen. Das Original nennt folgende bereits unterstützte Operatoren: Conv, DepthwiseConvolution, Add, Concat, Relu, Clip, Relu6, ThresholdedRelu, PRelu und LeakyRelu.
5.3.3 Mehrkernleistung verbessern
Zur Leistungsverbesserung können Sie Folgendes versuchen:
CPU-/DDR-/NPU-Frequenzen auf das Maximum setzen.
Die Anwendung an einen großen CPU-Kern binden.
Den NPU-Interrupt an denselben großen CPU-Kern binden.
Die Befehle zum Fixieren der Frequenz unterscheiden sich je nach Firmware; siehe Abschnitt 8.1.1.
Für die letzten beiden Punkte zeigt folgendes Skript die Bindung an CPU4:
interrupts=$(cat /proc/interrupts | grep npu)
interrupts_array=($interrupts)

irq1=$(echo ${interrupts_array[0]} | awk -F ':' '{print $1}')
irq2=$(echo ${interrupts_array[14]} | awk -F ':' '{print $1}')
irq3=$(echo ${interrupts_array[28]} | awk -F ':' '{print $1}')

for irq in $irq1 $irq2 $irq3; do
 echo 4 > /proc/irq/$irq/smp_affinity_list
done

taskset 10 ./rknn_benchmark lenet.rknn "" 10 3 # The taskset mask value corresponding to CPU4 is 0x10
Das Skript führt folgende Schritte aus:
Führt cat /proc/interrupts | grep npu aus und extrahiert drei Interruptnummern ohne Doppelpunkte.
Setzt in einer Schleife smp_affinity_list jedes Interrupts auf 4, die ID von CPU4.
Führt taskset 10 ./rknn_benchmark lenet.rknn "" 10 3 aus. Der taskset-Parameter für CPU4 ist 10. Zur Verwendung von taskset siehe https://man7.org/linux/man-pages/man1/taskset.1.html.
Damit laufen NPU-Interrupt und rknn_benchmark auf CPU4; der Kernwechselaufwand bei der NPU-Interruptverarbeitung entfällt.
5.4 Dynamische Form
5.4.1 Einführung in dynamische Formen
Dynamische Formen erlauben Änderungen der Eingabeform zur Laufzeit und erhöhen die Flexibilität bei variablen Datengrößen. Als RKNN nur statische Formen unterstützte, waren für mehrere Eingabeformen separate Modelle und Inferenzkontexte erforderlich. Mit dynamischen Formen genügt ein RKNN-Modell ähnlicher Größe wie das statische sowie ein Kontext; dies spart Flash und DDR. Das ist insbesondere für Bildverarbeitung und Sequenzmodelle wichtig. Typische Anwendungen:
Variable Sequenzlängen, etwa in NLP-Modellen wie BERT und GPT.
Variable räumliche Dimensionen, etwa bei Segmentierung und Stilübertragung.
Variable Batch-Dimensionen in Batch-Modellen.
Objekterkennungsmodelle mit variabler Ausgabeanzahl.
5.4.2 Anforderungen an RKNN-SDK-Version und Plattform
RKNN-Toolkit2-Version >=1.5.0
Version der RKNPU-Runtime-Bibliothek (librknnrt.so) >=1.5.0
Die Funktion wird auf RK3562/RK3566/RK3568/RK3576/RK3588/RV1126B unterstützt.
5.4.3 RKNN-Modell mit dynamischer Form erzeugen
Erstellen eines Modells mit dynamischer Form über die Python-Schnittstelle von RKNN-Toolkit2:
1. Prüfen, ob das Modell dynamische Formen unterstützt.
RKNN-Toolkit2 kann ein statisches Modell um dynamische Formen erweitern. Prüfen Sie zunächst, ob Operatoren oder Teilgraphen die Formänderung einschränken. Beispielsweise lässt sich die Form einer Konstante nicht ändern; das Werkzeug meldet dann einen Konvertierungsfehler. Ist die Erweiterung nicht möglich, ändern Sie die Struktur anhand der Fehlermeldung und trainieren das Modell neu. Empfohlen wird ein bereits dynamisches Ausgangsmodell.
2. Die zu verwendenden Eingabeformen festlegen.
Aufgrund der NPU-Hardware sind keine beliebigen Eingabeformen möglich; eine begrenzte Anzahl muss vorgegeben werden. Bei Modellen mit mehreren Eingaben muss die Anzahl der Formen je Eingabe übereinstimmen. Python-Beispiel für die Konvertierung eines Caffe-Modells:
dynamic_input = [
  [[1,3,224,224]], # set the first shape for all inputs
  [[1,3,192,192]], # set the second shape for all inputs
  [[1,3,160,160]], # set the third shape for all inputs
]

# Pre-process config
rknn.config(mean_values=[103.94, 116.78, 123.68], std_values=[58.82, 58.82, 58.82],
      quant_img_RGB2BGR=True, dynamic_input=dynamic_shapes)
Die Konfiguration erzeugt ein Modell mit drei Formen: [1,3,224,224], [1,3,192,192] und [1,3,160,160]. Die Formen in dynamic_input entsprechen dem Layout des ursprünglichen Frameworks. Für RGB-Klassifikationsbilder der Größe 224x224 hat TensorFlow/TFLite die Eingabe [1,224,224,3], ONNX dagegen [1,3,224,224].
3. Quantisierung
Nach dem Festlegen der Formen wird für die Quantisierung ein Kalibrierungsdatensatz benötigt. Das Werkzeug verwendet die Formgruppe mit der größten Summe aller Eingabegrößen. Beispielsweise besitzt die erste Eingabe [1,224] und [1,112], die zweite [1,40] und [1,80]. Im Original stehen die Summen als „1224+140=264“ und „1112+180=192“ ohne sichtbare Multiplikationszeichen; diese auffällige Schreibweise bleibt erhalten. Die erste Gruppe ist größer, daher werden [1,224] und [1,40] quantisiert.
Bei Kalibrierungsdaten im jpg/png-Format sind verschiedene Auflösungen möglich: Vor der Quantisierung skaliert opencv resize das Bild auf die maximale Auflösung.
Bei npy muss die Eingabeform mit maximaler Auflösung verwendet werden. Nach der Quantisierung nutzen alle Formen des Modells dieselben Quantisierungsparameter bei der Inferenz.
Die maximale Eingabeform wird außerdem beim Aufruf von rknn.config ausgegeben:
W config: The 'dynamic_input' function has been enabled, the MaxShape is dynamic_input[0] = [[1,224],[1,40]]!
The following functions are subject to the MaxShape:
1. The quantified dataset needs to be configured according to MaxShape
2. The eval_perf or eval_memory return the results of MaxShape
4. Inferenz oder Genauigkeitsanalyse
Für Inferenz oder Genauigkeitsanalyse verwenden Sie eine der in Schritt 2 festgelegten Formgruppen. Die Schnittstellen entsprechen denen statischer RKNN-Modelle und werden hier nicht erneut beschrieben.
Vollständiges Beispiel für dynamische Formen: https://github.com/airockchip/rknn-toolkit2/tree/master/rknn-toolkit2/examples/functions/dynamic_shape
5.4.4 Bereitstellung über die C-API
Stellen Sie das erzeugte Modell mit dynamischer Form über die RKNPU2-C-API bereit. Je nach Schnittstelle erfolgt dies über die allgemeine API oder Zero-Copy-API.
5.4.4.1 Allgemeine API
Bereitstellungsablauf eines dynamischen Modells über die allgemeine API:
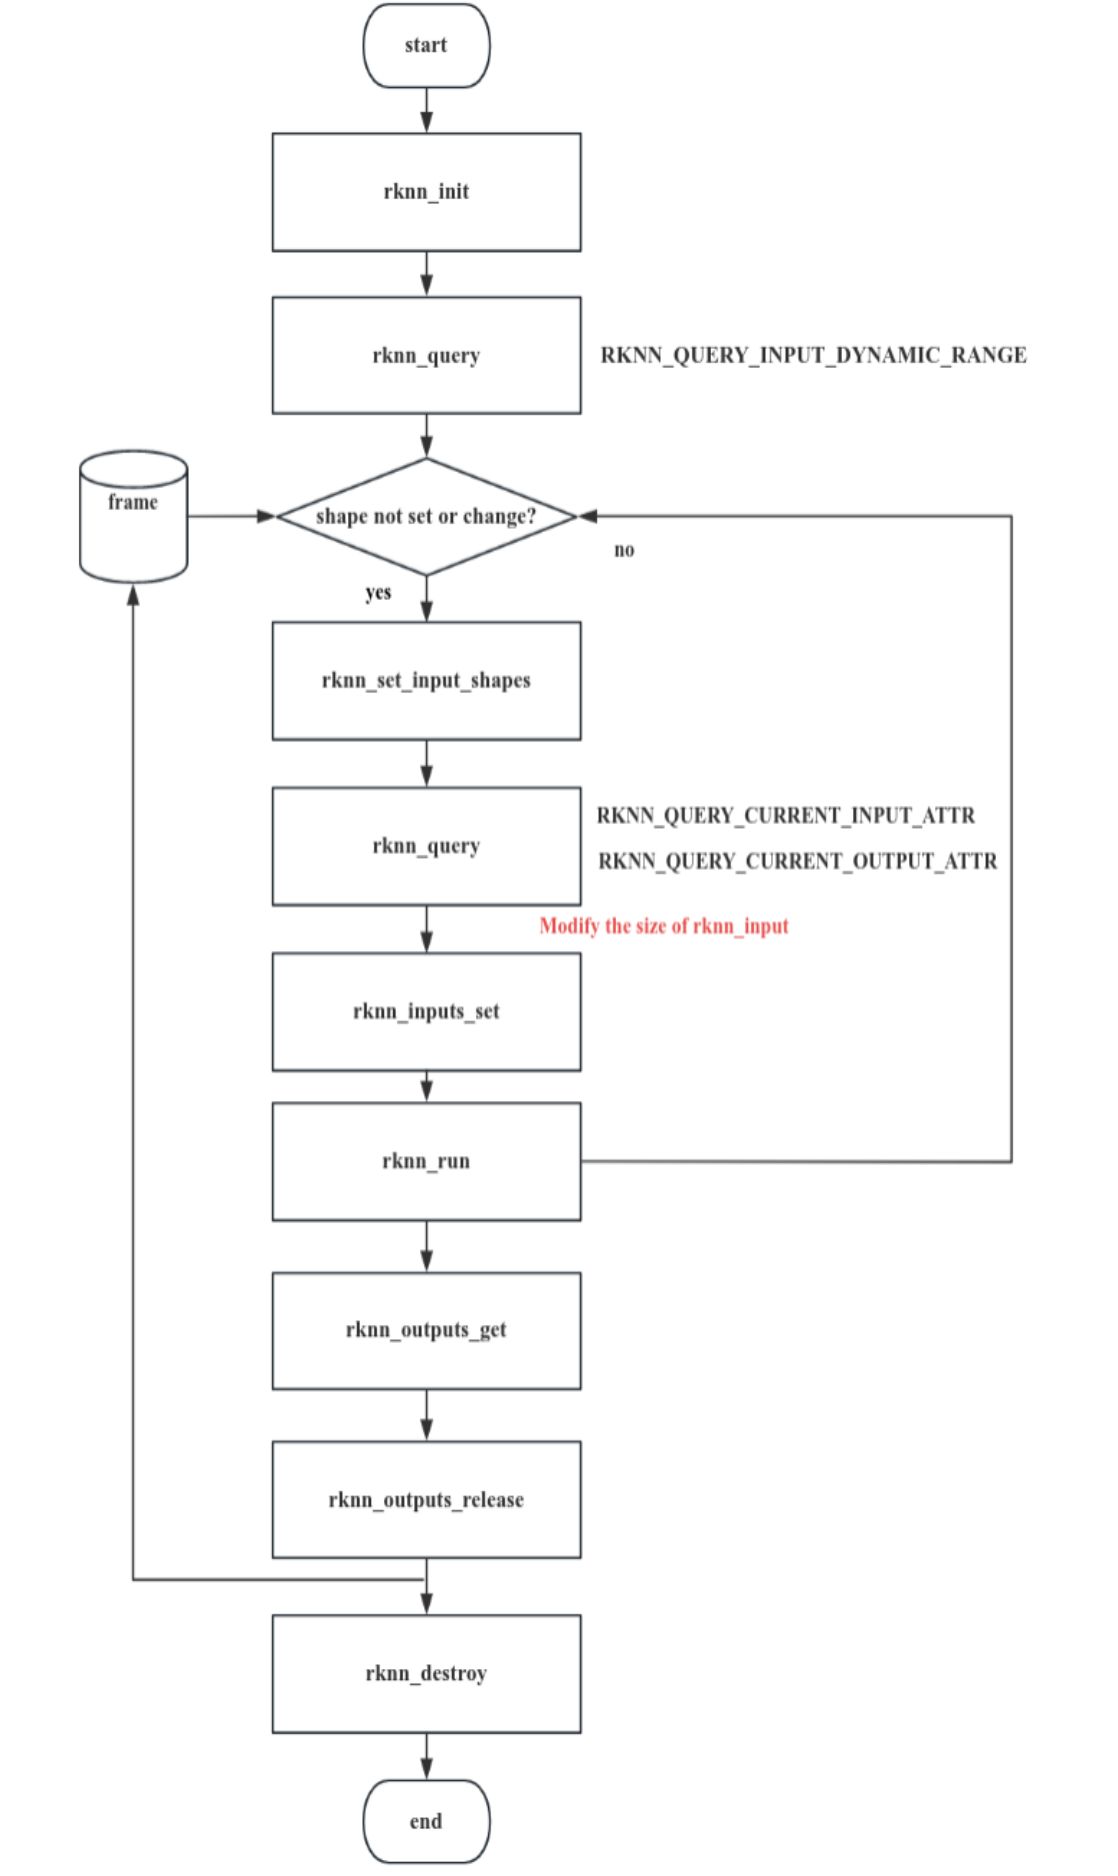
Abbildung 5-10: Aufrufablauf der allgemeinen API für dynamische Eingabeformen
Nach dem Laden kann die Eingabeform zur Laufzeit geändert werden. rknn_query() liefert die unterstützten Formen jeder Eingabe als rknn_input_range mit Name, Layout, Anzahl und konkreten Formen. Anschließend setzt rknn_set_input_shapes() mit einem Zeiger auf das rknn_tensor_attr-Array aller Eingaben die aktuelle Form. Mit einem erneuten rknn_query() lassen sich danach Ein- und Ausgabeformen abfragen.
Führen Sie anschließend die Inferenz gemäß dem allgemeinen API-Ablauf aus. Bei jedem Formwechsel setzen Sie die neue Form, bereiten passende Daten vor und rufen rknn_inputs_set() erneut auf. Ohne Formwechsel ist kein wiederholter Aufruf von rknn_set_input_shapes() nötig.
1. Initialisierung
Initialisieren Sie das dynamische RKNN-Modell mit rknn_init().
Für die Kontextinitialisierung gelten folgende Einschränkungen:
Gemeinsame Gewichtsnutzung mit dem Flag RKNN_FLAG_SHARE_WEIGHT_MEM wird nicht unterstützt.
Kontextwiederverwendung wird nicht unterstützt; siehe rknn_dup_context.
2. Unterstützte Eingabeformen des RKNN-Modells abfragen
Nach der Initialisierung liefert rknn_query() die Formliste jeder Eingabe als rknn_input_range mit Name, Layout, Anzahl und konkreten Formen. C-Beispiel:
// Query the input shape supported by the model
rknn_input_range dyn_range[io_num.n_input];
memset(dyn_range, 0, io_num.n_input * sizeof(rknn_input_range));
for (uint32_t i = 0; i < io_num.n_input; i++)
{
  dyn_range[i].index = i;
  ret = rknn_query(ctx, RKNN_QUERY_INPUT_DYNAMIC_RANGE, &dyn_range[i],
sizeof(rknn_input_range));
  if (ret != RKNN_SUCC)
  {
    fprintf(stderr, "rknn_query error! ret=%d\n", ret);
    return -1;
  }
  dump_input_dynamic_range(&dyn_range[i]);
}
Hinweis: Bei Modellen mit mehreren Eingaben entsprechen sich die Formen positionsweise. Die erste Form der ersten Eingabe wird mit der ersten Form der zweiten kombiniert; gekreuzte Kombinationen sind nicht zulässig. Hat beispielsweise A die Formen [1,224] und [1,112], B die Formen [1,40] und [1,80], sind nur folgende Kombinationen unterstützt:
Form A = [1,224], Form B=[1,40]
Form A = [1,112], Form B=[1,80]
3. Eingabeform setzen
Beim ersten Setzen der Eingabedaten oder einem Formwechsel rufen Sie rknn_set_input_shapes() auf. Nach dem Laden des dynamischen Modells ändert diese Schnittstelle die Form zur Laufzeit. Übergeben Sie ein rknn_tensor_attr-Array für alle Eingaben; dims, n_dims und fmt jedes Elements beschreiben die aktuelle Inferenzform. C-Beispiel:
/**
 dynamic inputs shape range:
 index=0, name=data, shape_number=2, range=[[1, 224, 224, 3],[1, 112, 224, 3]], fmt = NHWC
**/
input_attrs[0].dims[0] = 1;
input_attrs[0].dims[1] = 224;
input_attrs[0].dims[2] = 224;
input_attrs[0].dims[3] = 3;
input_attrs[0].fmt=RKNN_TENSOR_NHWC;
ret = rknn_set_input_shapes(ctx, io_num.n_input, input_attrs);
if (ret < 0) {
  fprintf(stderr, "rknn_set_input_shapes error! ret=%d\n", ret);
  return -1;
}
Dabei ist io_num.n_input die Eingabeanzahl und input_attrs das rknn_tensor_attr-Array der Modelleingaben.
Hinweis: Die gesetzte Form muss in der in Schritt 2 abgefragten Liste enthalten sein.
Nach dem Setzen der Form können Sie mit rknn_query die aktuellen Ein- und Ausgabeformen abfragen. C-Beispiel:
// Get the input and output shape of the current inference
rknn_tensor_attr cur_input_attrs[io_num.n_input];
memset(cur_input_attrs, 0, io_num.n_input * sizeof(rknn_tensor_attr));
for (uint32_t i = 0; i < io_num.n_input; i++)
{
  cur_input_attrs[i].index = i;
  ret = rknn_query(ctx, RKNN_QUERY_CURRENT_INPUT_ATTR, &(cur_input_attrs[i]),
sizeof(rknn_tensor_attr));
  if (ret < 0)
  {
    printf("rknn_init error! ret=%d\n", ret);
    return -1;
  }
  dump_tensor_attr(&cur_input_attrs[i]);
}

rknn_tensor_attr cur_output_attrs[io_num.n_output];
memset(cur_output_attrs, 0, io_num.n_output * sizeof(rknn_tensor_attr));
for (uint32_t i = 0; i < io_num.n_output; i++)
{
  cur_output_attrs[i].index = i;
  ret = rknn_query(ctx, RKNN_QUERY_CURRENT_OUTPUT_ATTR, &(cur_output_attrs[i]),
sizeof(rknn_tensor_attr));
  if (ret != RKNN_SUCC)
  {
    printf("rknn_query fail! ret=%d\n", ret);
    return -1;
  }
  dump_tensor_attr(&cur_output_attrs[i]);
}
Hinweis:
rknn_set_input_shapes verlangt einen vierdimensionalen Tensor mit fmt=NHWC oder einen nicht vierdimensionalen mit fmt=UNDEFINED.
Vor dem Aufruf von rknn_set_input_shapes sind Forminformationen aus Befehlen mit dem Präfix RKNN_QUERY_CURRENT ungültig.
4. Inferenz
Nach dem Setzen der aktuellen Form seien die Eingabetensorinformationen in cur_input_attrs gespeichert. C-Beispiel für die allgemeine API:
// Set input information
rknn_input inputs[io_num.n_input];
memset(inputs, 0, io_num.n_input * sizeof(rknn_input));
for (int i = 0; i < io_num.n_input; i++)
{
  int height = cur_input_attrs[i].fmt == RKNN_TENSOR_NHWC ? cur_input_attrs[i].dims[1] :
cur_input_attrs[i].dims[2];
  int width = cur_input_attrs[i].fmt == RKNN_TENSOR_NHWC ? cur_input_attrs[i].dims[2] :
cur_input_attrs[i].dims[3];
  cv::resize(imgs[i], imgs[i], cv::Size(width, height));
  inputs[i].index = i;
  inputs[i].pass_through = 0;
  inputs[i].type = RKNN_TENSOR_UINT8;
  inputs[i].fmt = RKNN_TENSOR_NHWC;
  inputs[i].buf = imgs[i].data;
  inputs[i].size = imgs[i].total() * imgs[i].channels();
}

// After converting the input data into the correct format, put it into the input buffer
ret = rknn_inputs_set(ctx, io_num.n_input, inputs);
if (ret < 0)
{
  printf("rknn_input_set fail! ret=%d\n", ret);
  return -1;
}

// Inferences
printf("Begin perf ...\n");
double total_time = 0;
for (int i = 0; i < loop_count; ++i)
{
  int64_t start_us = getCurrentTimeUs();
  ret = rknn_run(ctx, NULL);
  int64_t elapse_us = getCurrentTimeUs() - start_us;
  if (ret < 0)
  {
    printf("rknn run error %d\n", ret);
    return -1;
  }
  total_time += elapse_us / 1000.f;
  printf("%4d: Elapse Time = %.2fms, FPS = %.2f\n", i, elapse_us / 1000.f, 1000.f * 1000.f / elapse_us);
}
printf("Avg FPS = %.3f\n", loop_count * 1000.f / total_time);

// Get output results
rknn_output outputs[io_num.n_output];
memset(outputs, 0, io_num.n_output * sizeof(rknn_output));
for (uint32_t i = 0; i < io_num.n_output; ++i)
{
  outputs[i].want_float = 1;
  outputs[i].index = i;
  outputs[i].is_prealloc = 0;
}

ret = rknn_outputs_get(ctx, io_num.n_output, outputs, NULL);
if (ret < 0)
{
  printf("rknn_outputs_get fail! ret=%d\n", ret);
  return ret;
}

//Release the output buffer
ret = rknn_outputs_release(ctx, io_num.n_output, outputs);
5.4.4.2 Zero-Copy-API
Fragen Sie bei der Zero-Copy-API nach der Initialisierung die Formen mit rknn_query() ab und allokieren Sie Ein- und Ausgabespeicher mit rknn_create_mem(). Setzen Sie anschließend die aktuelle Form über rknn_set_input_shapes() mit dem rknn_tensor_attr-Array aller Eingabeformen. Fragen Sie die gesetzten Ein- und Ausgabeformen erneut mit rknn_query() ab und konfigurieren Sie den Speicher mit rknn_set_io_mem(). Bei jedem Formwechsel setzen Sie die Form, bereiten Daten vor und rufen rknn_set_io_mem() erneut auf. Ohne Formwechsel ist kein wiederholtes rknn_set_input_shapes() nötig. Typischer Ablauf:
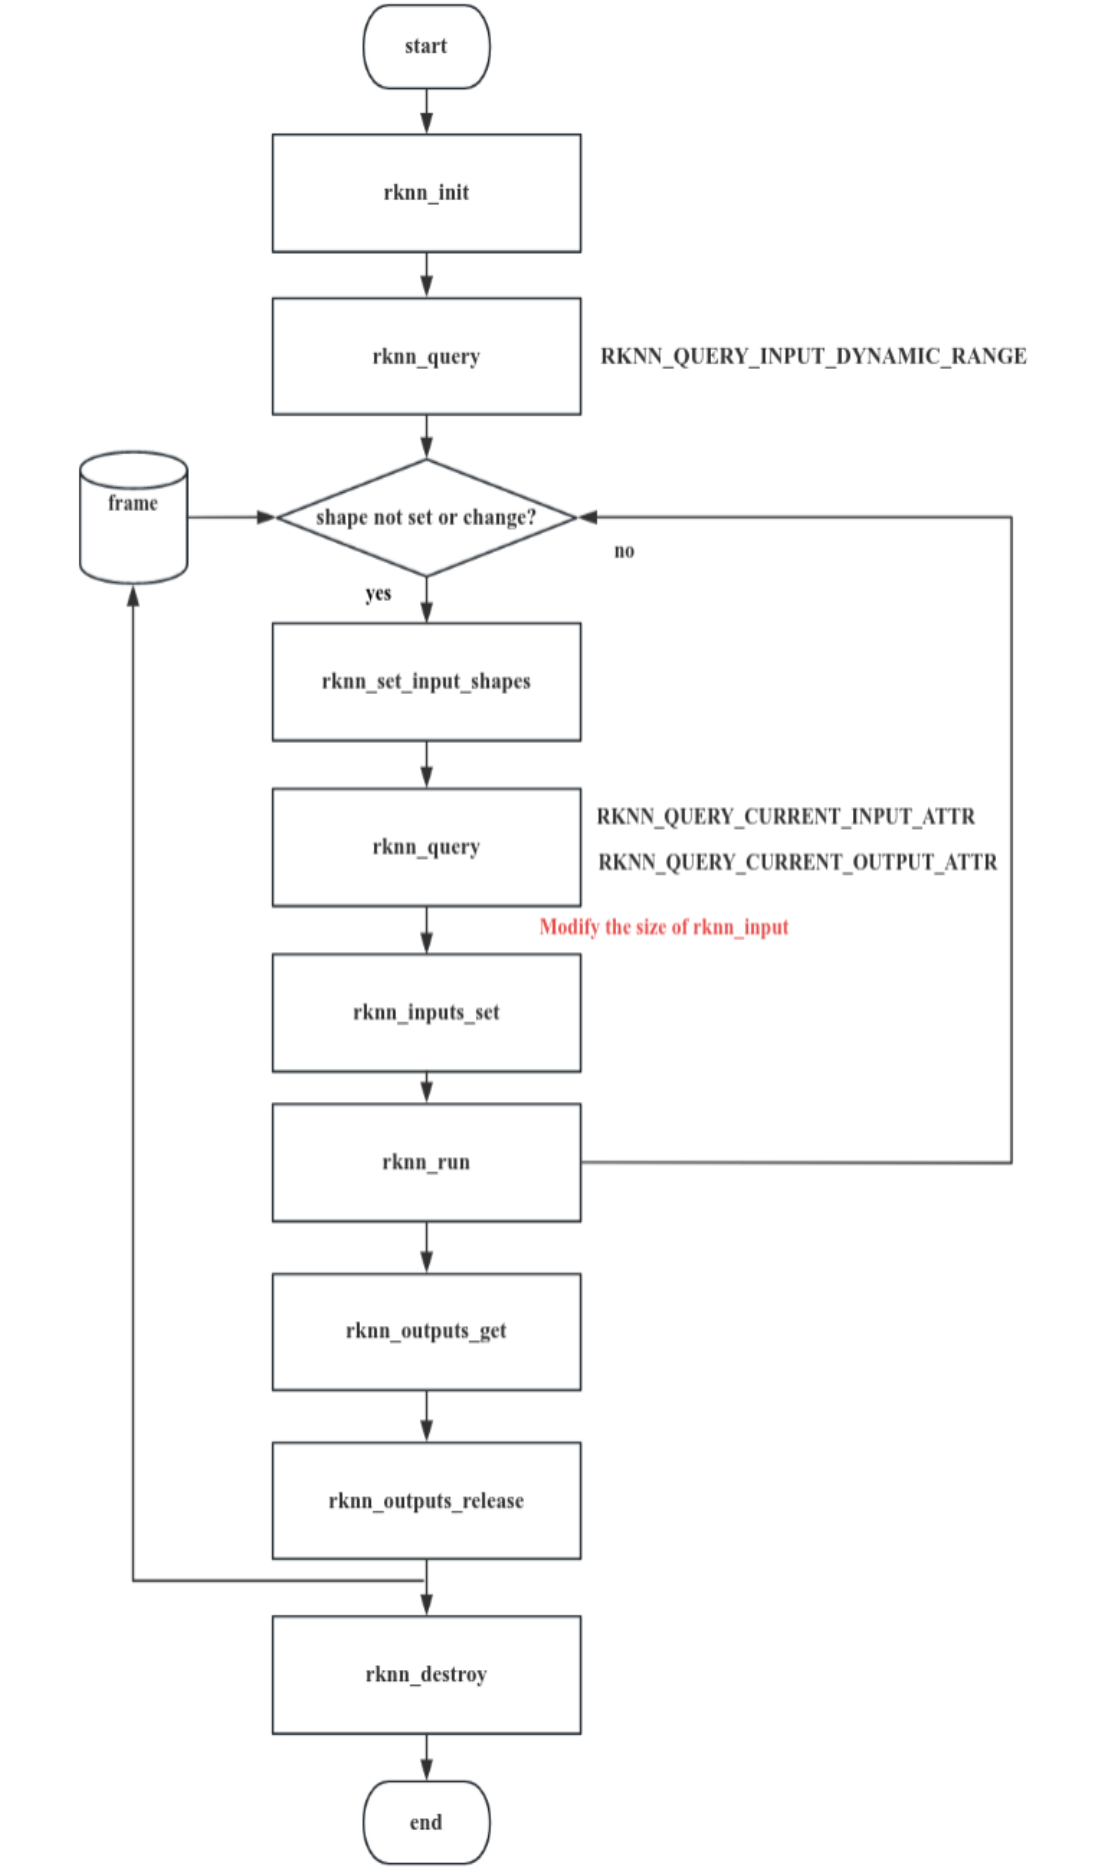
Abbildung 5-11: Zero-Copy-API-Ablauf für dynamische Eingabeformen
Initialisierung, Abfrage und Setzen der Eingabeform entsprechen der allgemeinen API und werden nicht wiederholt. Die Unterschiede betreffen die Schnittstellen nach dem Setzen der Form. C-Beispiel für Zero-Copy-Inferenz:
// Create the largest input tensor memory
rknn_tensor_mem *input_mems[io_num.n_input];
for (int i = 0; i < io_num.n_input; i++) {
  // default input type is int8 (normalize and quantize need compute in outside)
  // if set uint8, will fuse normalize and quantize to npu
  input_attrs[i].type = RKNN_TENSOR_UINT8;
  // default fmt is NHWC, npu only support NHWC in zero copy mode
  input_attrs[i].fmt = RKNN_TENSOR_NHWC;
  input_mems[i] = rknn_create_mem(ctx, input_attrs[i].size_with_stride);
...
// Create the largest output tensor memory
rknn_tensor_mem *output_mems[io_num.n_output];
for (uint32_t i = 0; i < io_num.n_output; ++i) {
  // default output type is depend on model, this require float32 to compute top5
  // allocate float32 output tensor
  int output_size = output_attrs[i].size * sizeof(float);
  output_mems[i] = rknn_create_mem(ctx, output_size);
...
// Load the input and set the model input shape. This is called once each time the input shape is switched.
for (int s = 0; s < shape_num; ++s) {
  for (int i = 0; i < io_num.n_input; i++) {
    for (int j = 0; j < input_attrs[i].n_dims; ++j) {
      input_attrs[i].dims[j] = shape_range[i].dyn_range[s][j];
  ....
  ret = rknn_set_input_shapes(ctx, io_num.n_input, input_attrs);
  if (ret < 0) {
    fprintf(stderr, "rknn_set_input_shape error! ret=%d\n", ret);
    return -1;
  ...
  // Get the input and output shape of the current inference
  printf("current input tensors:\n");
  rknn_tensor_attr cur_input_attrs[io_num.n_input];
  memset(cur_input_attrs, 0, io_num.n_input * sizeof(rknn_tensor_attr));
  for (uint32_t i = 0; i < io_num.n_input; i++) {
    cur_input_attrs[i].index = i;
    // query info
    ret = rknn_query(ctx, RKNN_QUERY_CURRENT_INPUT_ATTR, &(cur_input_attrs[i]), sizeof(rknn_tensor_attr));

    if (ret < 0) {
      printf("rknn_init error! ret=%d\n", ret);
      return -1;
  dump_tensor_attr(&cur_input_attrs[i]);
  ...
  printf("current output tensors:\n");
  rknn_tensor_attr cur_output_attrs[io_num.n_output];
  memset(cur_output_attrs, 0, io_num.n_output * sizeof(rknn_tensor_attr));
  for (uint32_t i = 0; i < io_num.n_output; i++) {
    cur_output_attrs[i].index = i;
    // query info
    ret = rknn_query(ctx, RKNN_QUERY_CURRENT_OUTPUT_ATTR, &(cur_output_attrs[i]),
sizeof(rknn_tensor_attr));
     if (ret != RKNN_SUCC) {
       printf("rknn_query fail! ret=%d\n", ret);
       return -1;
   dump_tensor_attr(&cur_output_attrs[i]);
   ...
   // Specify the number of NPU cores, only 3588/3576 is supported
   rknn_set_core_mask(ctx, (rknn_core_mask)core_mask);

   // Set input information
   rknn_input inputs[io_num.n_input];
   memset(inputs, 0, io_num.n_input * sizeof(rknn_input));
   std::vector<cv::Mat> resize_imgs;
   resize_imgs.resize(io_num.n_input);
   for (int i = 0; i < io_num.n_input; i++) {
     int height = cur_input_attrs[i].fmt == RKNN_TENSOR_NHWC ? cur_input_attrs[i].dims[1] :
 cur_input_attrs[i].dims[2];
     int width = cur_input_attrs[i].fmt == RKNN_TENSOR_NHWC ? cur_input_attrs[i].dims[2] :
 cur_input_attrs[i].dims[3];
     int stride = cur_input_attrs[i].w_stride;
     cv::resize(imgs[i], resize_imgs[i], cv::Size(width, height));
     int input_size = resize_imgs[i].total() * resize_imgs[i].channels();
     // Copy external data to zero-copy input buffer
     if (width == stride)
       memcpy(input_mems[i]->virt_addr, resize_imgs[i].data, input_size);
     else {
       int height = cur_input_attrs[i].dims[1];
       int channel = cur_input_attrs[i].dims[3];
       // copy from src to dst with stride
       uint8_t *src_ptr = resize_imgs[i].data;
       uint8_t *dst_ptr = (uint8_t *)input_mems[i]->virt_addr;
       // width-channel elements
       int src_wc_elems = width * channel;
       int dst_wc_elems = stride * channel;
       for (int b = 0; b < cur_input_attrs[i].dims[0]; b++) {
         for (int h = 0; h < height; ++h) {
           memcpy(dst_ptr, src_ptr, src_wc_elems);
           src_ptr += src_wc_elems;
           dst_ptr += dst_wc_elems;
    ....
   // Update input zero-copy buffer
   for (int i = 0; i < io_num.n_input; i++) {
     cur_input_attrs[i].type = RKNN_TENSOR_UINT8;
     ret = rknn_set_io_mem(ctx, input_mems[i], &cur_input_attrs[i]);
     if (ret < 0) {
       printf("rknn_set_io_mem fail! ret=%d\n", ret);
       return -1;
   ....
   // Update output zero-copy buffer
   for (uint32_t i = 0; i < io_num.n_output; ++i) {
     // default output type is depend on model, this require float32 to compute top5
     cur_output_attrs[i].type = RKNN_TENSOR_FLOAT32;
     cur_output_attrs[i].fmt = RKNN_TENSOR_NCHW;
     // set output memory and attribute
     ret = rknn_set_io_mem(ctx, output_mems[i], &cur_output_attrs[i]);
     if (ret < 0) {
       printf("rknn_set_io_mem fail! ret=%d\n", ret);
      return -1;
  ....
  // Inference
  printf("Begin perf ...\n");
  double total_time = 0;
  for (int i = 0; i < loop_count; ++i) {
    int64_t start_us = getCurrentTimeUs();
    ret = rknn_run(ctx, NULL);
    int64_t elapse_us = getCurrentTimeUs() - start_us;
    if (ret < 0) {
      printf("rknn run error %d\n", ret);
      return -1;
    ...
    total_time += elapse_us / 1000.f;
    printf("%4d: Elapse Time = %.2fms, FPS = %.2f\n", i, elapse_us / 1000.f, 1000.f * 1000.f / elapse_us);
  ...
  printf("Avg FPS = %.3f\n", loop_count * 1000.f / total_time);
Hinweis:
1. Form und Größe des Eingabepuffers von rknn_set_io_mem() bei dynamischen Formen:
Nach der Initialisierung, aber vor rknn_set_input_shapes(), liefert rknn_query() mit RKNN_QUERY_INPUT_ATTR und RKNN_QUERY_OUTPUT_ATTR üblicherweise die maximalen Ein- und Ausgabeformen. Diese Größen können zur Speicherallokation verwendet werden. Bei mehreren Eingaben sind manche Formen eventuell nicht maximal; suchen Sie dann unter allen unterstützten Formen die größten Größen und allokieren entsprechenden Speicher.
Für nicht vierdimensionale Eingaben verwenden Sie fmt=UNDEFINED; die Puffergröße der ursprünglichen Eingabeform wird aus Form und Typ berechnet.
Für vierdimensionale Eingaben wird fmt=NHWC oder NC1HWC2 unterstützt. Fragen Sie Form und Größe über die entsprechenden rknn_query-Felder ab und übergeben Sie einen passenden NHWC- oder NC1HWC2-Puffer.
rknn_query() mit RKNN_QUERY_CURRENT_INPUT_ATTR/RKNN_QUERY_CURRENT_OUTPUT_ATTR liefert Ein-/Ausgabeformen des ursprünglichen Modells in NHWC oder UNDEFINED. RKNN_QUERY_CURRENT_NATIVE_INPUT_ATTR/RKNN_QUERY_CURRENT_NATIVE_OUTPUT_ATTR liefert NPU-optimale Ein-/Ausgaben in NHWC oder NC1HWC2.
2. Für NHWC-Puffer in rknn_set_io_mem() setzen Sie shape und fmt in rknn_tensor_attr anhand von RKNN_QUERY_CURRENT_INPUT_ATTR. Für NC1HWC2 verwenden Sie RKNN_QUERY_CURRENT_NATIVE_INPUT_ATTR.
Vollständiges C-API-Demo für dynamische Formen: https://github.com/airockchip/rknn-toolkit2/tree/master/rknpu2/examples/rknn_dynamic_shape_input_demo
5.5 Benutzerdefinierte Operatoren
5.5.1 Einführung
RKNN SDK ermöglicht das Definieren und Ausführen benutzerdefinierter Operatoren während der RKNN-Inferenz. Damit lassen sich Modellfunktionen für CPU oder GPU erweitern und optimieren, Hardware besser nutzen und Inferenz beschleunigen. Korrektheit und Leistung erfordern jedoch ein tiefes Verständnis der Deep-Learning-Berechnungen und der Zielhardware. Unterstützt werden nur benutzerdefinierte Operatoren von ONNX-Modellen.
Benutzerdefinierte Operatoren erfordern zwei Hauptschritte:
Operatoren in RKNN-Toolkit2 registrieren und das RKNN-Modell exportieren.
Den Operator in C implementieren sowie über die RKNN-API laden, registrieren und ausführen.
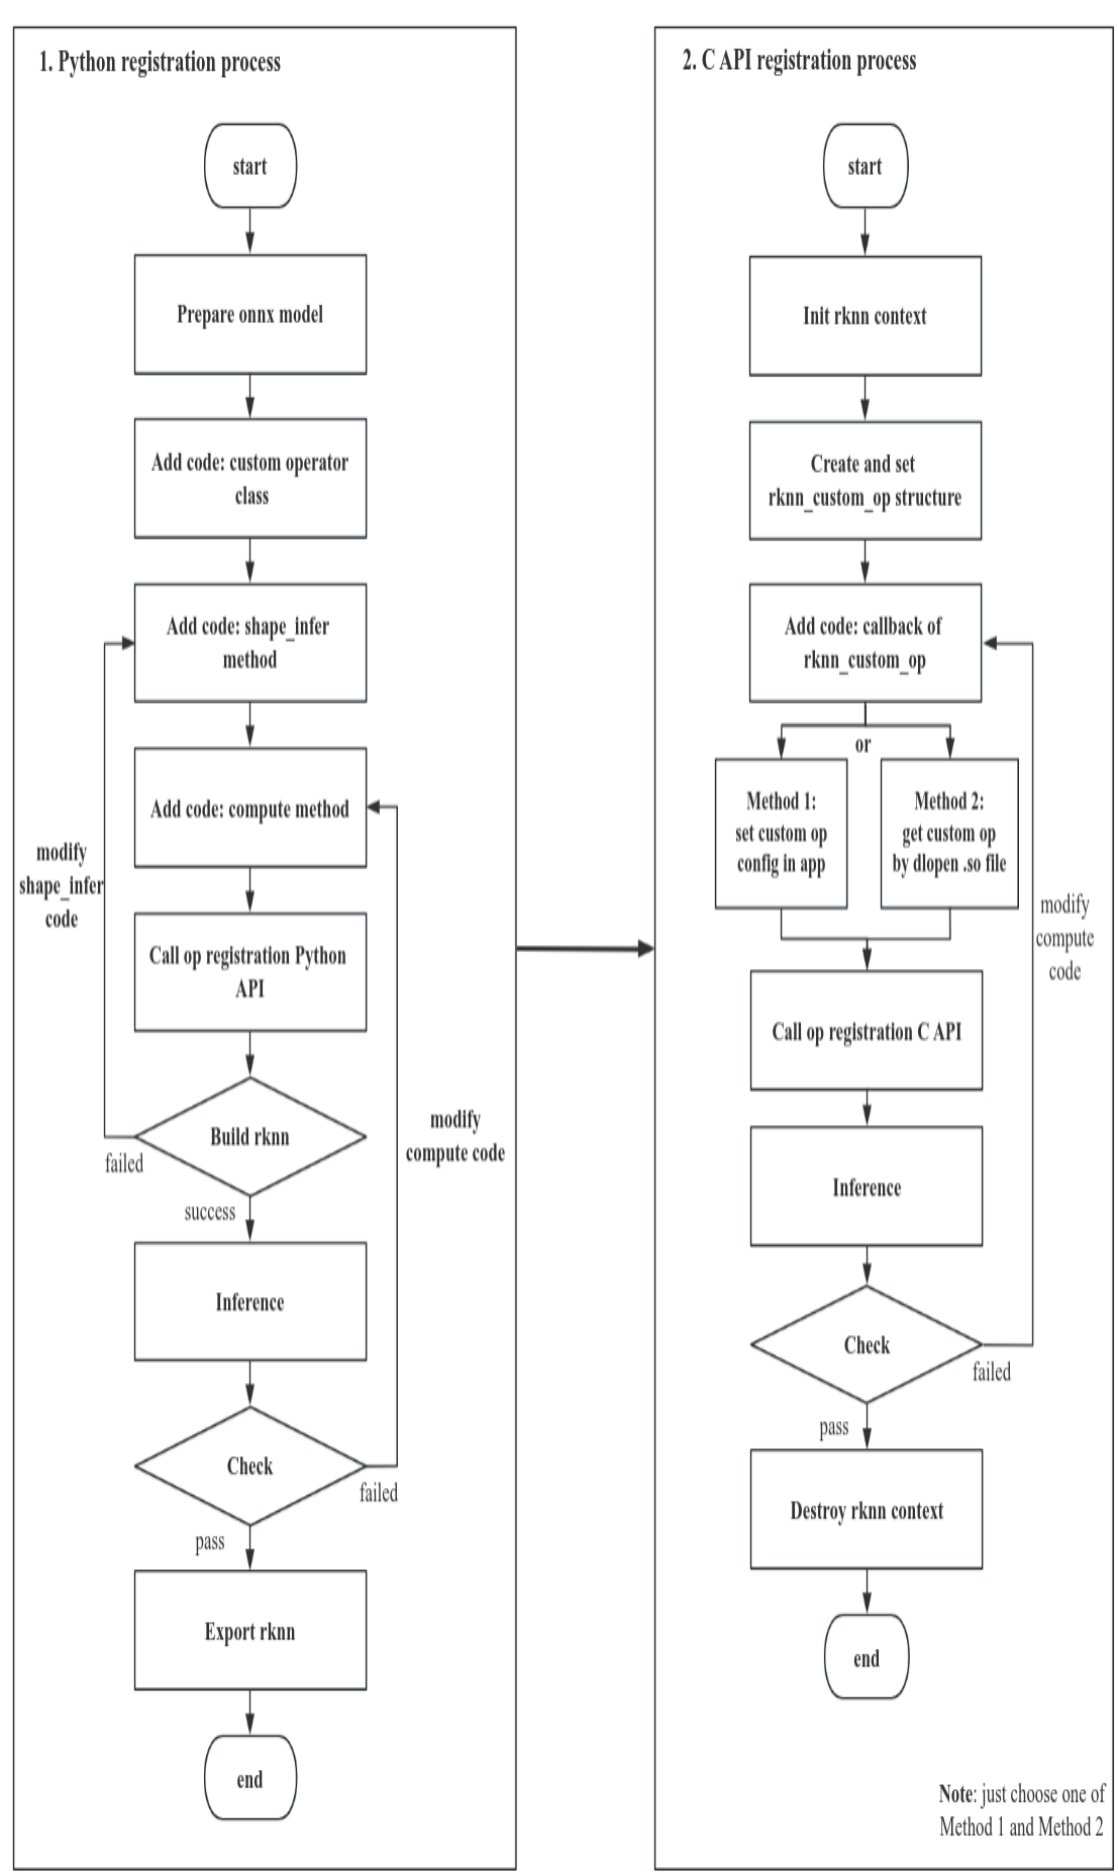
Abbildung 5-12: Vollständiger Ablauf zur Registrierung benutzerdefinierter Operatoren
5.5.2 Gesamtablauf
5.5.2.1 Operatoren in RKNN-Toolkit2 registrieren und RKNN-Modell exportieren
1. onnx-Modell vorbereiten: Gemäß ONNX-Spezifikation Typ, Name, Attribute und Ein-/Ausgabeanzahl des benutzerdefinierten Operators festlegen und ihn an der gewünschten Position im Graphen einfügen. Das Modell über die API des onnx-Pakets erstellen und exportieren.
2. Die Python-Klasse des Operators, insbesondere shape_infer() und compute(), implementieren und mit rknn.reg_custom_op() registrieren.
3. Nach erfolgreichem rknn.build() kann die Inferenz erfolgen; andernfalls shape_infer() aus Schritt 2 prüfen. Die Simulation ausführen. Bei korrekten Ergebnissen mit rknn.export_rknn() exportieren, andernfalls compute() aus Schritt 2 prüfen.
5.5.2.2 C-Implementierung des Operators sowie Laden, Registrieren und Ausführen über die RKNN-API
1. Den Operator in C auf Basis von rknn_custom_op aus rknn_custom_op.h implementieren und anschließend die rknn_custom_op-Informationen ausfüllen.
2. Die rknn_custom_op-Informationen mit rknn_register_custom_ops() registrieren.
3. Das Modell gemäß dem allgemeinen API- oder Zero-Copy-Ablauf erstellen und ausführen. Zur Prüfung des Operators können ausführliche Protokollierung und Modelldumps aktiviert werden.
5.5.2.3 Inferenz oder Genauigkeitsanalyse mit angeschlossenem Gerät über RKNN-Toolkit2
Für die Genauigkeitsanalyse eines Modells mit benutzerdefiniertem Operator auf einer angeschlossenen Platine kompilieren Sie dessen Callback-Implementierung als .so, legen die Datei im angegebenen Pfad ab und starten rknn_server neu. Einzelheiten stehen in Abschnitt 5.5.4.4.
5.5.3 Python-Ablauf
Benutzerdefinierte Operatoren werden nur für onnx-Modelle unterstützt. Damit können von RKNN unterstützte Operatoren außerhalb des ONNX-Standards ergänzt werden.
Ein solcher Operator ist nicht in der ONNX-Operatorliste enthalten. Zusätzlich zur ONNX-Spezifikation gelten folgende Regeln:
op_type darf keinem ONNX-Standardoperator entsprechen. Empfohlen wird das Präfix cst.
Der Operator muss mit anderen Operatoren verbunden sein, einschließlich definierter Formen, Datentypen und weiterer Eigenschaften der Ein-/Ausgaben.
Eingabeattribute unterstützen Einzelwerte oder Arrays der Typen bool, int32, float32 und int64.
Konstante Eingaben unterstützen bool, int32, float32 und int64. Gemeint sind die Datentypen des nicht quantisierten ONNX-Modells.
Da der Operator nicht zum ONNX-Standard gehört, muss das Modell mit ihm über die ONNX-API oder die API eines anderen Frameworks erstellt und exportiert werden.
Als einfaches Beispiel wird die Softmax-Definition verändert, um ein ONNX-Modell mit dem nicht standardisierten Operator cstSoftmax zu erstellen:
import onnx

path="test_softmax.onnx"
model=onnx.load(path)

for node in model.graph.node:
  if node.op_type =="Softmax":
    node.op_type = "cstSoftmax"
    ... # Modify the attribute definition of cstSoftmax, etc
onnx.save(model, "./test_softmax_custom.onnx")
Öffnen Sie das erstellte Modell in Netron und prüfen Sie, ob der Operator die Anforderungen erfüllt. Implementieren Sie anschließend die Klasse, beispielsweise für ein benutzerdefiniertes Softmax:
import numpy as np
from rknn.api.custom_op import get_node_attr
class cstSoftmax:
  op_type = 'cstSoftmax'
  def shape_infer(self, node, in_shapes, in_dtypes):
    out_shapes = in_shapes.copy()
    out_dtypes = in_dtypes.copy()
    return out_shapes, out_dtypes
  def compute(self, node, inputs):
    x = inputs[0]
    axis = get_node_attr(node, 'axis')
    x_max = np.max(x, axis=axis, keepdims=True)
    tmp = np.exp(x - x_max)
    s = np.sum(tmp, axis=axis, keepdims=True)
    outputs = [tmp / s]
    return outputs
Der benutzerdefinierte Operator muss eine Python-Klasse sein.
Die Klasse muss eine Zeichenfolgenvariable op_type enthalten, die dem Operatortypnamen in ONNX entspricht.
Die Klasse muss shape_infer(self, node, in_shapes, in_dtypes) enthalten; Funktions- und Parameternamen müssen exakt übereinstimmen, sonst entsteht ein Fehler. Die Funktion leitet die Operatorformen ab. node ist das ONNX-Knotenobjekt mit Attributen und Ein-/Ausgabeinformationen. in_shapes enthält alle Eingabeformen als [shape_0, shape_1, …], wobei jede shape ebenfalls eine Liste ist. in_dtypes enthält alle Eingabetypen als [dtype_0, dtype_1, …], jeweils als numpy dtype. Die Funktion muss sämtliche Ausgabeformen und dtype-Informationen in denselben Formaten wie in_shapes und in_dtypes zurückgeben.
Die Klasse muss compute(self, node, inputs) enthalten; Funktions- und Parameternamen müssen übereinstimmen, sonst entsteht ein Fehler. Die Funktion führt den Operator aus. node ist das ONNX-Objekt mit Attributen und Ein-/Ausgabeinformationen; inputs enthält Eingabedaten als [array_0, array_1, …] mit numpy-ndarray-Elementen. Zurückzugeben sind sämtliche Ausgabedaten im gleichen Format wie inputs.
Benutzerdefinierte Attribute lassen sich mit from rknn.api.custom_op import get_node_attr abrufen.
Registrieren Sie die fertige Klasse mit rknn.reg_custom_op() und rufen Sie anschließend rknn.build() zur Konvertierung und RKNN-Erzeugung auf. Die Klasse ermöglicht die üblichen Modellkonvertierungs- und Inferenzfunktionen. Beispiel mit benutzerdefiniertem Softmax:
from rknn.api import RKNN
# Create RKNN object
rknn = RKNN(verbose=True)

# Pre-process config
print('--> Config model')
rknn.config(mean_values=[103.94, 116.78, 123.68], std_values=[58.82, 58.82, 58.82], quant_img_RGB2BGR=True,
target_platform='rk3566')
print('done')

print('--> Register cstSoftmax op')
ret = rknn.reg_custom_op(cstSoftmax())
if ret != 0:
  print('Register cstSoftmax op failed!')
  exit(ret)
print('done')

print('--> Loading model')
ret = rknn.load_onnx(model='mobilenet_v2.onnx')
if ret != 0:
  print('Load model failed!')
  exit(ret)
print('done')

# Build model
print('--> Building model')
ret = rknn.build(do_quantization=True, dataset='./dataset.txt')
if ret != 0:
  print('Build model failed!')
  exit(ret)
print('done')
rknn.reg_custom_op() muss zwischen rknn.config() und rknn.load_xxx() aufgerufen werden.
5.5.4 Bereitstellung über die C-API
Nach Erhalt des Modells mit benutzerdefinierten Operatoren erfolgt die Bereitstellung über die C-API. Strukturen und Schnittstellen befinden sich in rknn_custom_op.h; binden Sie diese Headerdatei ein. Ablauf:
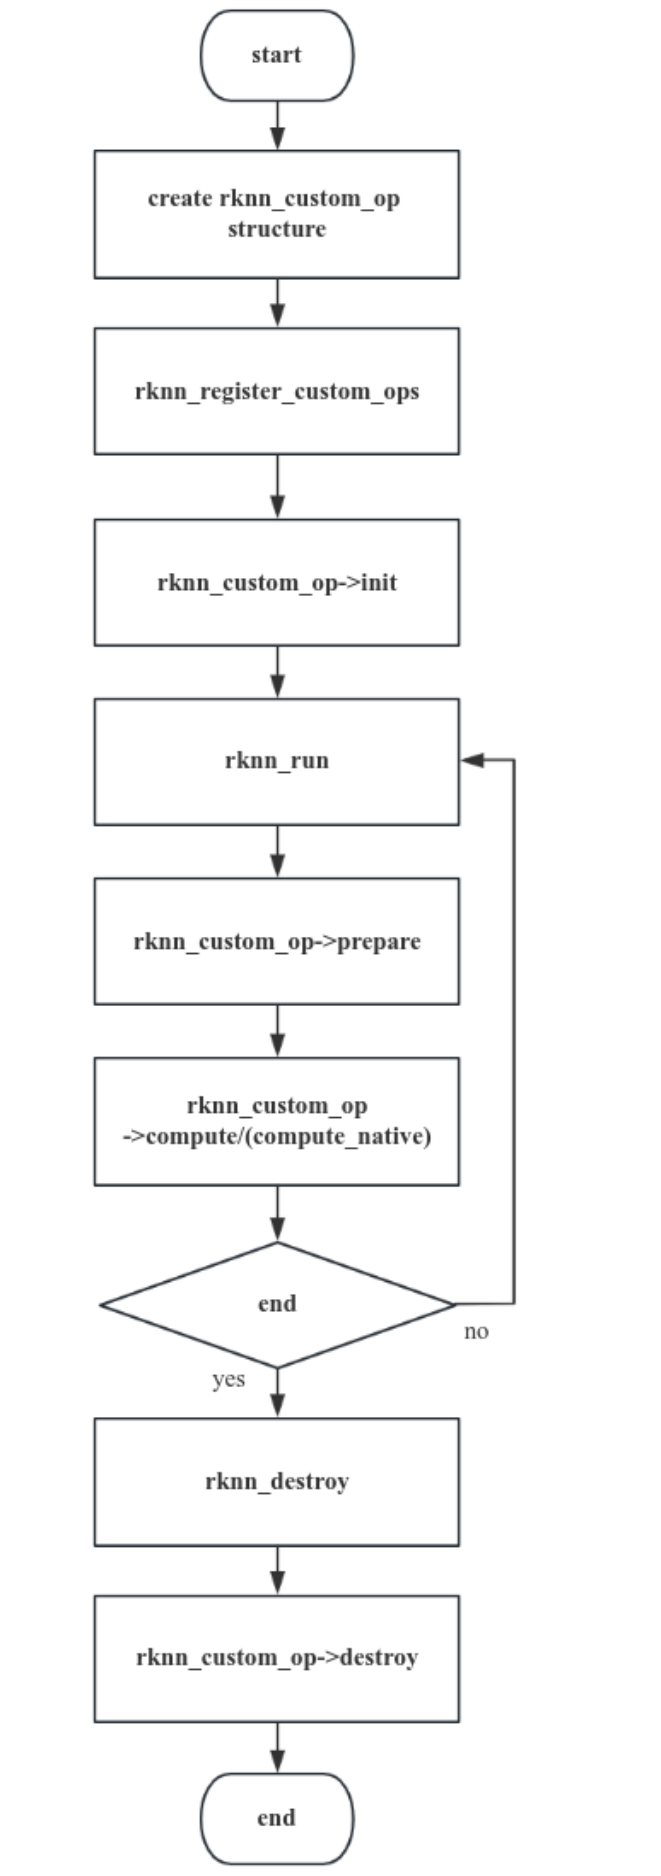
Abbildung 5-13: C-API-Aufrufablauf zur Registrierung benutzerdefinierter Operatoren
5.5.4.1 Struktur des benutzerdefinierten Operators initialisieren
Erstellen Sie nach dem rknn-Kontext die Struktur rknn_custom_op und setzen Sie folgende Informationen:
version: Version des Operators.
target: Ausführungsbackend des Operators; unterstützt werden CPU und GPU.
op_type: Operatortyp, identisch mit dem Typ im ONNX-Modell.
cl_kernel_name: Name der cl_kernel-Funktion des OpenCL-Codes; bei GPU-Operatorregistrierung erforderlich.
cl_kernel_source: Vollständiger Pfad zur .cl-Datei oder OpenCL-Kernelzeichenfolge. Bei cl_source_size=0 handelt es sich um den .cl-Pfad, bei cl_source_size>0 um den OpenCL-Code als Zeichenfolge. Für GPU-Operatoren erforderlich.
cl_source_size: Größe von cl_kernel_source. Der Sonderwert 0 bedeutet, dass cl_kernel_source ein Pfad ist.
cl_build_options: OpenCL-Kernel-Kompilierungsoptionen als Zeichenfolge; für GPU-Operatoren erforderlich.
init: Optionaler Callback, einmalig in rknn_register_custom_ops aufgerufen.
prepare: Optionaler Vorverarbeitungs-Callback. Jeder rknn_run führt zuerst prepare und anschließend compute/compute_native aus.
compute: Verpflichtender Berechnungs-Callback. Ein- und Ausgaben sind NCHW-float32-Daten; bei int64-Ein-/Ausgaben im ONNX-Modell werden int64-Daten verwendet.
compute_native: Reserviert; auf NULL setzen.
destroy: Optionaler Callback, einmal in rknn_destory ausgeführt; die Schreibweise wurde aus dem Original übernommen.
Parameterdefinitionen der Callbacks init/prepare/compute:
rknn_custom_op_context* op_ctx: Kontextinformationen des Operator-Callbacks.
rknn_custom_op_tensor* inputs: Daten und Informationen der Eingabetensoren.
uint32_t n_inputs: Anzahl der Operatoreingaben.
rknn_custom_op_tensor* outputs: Daten und Informationen der Ausgabetensoren.
uint32_t n_outputs: Anzahl der Operatorausgaben.
destroy besitzt nur einen Parameter: rknn_custom_op_context* op_ctx.
rknn_custom_op_context
Enthält target (Ausführungsgerät), GPU-Kontext, privaten Operatorkontext und priv_data. Zuweisung, Lesen, Schreiben und Freigabe von priv_data verwaltet der Entwickler. Der GPU-Kontext enthält Zeiger auf cl_context, cl_command_queue und cl_kernel; die entsprechenden OpenCL-Objekte werden durch Typumwandlung gewonnen.
priv_data ist ein optionaler Zeiger. Üblicherweise wird die Ressource in init() angelegt, ihre Adresse in priv_data gespeichert, in prepare()/compute() verwendet und in destroy() freigegeben.
rknn_custom_op_tensor
Beschreibt Ein-/Ausgabetensoren mit Name, Form, Größe, Quantisierungsparametern, virtueller Basisadresse, fd, Datenoffset und weiteren Informationen.
In compute() muss kein Speicher für Ein- und Ausgabetensoren erstellt werden; die Daten an der virtuellen Adresse sind bereits vorbereitet. Effektive Tensoradresse = virtuelle Basisadresse + Datenoffset. virt_addr im Mitglied mem bezeichnet die Basisadresse, offset den Datenoffset in Byte. Im Callback zeigt die Eingabeadresse auf die Ausgabe des vorherigen Operators, die Ausgabeadresse auf die Daten für den nächsten Operator.
rknn_custom_op_attr
Zum Abrufen von Attributinformationen rufen Sie rknn_custom_op_get_op_attr() mit dem Attributfeld auf. Das Ergebnis wird durch rknn_custom_op_attr dargestellt. Dessen void-Puffer, dtype und Elementanzahl beschreiben einen Speicherbereich. Durch C/C++-Typumwandlung des Pufferzeigers gemäß dtype erhalten Sie ein Array des entsprechenden Zahlentyps.
5.5.4.1.1 Init-Callback
Dient zum Auswerten von Operatorinformationen oder Initialisieren temporärer und Ein-/Ausgabepuffer, etwa zur Allokation eines temporären Puffers. Beispiel für init:
CPU-Operator:
/**
* cpu kernel init callback for custom op
*/
int custom_op_init_callback(rknn_custom_op_context* op_ctx, rknn_custom_op_tensor* inputs, uint32_t n_inputs,
              rknn_custom_op_tensor* outputs, uint32_t n_outputs)
{
  printf("custom_op_init_callback\n");
  // create tmp buffer
  float* tmp_buffer = (float*)malloc(inputs[0].attr.n_elems * sizeof(float));
  op_ctx->priv_data = tmp_buffer;
  return 0;
}
GPU-Operator:
/**
* opencl kernel init callback for custom op
* */
int relu_init_callback_gpu(rknn_custom_op_context* op_ctx, rknn_custom_op_tensor* inputs, uint32_t n_inputs,
             rknn_custom_op_tensor* outputs, uint32_t n_outputs)
{
  printf("relu_init_callback_gpu\n");
  // 获取opencl context
  cl_context cl_ctx = (cl_context)op_ctx->gpu_ctx.cl_context;

  // create tmp cl buffer
  cl_mem* memObject = (cl_mem*)malloc(sizeof(cl_mem) * 2);
  memObject[0] = clCreateBuffer(cl_ctx, CL_MEM_READ_WRITE, inputs[0].attr.size, NULL, NULL);
  memObject[1] = clCreateBuffer(cl_ctx, CL_MEM_READ_WRITE, outputs[0].attr.size, NULL, NULL);
  op_ctx->priv_data = memObject;
  return 0;
}
5.5.4.1.2 Prepare-Callback
Dieser Callback wird für jede Frame-Inferenz aufgerufen; das Original bezeichnet ihn zugleich als derzeit für die Zukunft reserviert.
5.5.4.1.3 Compute-Callback
Dies ist die Berechnungsfunktion des benutzerdefinierten Operators. Der Entwickler muss die Kernverarbeitung für Ein-/Ausgaben im Format NCHW oder UNDEFINED mit Datentyp float32 implementieren.
1. Compute-Callback (CPU)
Beispiel einer CPU-compute-Funktion für softmax:
/**
* float32 kernel implemetation sample for custom op
* */
int compute_custom_softmax_float32(rknn_custom_op_context* op_ctx, rknn_custom_op_tensor* inputs, uint32_t
n_inputs,
                 rknn_custom_op_tensor* outputs, uint32_t n_outputs)
{
  unsigned char* in_ptr = (unsigned char*)inputs[0].mem.virt_addr + inputs[0].mem.offset;
  unsigned char* out_ptr = (unsigned char*)outputs[0].mem.virt_addr + outputs[0].mem.offset;
  int axis = 0;
  const float* in_data = (const float*)in_ptr;
  float* out_data = (float*)out_ptr;
  std::string name = "";
  rknn_custom_op_attr op_name;
  rknn_custom_op_get_op_attr(op_ctx, "name", &op_name);
  if (op_name.n_elems > 0 && op_name.dtype == RKNN_TENSOR_UINT8) {
    name = (char*)op_name.data;
  }

  rknn_custom_op_attr op_attr;
  rknn_custom_op_get_op_attr(op_ctx, "axis", &op_attr);
  if (op_attr.n_elems == 1 && op_attr.dtype == RKNN_TENSOR_INT64) {
    axis = ((int64_t*)op_attr.data)[0];
  }

  printf("op name = %s, axis = %d\n", name.c_str(), axis);
  float* tmp_buffer = (float*)op_ctx->priv_data;
  // kernel implemetation for custom op
  {
    int inside = 1;
    int outside = 1;
    int channel = 1;

    while (axis < 0) {
      axis += inputs[0].attr.n_dims;
    }

    for (int i = 0; i < axis; i++) {
      outside *= inputs[0].attr.dims[i];
    }
    channel = inputs[0].attr.dims[axis];
    for (int i = axis; i < inputs[0].attr.n_dims; i++) {
      inside *= inputs[0].attr.dims[i];
    }
    for (int y = 0; y < outside; y++) {
      const float* src_y = in_data + y * inside;
      float* dst_y = out_data + y * inside;
      float max_data = -FLT_MAX;
      float sum_data = 0.0f;

      for (int i = 0; i < inside; ++i) {
        max_data = fmaxf(max_data, src_y[i]);
      }
      for (int i = 0; i < inside; ++i) {
        tmp_buffer[i] = expf(src_y[i] - max_data);
        sum_data += tmp_buffer[i];
      }
      for (int i = 0; i < inside; ++i) {
        dst_y[i] = tmp_buffer[i] / sum_data;
      }
    }
  }
  return 0;
}
2. Compute-Callback (GPU)
Für GPU-Operatoren können im Callback folgende Schritte durchgeführt werden:
cl_context, cl_command_queue und cl_kernel aus gpu_ctx in rknn_custom_op_context mit entsprechender Typumwandlung abrufen.
Falls nötig, einen cl_mem-Puffer für Ein- oder Ausgabe des Operators erstellen.
Funktionsargumente von cl_kernel setzen.
Der Eingabepuffer des OpenCL-Kernels unterstützt nur float; andere Typen sind nicht unterstützt.
Bei Zero-Copy kann clImportMemoryARM den Eingabetensorspeicher auf eine OpenCL-cl_mem-Struktur abbilden. Der Eingangstensor enthält bereits Daten; erneutes Kopieren ist nicht nötig. Dies kann in init erfolgen, wobei cl_mem in priv_data gespeichert und anschließend in compute abgerufen und verwendet wird.
cl_kernel blockierend ausführen.
Die Eingabedaten im CL-Kernel liegen im NCHW-Format vor.
Soll die CPU nach der GPU-Verarbeitung auf die Daten zugreifen, aktualisieren Sie vor dem Lesen den Cache des Ausgabetensors mit rknn_mem_sync.
Beispiel einer GPU-Berechnungsfunktion für eine benutzerdefinierte relu-Schicht:
/**
* opencl kernel init callback for custom op
* */
int compute_custom_relu_float32(rknn_custom_op_context* op_ctx, rknn_custom_op_tensor* inputs, uint32_t
num_inputs,
                rknn_custom_op_tensor* outputs, uint32_t num_outputs)
{
   std::string name = "";
   rknn_custom_op_attr op_name;
   rknn_custom_op_get_op_attr(op_ctx, "name", &op_name);
   if (op_name.n_elems > 0 && op_name.dtype == RKNN_TENSOR_UINT8) {
     name = (char*)op_name.data;
   }

   // // save input npy
   // char output_path[PATH_MAX];
   // sprintf(output_path, "%s/cpu_input%d.npy", ".", 0);
   // save_npy(output_path, (float*)in_data, &inputs[0].attr);

   // get context
   cl_context cl_ctx = (cl_context)op_ctx->gpu_ctx.cl_context;

   // get command queue
   cl_command_queue queue = (cl_command_queue)op_ctx->gpu_ctx.cl_command_queue;

   // get kernel
   cl_kernel kernel = (cl_kernel)op_ctx->gpu_ctx.cl_kernel;

   // import input/output buffer
   const cl_import_properties_arm props[3] = {
     CL_IMPORT_TYPE_ARM,
     CL_IMPORT_TYPE_DMA_BUF_ARM,
     0,
   };

   cl_int status;
   cl_mem inObject = clImportMemoryARM(cl_ctx, CL_MEM_READ_WRITE, props, &inputs[0].mem.fd,
                     inputs[0].mem.offset + inputs[0].mem.size, &status);
   if (status != CL_SUCCESS) {
     printf("Tensor: %s clImportMemoryARM failed\n", inputs[0].attr.name);
   }
   cl_mem outObject = clImportMemoryARM(cl_ctx, CL_MEM_READ_WRITE, props, &outputs[0].mem.fd,
                     outputs[0].mem.offset + outputs[0].mem.size, &status);
   if (status != CL_SUCCESS) {
     printf("Tensor: %s clImportMemoryARM failed\n", outputs[0].attr.name);
   }

   int in_type_bytes = get_type_bytes(inputs[0].attr.type);
   int out_type_bytes = get_type_bytes(outputs[0].attr.type);
   int in_offset = inputs[0].mem.offset / in_type_bytes;
   int out_offset = outputs[0].mem.offset / out_type_bytes;
   unsigned int elems = inputs[0].attr.n_elems;

   // set kernel args
   int argIndex = 0;
   clSetKernelArg(kernel, argIndex++, sizeof(cl_mem), &inObject);
   clSetKernelArg(kernel, argIndex++, sizeof(cl_mem), &outObject);
   clSetKernelArg(kernel, argIndex++, sizeof(int), &in_offset);
   clSetKernelArg(kernel, argIndex++, sizeof(int), &out_offset);
   clSetKernelArg(kernel, argIndex++, sizeof(unsigned int), &elems);

   // set global worksize
   const size_t global_work_size[3] = {elems, 1, 1};
  // enqueueNDRangeKernel
  clEnqueueNDRangeKernel(queue, kernel, 1, NULL, global_work_size, NULL, 0, NULL, NULL);

  // finish command queue
  clFinish(queue);

  // //cpu access data after sync to device
  // rknn_mem_sync(&outputs[0].mem, RKNN_MEMORY_SYNC_FROM_DEVICE);
  // // save output npy
  // char output_path[PATH_MAX];
  // sprintf(output_path, "%s/cpu_output%d.npy", ".", 0);
  // unsigned char* out_data = (unsigned char*)outputs[0].mem.virt_addr+outputs[0].mem.offset;
  // save_npy(output_path, (float*)out_data, &inputs[0].attr);
  return 0;
}
5.5.4.1.4 Destroy-Callback
Gibt temporäre oder Ein-/Ausgabepuffer des benutzerdefinierten Operators frei. Beispiel zum Freigeben eines temporären Puffers:
CPU-Operator
/**
* cpu kernel destroy callback for custom op
*/
int custom_op_destroy_callback(rknn_custom_op_context* op_ctx)
{
  printf("custom_op_destroy_callback\n");
  // clear tmp buffer
  free(op_ctx->priv_data);
  return 0;
}
GPU-Operator
/**
* opencl kernel destroy callback for custom op
*/
int relu_destroy_callback_gpu(rknn_custom_op_context* op_ctx)
{
  // clear tmp buffer
  printf("relu_destroy_callback_gpu\n");
  cl_mem* memObject = (cl_mem*)op_ctx->priv_data;
  clReleaseMemObject(memObject[0]);
  clReleaseMemObject(memObject[1]);
  free(memObject);
  return 0;
}
5.5.4.2 Benutzerdefinierten Operator registrieren
Registrieren Sie die konfigurierte rknn_custom_op-Struktur mit rknn_register_custom_ops() im rknn_context. Mehrere benutzerdefinierte Operatoren können gleichzeitig registriert werden.
Registrieren Sie nach Implementierung des CPU-compute-Callbacks cstSoftmax und ArgMax, beispielsweise:
CPU-Operator
// CPU operators
rknn_custom_op user_op[2];
memset(user_op, 0, 2 * sizeof(rknn_custom_op));
strncpy(user_op[0].op_type, "cstSoftmax", RKNN_MAX_NAME_LEN - 1);
user_op[0].version = 1;
user_op[0].target = RKNN_TARGET_TYPE_CPU;
user_op[0].init = custom_op_init_callback;
user_op[0].compute = compute_custom_softmax_float32;
user_op[0].destroy = custom_op_destroy_callback;

strncpy(user_op[1].op_type, "ArgMax", RKNN_MAX_NAME_LEN - 1);
user_op[1].version = 1;
user_op[1].target = RKNN_TARGET_TYPE_CPU;
user_op[1].init = custom_op_init_callback;
user_op[1].compute = compute_custom_argmax_float32;
user_op[1].destroy = custom_op_destroy_callback;

ret = rknn_register_custom_ops(ctx, user_op, 2);
if (ret < 0) {
  printf("rknn_register_custom_ops fail! ret = %d\n", ret);
  return -1;
}
GPU-Operator
Der OpenCL-Kernel eines GPU-Operators kann als konstante Zeichenfolge oder Dateipfad registriert werden. Bei cl_source_size=0 in rknn_custom_op bezeichnet cl_kernel_source den Pfad; bei cl_source_size>0 die Kernel-Funktionszeichenfolge. Beispiel eines relu-Kernels als Zeichenfolge:
char* cl_kernel_source = "#pragma OPENCL EXTENSION cl_arm_printf : enable"
  "#pragma OPENCL EXTENSION cl_khr_fp16 : enable "
  " __kernel void relu_float(__global const float* input, __global float* output, int "
  "in_offset, int out_offset, const unsigned int elems) "
  "{"
  " int gid = get_global_id(0);"
  " if (gid < elems) {"
  " float in_value = input[in_offset + gid];"
  " output[out_offset + gid] = in_value >= 0.f ? in_value : 0.f;"
  " }"
  "}"
  "__kernel void relu_half(__global const half* input, __global half* output, int in_offset, "
  "int out_offset, const unsigned int elems)"
  "{"
  " int gid = get_global_id(0);"
  " if (gid < elems) {"
  " half in_value = input[in_offset + gid];"
  " output[out_offset + gid] = in_value >= 0.f ? in_value : 0.f;"
  " }"
  "}";
Nach Implementierung des OpenCL-Kernels und GPU-compute-Callbacks konfigurieren Sie das rknn_custom_op-Array und registrieren den GPU-Operator. Beispiel:
// GPU operators
rknn_custom_op user_op[1];
memset(user_op, 0, sizeof(rknn_custom_op));
strncpy(user_op->op_type, "cstSoftmax", RKNN_MAX_NAME_LEN - 1);
user_op->version = 1;
user_op->target = RKNN_TARGET_TYPE_GPU;
user_op->init = relu_init_callback_gpu;
user_op->compute = compute_custom_relu_float32;
user_op->destroy = relu_destroy_callback_gpu;
#ifdef LOAD_FROM_PATH
user_op->cl_kernel_source = "./custom_op.cl";
user_op->cl_source_size = 0;
#else
user_op->cl_kernel_source = cl_kernel_source;
user_op->cl_source_size = strlen(cl_kernel_source);
#endif
strcpy(user_op->cl_kernel_name, "relu_float");

ret = rknn_register_custom_ops(ctx, user_op, 1);
if (ret < 0) {
  printf("rknn_register_custom_ops fail! ret = %d\n", ret);
  return -1;
}
Definieren Sie vor der Registrierung op_type eindeutig, bereiten Sie die Operatorinformationen vor und konfigurieren Sie das rknn_custom_op-Array. Jeder Operatortyp wird einmal registriert; mehrere Operatoren desselben Typs im Netz benötigen keine wiederholte Registrierung.
5.5.4.3 Modellinferenz
Nach Registrierung aller Operatoren führen Sie die Inferenz über die allgemeine API oder Zero-Copy-API aus.
5.5.4.4 Genauigkeitsanalyse mit angeschlossenem Gerät
Für das Debuggen benutzerdefinierter Operatoren mit angeschlossener Platine ist rknn_server Version >= 1.6.0 erforderlich.
Beim Debuggen öffnet rknn_server die vom Benutzer kompilierte Pluginbibliothek mittels dlopen aus einem bestimmten Verzeichnis und liest die Operatorinformationen. Zur Registrierung in der Bibliothek muss get_rknn_custom_op() implementiert werden.
Für die Genauigkeitsanalyse eines Modells mit solchen Operatoren auf dem angeschlossenen Gerät:
1. get_rknn_custom_op() und die erforderlichen Callbacks implementieren und als Bibliothek für das jeweilige System kompilieren. Ihr Name muss mit librkcst_ beginnen, beispielsweise librkcst_relu.so.
2. Das Plugin unter /vendor/lib64/ für Android arm64-v8a beziehungsweise /usr/lib/rknpu/op_plugins für Linux ablegen.
3. Die Genauigkeitsanalyse vom Computer über die Python-Schnittstelle von RKNN-Toolkit2 durchführen.
Beispiel für get_rknn_custom_op:
/**
 * To obtain operator information to be registered, a plugin library must have one and only one of this function.
 */
RKNN_CUSTOM_OP_EXPORT rknn_custom_op* get_rknn_custom_op()
{
  // register a custom op
  memset(&user_op, 0, sizeof(rknn_custom_op));
  strncpy(user_op.op_type, "cstSoftmax", RKNN_MAX_NAME_LEN - 1);
  user_op.version = 1;
  user_op.target = RKNN_TARGET_TYPE_CPU;
  user_op.init = custom_op_init_callback;
  user_op.compute = compute_custom_softmax_float32;
  user_op.destroy = custom_op_destroy_callback;
  return &user_op;
}
Fügen Sie der Funktion das Attribut RKNN_CUSTOM_OP_EXPORT hinzu, damit das Plugin das Symbol get_rknn_custom_op exportiert.
rknn_server verwendet dlopen für die Handles aller so-Bibliotheken im angegebenen Verzeichnis und anschließend dlsym für den Zeiger auf get_rknn_custom_op. Dessen Aufruf liefert die Operatorstruktur. Beispiel:
std::vector<std::string> get_all_plugin_paths(std::string plugin_dir)
{
  std::vector<std::string> plugin_paths;
  if (access(plugin_dir.c_str(), 0) != 0) {
    fprintf(stderr, "Can not access plugin directory: %s, please check it!\n", plugin_dir.c_str());
  }

  DIR* dir;
  struct dirent* ent;
  const char* prefix = RKNN_CSTOP_PLUGIN_PREFIX; // All library file names should start with this prefix

  if ((dir = opendir(plugin_dir.c_str())) != NULL) {
    while ((ent = readdir(dir)) != NULL) {
      if (ent->d_type == DT_REG) {
        const char* filename = ent->d_name;
        size_t len = strlen(filename);

        if (len > 10 && strncmp(filename, prefix, strlen(prefix)) == 0) {
          printf("Found plugin: %s file in %s\n", filename, plugin_dir.c_str());
          plugin_paths.push_back(plugin_dir + "/" + filename);
        }
      }
    }
    closedir(dir);
  } else {
    fprintf(stderr, "Unable to open directory");
  }
  return plugin_paths;
}

// the default path of the custom operator plugin libraries
std::string plugin_dir =
#if defined(__ANDROID__)
# if defined(__aarch64__)
  "/vendor/lib64/";
# else
  "/vendor/lib/";
# endif // __aarch64__
#elif defined(__linux__)
  "/usr/lib/rknpu/op_plugins/";
#endif

std::vector<std::string> plugin_paths = get_all_plugin_paths(plugin_dir);
std::vector<void*> so_handles;
for (auto path : plugin_paths) {
  printf("load plugin %s\n", path.c_str());
  void* plugin_lib = dlopen(path.c_str(), RTLD_NOW);
  char* error = dlerror();
  if (error != NULL) {
    fprintf(stderr, "dlopen %s fail: %s.\nPlease try to set 'export LD_LIBRARY_PATH=$LD_LIBRARY_PATH:%s'\n",
        path.c_str(), error, plugin_dir.c_str());
    dlclose(plugin_lib);
    return -1;
  }
  printf("dlopen %s successfully!\n", path.c_str());
  get_custom_op_func custom_op_func = (get_custom_op_func)dlsym(plugin_lib, "get_rknn_custom_op");
  error = dlerror();
  if (error != NULL) {
    fprintf(stderr, "dlsym fail: %s\n", error);
    dlclose(plugin_lib);
    return -1;
  }

  rknn_custom_op* user_op = custom_op_func();
  ret = rknn_register_custom_ops(ctx, user_op, 1);
  if (ret < 0) {
    printf("rknn_register_custom_ops fail! ret = %d\n", ret);
    return -1;
  }
  so_handles.push_back(plugin_lib);
}
Hinweise zur Pluginbibliothek:
Eine Pluginbibliothek registriert nur einen benutzerdefinierten Operator. Für mehrere Operatoren sind mehrere Bibliotheken erforderlich.
Der Bibliotheksname muss mit librkcst_ beginnen und auf .so enden.
Fügen Sie bei einem C++-Plugin folgende Makros vor und nach der Funktionsdefinition ein, damit die C-Schnittstelle die Funktionssymbole korrekt öffnen kann:
#ifdef __cplusplus
extern "C" {
#endif

//code

#ifdef __cplusplus
} // extern "C"
#endif
Falls dlopen die Bibliothek nicht laden kann, prüfen Sie LD_LIBRARY_PATH und ob das Pluginverzeichnis im angegebenen Pfad enthalten ist.
5.6 Multi-Batch-Verarbeitung
5.6.1 Multi-Batch-Prinzip
Die NPU des RK3588 besitzt drei Kerne, die des RK3576 zwei. Für effiziente Batch-Inferenz steht Multi-Batch bereit. Dabei ruft die Implementierung intern rknn_dup_context auf: Nur Internal wird kopiert, Weight wird gemeinsam genutzt. Bei rknn_batch_size=2 wird einmal kopiert, bei rknn_batch_size >=3 zweimal, da nur 3 Kerne gleichzeitig arbeiten und weitere Kopien Speicher verschwenden würden. core_mask jedes Kontexts wird für automatische Mehrkernplanung auf 0 gesetzt. rknn_run() erzeugt intern einen Threadpool; drei Threads führen gleichzeitig drei Kontexte aus.
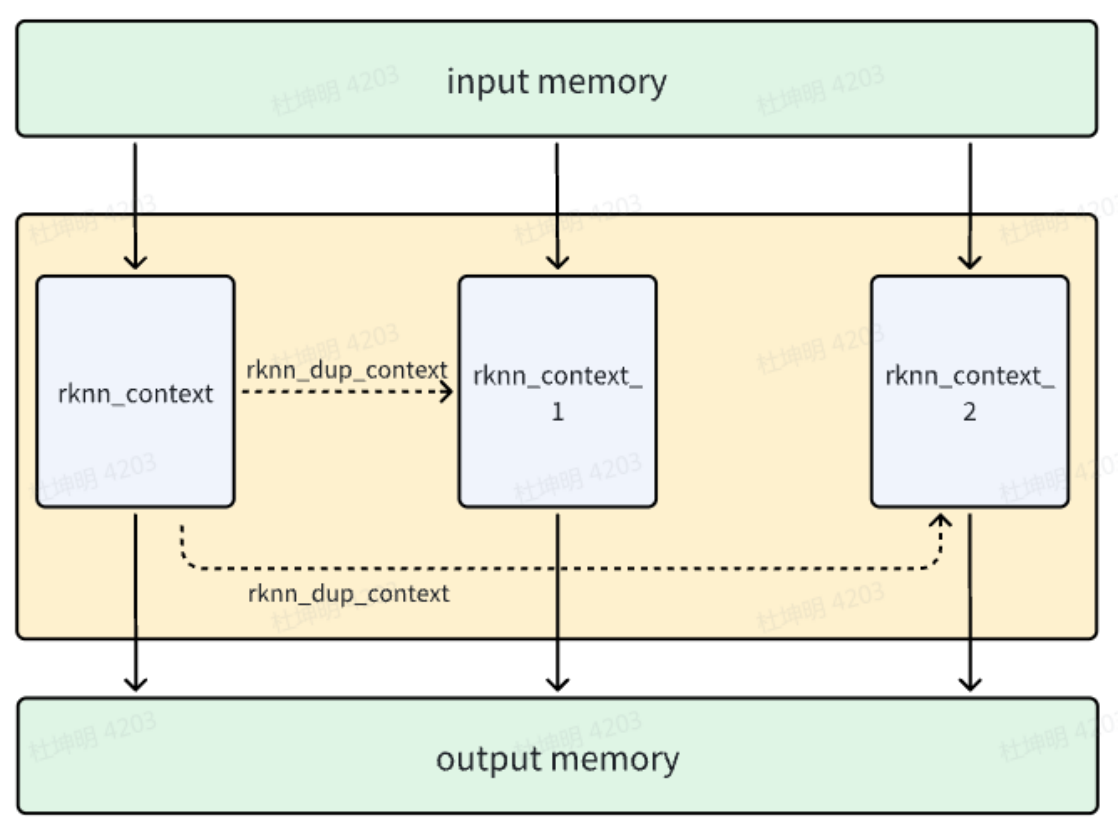
Abbildung 5-14: Internes Multi-Batch-Prinzip
5.6.2 Multi-Batch verwenden
Verwendung von Multi-Batch:
1. Multi-Batch in Python aktivieren:
ret = rknn.build(do_quantization=True, dataset='./dataset.txt', rknn_batch_size=3)
Für optimale Leistung sollte rknn_batch_size auf RK3588 ein Vielfaches von 3 und auf RK3576 ein Vielfaches von 2 sein.
2. Die Zero-Copy-Schnittstelle wird empfohlen.
5.6.3 Multi-Batch-Ein- und Ausgaben
Bei aktiviertem Multi-Batch sind die abgefragten Ein- und Ausgabegrößen rknn_batch_size-mal so groß wie ohne diese Funktion. Jeder Kontext berechnet seinen Eingabeoffset, liest die Daten für die Inferenz und berechnet anschließend den Ausgabeoffset zum Schreiben des Ergebnisses. Für den zweiten Batch beträgt der Eingabeoffset beispielsweise input_size/rknn_batch_size und der Ausgabeoffset output_size/rknn_batch_size.
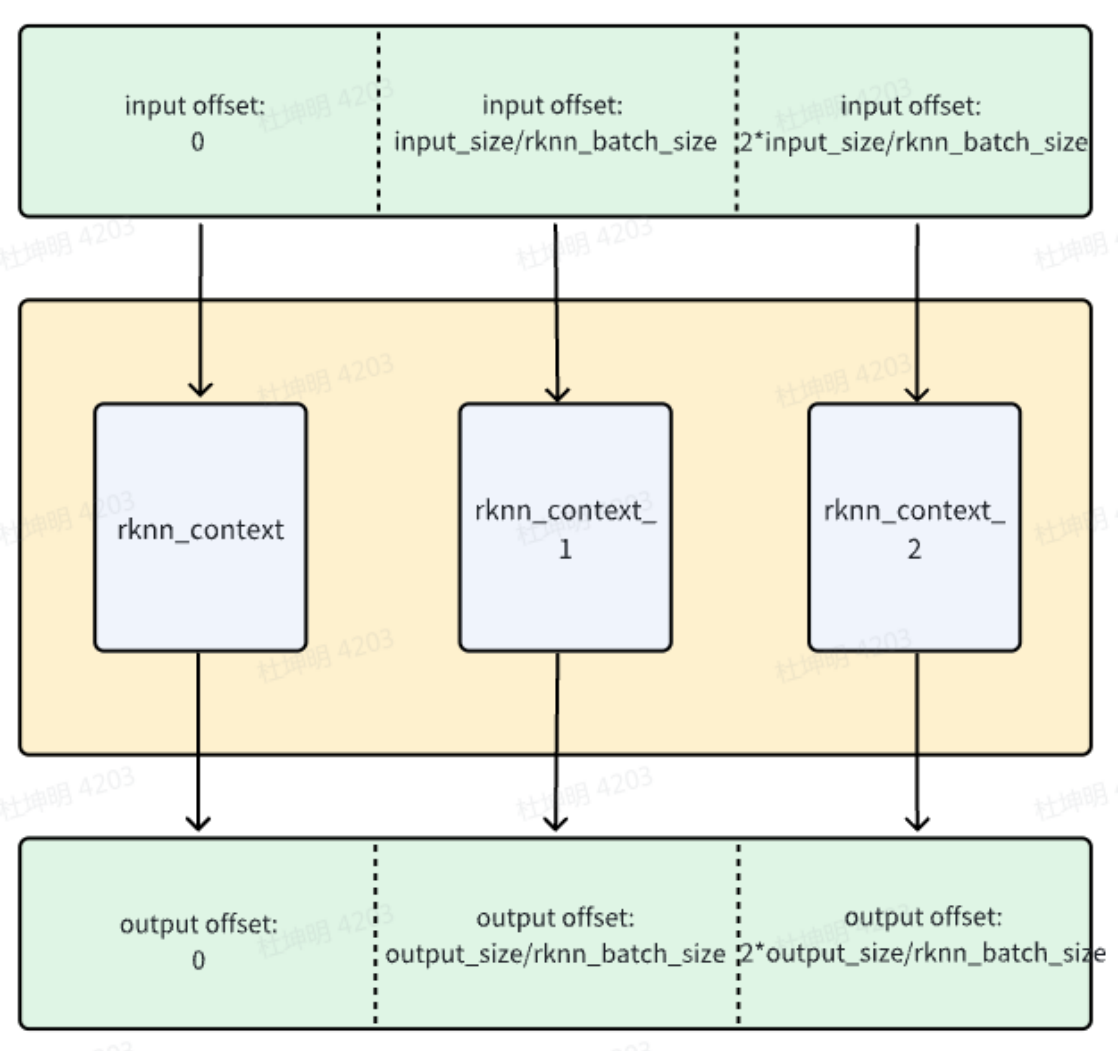
Abbildung 5-15: Interne Ein- und Ausgabeadressoffsets bei Multi-Batch
5.7 NPU-SRAM von RK3588/RK3576
RK3588 enthält 1MB SRAM; davon können 956KB von den IP-Blöcken des SoC genutzt und gezielt RKNPU zugewiesen werden.
RK3576 enthält 512KB SRAM; davon können 480KB von den IP-Blöcken des SoC genutzt und gezielt RKNPU zugewiesen werden.
SRAM kann den DDR-Bandbreitenbedarf von RKNPU-Anwendungen reduzieren, die Inferenzzeit jedoch beeinflussen.
5.7.1 Anforderungen an die RKNPU-Umgebung
5.7.1.1 Kernelanforderungen
RKNPU-Treiberversion >=0.8.0
In der Kernelkonfiguration CONFIG_ROCKCHIP_RKNPU_SRAM=y aktivieren.
Konfigurationspfad für Android:
<path-to-your-kernel>/arch/arm64/configs/rockchip_defconfig
Konfigurationspfad für Linux:
<path-to-your-kernel>/arch/arm64/configs/rockchip_linux_defconfig
Im entsprechenden Kernel-DTS muss Systemspeicher aus der SRAM für RKNPU zugewiesen werden.
Weisen Sie die erforderliche Größe zu: maximal 956KB auf RK3588 und 480KB auf RK3576. Die Größe muss auf 4K ausgerichtet sein.
Hinweis: SRAM kann standardmäßig bereits anderen IP-Blöcken, etwa dem Codec, zugewiesen sein. Die Bereiche verschiedener Blöcke dürfen sich nicht überlappen, sonst führen gleichzeitige Lese- und Schreibzugriffe zu Datenverfälschungen.
Beispiel zur Zuweisung von 956KB auf RK3588 und 480KB auf RK3576 an RKNPU:
RK3588:
syssram: sram@ff001000 {
  compatible = "mmio-sram";
  reg = <0x0 0xff001000 0x0 0xef000>;

  #address-cells = <1>;
  #size-cells = <1>;
  ranges = <0x0 0x0 0xff001000 0xef000>;
  /* Allocate RKNPU SRAM /
  / start address and size should be 4k algin */
  rknpu_sram: rknpu_sram@0 {
    reg = <0x0 0xef000>; // 956KB
  };
};
Ordnen Sie die allokierte SRAM dem RKNPU-Knoten zu und ändern Sie die dtsi-Datei wie folgt:
<path-to-your-kernel>/arch/arm64/boot/dts/rockchip/rk3588s.dtsi
rknpu: npu@fdab0000 {
  compatible = "rockchip,rk3588-rknpu";
  /* ... /
  / Add reference RKNPU sram */
  rockchip,sram = <&rknpu_sram>;
  status = "disabled";
};
RK3576:
sram: sram@3ff88000 {
  compatible = "mmio-sram";
  reg = <0x0 0x3ff88000 0x0 0x78000>;

  #address-cells = <1>;
  #size-cells = <1>;
  ranges = <0x0 0x0 0x3ff88000 0x78000>;
  /* Allocate RKNPU SRAM /
  / start address and size should be 4k algin */
  rknpu_sram: rknpu-sram@0 {
      reg = <0x0 0x78000>; // 480KB
  };
};
Ordnen Sie die allokierte SRAM dem RKNPU-Knoten zu und ändern Sie die dtsi-Datei wie folgt:
<path-to-your-kernel>/arch/arm64/boot/dts/rockchip/rk3576.dtsi
rknpu: npu@27700000 {
  compatible = "rockchip,rk3576-rknpu";
  /* ... /
  / Add reference RKNPU sram */
  rockchip,sram = <&rknpu_sram>;
  status = "disabled";
};
5.7.1.2 Anforderungen an die RKNN-SDK-Version
Version der RKNPU-Runtime-Bibliothek (librknnrt.so) >=1.6.0
5.7.2 Verwendung
Setzen Sie RKNN_FLAG_ENABLE_SRAM im flags-Parameter von rknn_init(), um SRAM für diesen Kontext zu aktivieren.
Beispiel:
ret = rknn_init(&ctx, rknn_model, size, RKNN_FLAG_ENABLE_SRAM, NULL);
Bei gesetztem RKNN_FLAG_ENABLE_SRAM wird möglichst viel verfügbare System-SRAM für den Internal-Tensor-Speicher des Modells allokiert.
Hinweis:
Belegt ein rknn-Kontext einen SRAM-Bereich, können andere Kontexte diesen nicht wiederverwenden. RKNN_FLAG_SHARE_SRAM in rknn_api.h ist noch nicht implementiert.
Belegt ein Kontext nicht die gesamte SRAM, kann der Rest von anderen rknn-Kontexten verwendet werden.
5.7.3 Debugging
5.7.3.1 SRAM-Aktivierung prüfen
Prüfen Sie im Kernel-Bootprotokoll, ob SRAM aktiviert ist; dort stehen Adressbereich und Größe der RKNPU-SRAM:
rk3588_s:/ # dmesg | grep rknpu -i
RKNPU fdab0000.npu: RKNPU: sram region: [0x00000000ff001000, 0x00000000ff0f0000), sram size: 0xef000
5.7.3.2 SRAM-Nutzung abfragen
Die SRAM-Nutzung kann über Knoten abgefragt werden.
Bitmap ungenutzter SRAM; jeder Punkt entspricht 4K:
rk3588_s:/ # cat /sys/kernel/debug/rknpu/mm
SRAM bitmap: "*" - used, "." - free (1bit = 4KB)
[000] [................................]
[001] [................................]
[002] [................................]
[003] [................................]
[004] [................................]
[005] [................................]
[006] [................................]
[007] [...............]
SRAM total size: 978944, used: 0, free: 978944
# Unit is Byte
Bitmap nach Verwendung von 512KB SRAM:
rk3588_s:/ # cat /sys/kernel/debug/rknpu/mm
SRAM bitmap: "*" - used, "." - free (1bit = 4KB)
[000] [********************************]
[001] [********************************]
[002] [********************************]
[003] [********************************]
[004] [................................]
[005] [................................]
[006] [................................]
[007] [...............]
SRAM total size: 978944, used: 524288, free: 454656
# Unit is Byte
5.7.3.3 SRAM-Größe über die RKNN-API abfragen
Fragen Sie die SRAM-Größe über RKNN_QUERY_MEM_SIZE von rknn_query() ab.
typedef struct _rknn_mem_size {
  uint32_t total_weight_size;
  uint32_t total_internal_size;
  uint64_t total_dma_allocated_size;
  uint32_t total_sram_size;
  uint32_t free_sram_size;
  uint32_t reserved[10];
} rknn_mem_size;
total_sram_size ist die gesamte vom System für RKNPU zugewiesene SRAM-Größe in Byte.
free_sram_size ist die verbleibende verfügbare SRAM-Größe für RKNPU in Byte.
5.7.3.4 SRAM-Belegung des Modells abfragen
Setzen Sie vor dem Start der RKNN-Anwendung auf dem Gerät folgende Umgebungsvariable, um die prognostizierte SRAM-Nutzung auszugeben:
export RKNN_LOG_LEVEL=3
Die schichtweise Belegung der für Internal allokierten SRAM zeigt folgendes Protokoll:
---------------------------------------------------------------------------
Total allocated Internal SRAM Size: 524288, Addr: [0xff3e0000, 0xff460000)
---------------------------------------------------------------------------
---------------------------------------------------------------------+----------------------------------+-----------
ID User Tensor DataType OrigShape NativeShape | [Start End) Size | SramHit
---------------------------------------------------------------------+----------------------------------+-----------
1 ConvRelu input0 INT8 (1,3,224,224) (1,1,224,224,3) | 0xff3b0000 0xff3d4c00 0x00024c00 | \
2 ConvRelu output2 INT8 (1,32,112,112) (1,2,112,112,16) | 0xff404c00 0xff466c00 0x00062000 |
0x0005b400
3 ConvRelu output4 INT8 (1,32,112,112) (1,4,112,112,16) | 0xff466c00 0xff52ac00 0x000c4000 |
0x00000000
4 ConvRelu output6 INT8 (1,64,112,112) (1,4,112,112,16) | 0xff52ac00*0xff5eec00 0x000c4000 |
0x00000000
5 ConvRelu output8 INT8 (1,64,56,56) (1,4,56,56,16) | 0xff3e0000 0xff411000 0x00031000 |
0x00031000
6 ConvRelu output10 INT8 (1,128,56,56) (1,8,56,56,16) | 0xff411000 0xff473000 0x00062000 |
0x0004f000
7 ConvRelu output12 INT8 (1,128,56,56) (1,8,56,56,16) | 0xff473000 0xff4d5000 0x00062000 |
0x00000000
8 ConvRelu output14 INT8 (1,128,56,56) (1,8,56,56,16) | 0xff3e0000 0xff442000 0x00062000 |
0x00062000
9 ConvRelu output16 INT8 (1,128,28,28) (1,8,28,28,16) | 0xff442000 0xff45a800 0x00018800 |
0x00018800
10 ConvRelu output18 INT8 (1,256,28,28) (1,16,28,28,16) | 0xff3e0000 0xff411000 0x00031000 |
0x00031000
11 ConvRelu output20 INT8 (1,256,28,28) (1,16,28,28,16) | 0xff411000 0xff442000 0x00031000 |
0x00031000
12 ConvRelu output22 INT8 (1,256,28,28) (1,16,28,28,16) | 0xff3e0000 0xff411000 0x00031000 |
0x00031000
13 ConvRelu output24 INT8 (1,256,14,14) (1,16,14,14,16) | 0xff411000 0xff41d400 0x0000c400 |
0x0000c400
14 ConvRelu output26 INT8 (1,512,14,14) (1,32,14,14,16) | 0xff3e0000 0xff3f8800 0x00018800 |
0x00018800
15 ConvRelu output28 INT8 (1,512,14,14) (1,32,14,14,16) | 0xff3f8800 0xff411000 0x00018800 |
0x00018800
16 ConvRelu output30 INT8 (1,512,14,14) (1,32,14,14,16) | 0xff3e0000 0xff3f8800 0x00018800 |
0x00018800
17 ConvRelu output32 INT8 (1,512,14,14) (1,32,14,14,16) | 0xff3f8800 0xff411000 0x00018800 |
0x00018800
18 ConvRelu output34 INT8 (1,512,14,14) (1,32,14,14,16) | 0xff3e0000 0xff3f8800 0x00018800 |
0x00018800
19 ConvRelu output36 INT8 (1,512,14,14) (1,32,14,14,16) | 0xff3f8800 0xff411000 0x00018800 |
0x00018800
20 ConvRelu output38 INT8 (1,512,14,14) (1,32,14,14,16) | 0xff3e0000 0xff3f8800 0x00018800 |
0x00018800
21 ConvRelu output40 INT8 (1,512,14,14) (1,32,14,14,16) | 0xff3f8800 0xff411000 0x00018800 |
0x00018800
22 ConvRelu output42 INT8 (1,512,14,14) (1,32,14,14,16) | 0xff3e0000 0xff3f8800 0x00018800 |
0x00018800
23 ConvRelu output44 INT8 (1,512,14,14) (1,32,14,14,16) | 0xff3f8800 0xff411000 0x00018800 |
0x00018800
24 ConvRelu output46 INT8 (1,512,14,14) (1,32,14,14,16) | 0xff3e0000 0xff3f8800 0x00018800 |
0x00018800
25 ConvRelu output48 INT8 (1,512,7,7) (1,33,7,7,16) | 0xff3f8800 0xff3ff000 0x00006800 | 0x00006800
26 ConvRelu output50 INT8 (1,1024,7,7) (1,67,7,7,16) | 0xff3e0000 0xff3ed000 0x0000d000 |
0x0000d000
27 ConvRelu output52 INT8 (1,1024,7,7) (1,67,7,7,16) | 0xff3ed000 0xff3fa000 0x0000d000 |
0x0000d000
28 AveragePool output54 INT8 (1,1024,7,7) (1,67,7,7,16) | 0xff3e0000 0xff3ed000 0x0000d000 |
0x0000d000
29 Conv output55 INT8 (1,1024,1,1) (1,64,1,1,16) | 0xff3ed000 0xff3ed400 0x00000400 | 0x00000400
30 Softmax output56 INT8 (1,1000,1,1) (1,64,1,1,16) | 0xff3e0000 0xff3e0400 0x00000400 |
0x00000400
31 OutputOperator output57 FLOAT (1,1000,1,1) (1,1000,1,1) | 0xff3ae000 0xff3aefa0 0x00000fa0 | \
---------------------------------------------------------------------+----------------------------------+-----------
----------------------------------------
Total Weight Memory Size: 4260864
Total Internal Memory Size: 2157568
Predict Internal Memory RW Amount: 11068320
Predict Weight Memory RW Amount: 4260832
Predict SRAM Hit RW Amount: 6688768
----------------------------------------
SRAM Hit bezeichnet in der Tabelle die SRAM-Größe des Tensors der aktuellen Schicht und damit die gegenüber dem Betrieb ohne SRAM eingesparte DDR-Lese-/Schreibdatenmenge.
Predict SRAM Hit RW Amount ist die prognostizierte SRAM-Lese-/Schreibmenge des gesamten Modells und zeigt die pro Frame gegenüber dem Betrieb ohne SRAM eingesparte DDR-Datenmenge.
Hinweis: Unter Linux werden Protokolle ins Terminal umgeleitet, unter Android nach logcat.
5.8 Modell-Pruning
Pruning kann verlustbehaftet oder verlustfrei sein. RKNN-Toolkit2 verwendet verlustfreies Pruning: Modellgröße und Rechenaufwand werden ohne Verschlechterung der Gleitkommagenauigkeit reduziert. Die Quantisierungsgenauigkeit kann sich sogar verbessern.
Nicht jedes Modell lässt sich verlustfrei beschneiden. Das Verfahren nutzt die Gewichtssparsität, um ergebnisneutrale Gewichte und Merkmalskanäle zu entfernen und so Größe und Rechenaufwand zu reduzieren. Bei model_pruning=True in rknn.config() erfolgt das Pruning während der Konvertierung automatisch entsprechend der Gewichtssparsität.
Bei erfolgreichem Pruning erscheint folgendes Ergebnis:
I model_pruning results:

I Weight: -1.12145 MB (-6.9%)

I GFLOPs: -0.15563 (-13.4%)
Hier wurden 1.12145 MB Gewichte beziehungsweise 6.9% entfernt und der Rechenaufwand um 0.15563 GFLOPs beziehungsweise 13.4% verringert.
Bei unzureichender Sparsität erfolgt keine Bearbeitung und auch keine entsprechende Ausgabe. Die Einstellung beeinträchtigt daher die normale Modellkonvertierung nicht.
5.9 Modellverschlüsselung
Die Verschlüsselung ist eine Nachbearbeitung nach dem Erstellen des RKNN-Modells. Die Struktur eines mit rknn.export_rknn() exportierten Modells kann mit Drittwerkzeugen wie Netron betrachtet werden. Nach der Verschlüsselung können solche Werkzeuge Struktur und Gewichte nicht mehr auslesen, wodurch das Modell geschützt wird. Verschlüsselte Modelle werden wie unverschlüsselte verwendet; Änderungen an der RKNPU-Inferenz sind nicht erforderlich. Passwortschutz wird im Original als zukünftige Möglichkeit genannt.
Verwendung:
# Create RKNN object
rknn = RKNN()
# Export encrypted RKNN model
crypt_level= 1
ret = rknn.export_encrypted_rknn_model("input.rknn", "encrypt.rknn", crypt_level)
if ret != 0:
  print('Encrypt RKNN model failed!')
crypt_level legt die Stufe 1, 2 oder 3 fest; Standard ist 1. Eine höhere Stufe erhöht die Sicherheit und die Entschlüsselungsdauer, eine niedrigere entsprechend umgekehrt.
Unterstützte Plattformen: RK3562/RK3566/RK3568/RK3576/RK3588/RV1126B.
5.10 Konsistenz cachefähigen Speichers
Greifen CPU und NPU auf denselben cachefähigen Speicher zu, hält die CPU Daten im Cache. Weichen die von der NPU gelesenen DDR-Daten davon ab, entstehen Lesefehler. Eine Cache-Aktualisierung muss deshalb konsistente Daten für CPU und NPU sicherstellen. Dieser Abschnitt beschreibt Synchronisationsrichtung und Verwendung von rknn_mem_sync.
5.10.1 Synchronisationsrichtung cachefähigen Speichers
Nach CPU-Schreibzugriffen müssen die CPU-Cache-Daten vor einem NPU-Zugriff mit DDR synchronisiert werden: Richtung CPU→NPU. Nach NPU-Schreibzugriffen muss vor dem CPU-Lesen die Konsistenz zwischen DDR und CPU-Cache hergestellt werden: Richtung NPU→CPU. Die RKNN-C-API bietet dafür die Enumeration rknn_mem_sync_mode. Datenstruktur:
/*
  The mode to sync cacheable rknn memory.
*/
typedef enum _rknn_mem_sync_mode {
RKNN_MEMORY_SYNC_TO_DEVICE = 0x1, /* the mode used for consistency of device access after CPU accesses
data. */
RKNN_MEMORY_SYNC_FROM_DEVICE = 0x2, /* the mode used for consistency of CPU access after device
accesses data. */
RKNN_MEMORY_SYNC_BIDIRECTIONAL =
  RKNN_MEMORY_SYNC_TO_DEVICE | RKNN_MEMORY_SYNC_FROM_DEVICE, /* the mode used for
consistency of data access
between device and CPU in both directions. */
} rknn_mem_sync_mode;
RKNN_MEMORY_SYNC_TO_DEVICE: Synchronisation von CPU zu NPU.
RKNN_MEMORY_SYNC_FROM_DEVICE: Synchronisation von NPU zu CPU.
RKNN_MEMORY_SYNC_BIDIRECTIONAL: Synchronisation in beide Richtungen zwischen NPU und CPU. Verwendbar, wenn die Datenrichtung nicht sicher bekannt ist.
Ist die Richtung bekannt, wird eine einseitige CPU-Cache-Aktualisierung empfohlen, um Leistungseinbußen durch unnötige Operationen zu vermeiden.
5.10.2 Cachefähigen Speicher synchronisieren
Nach Festlegen der Richtung synchronisieren Sie den Speicher mit rknn_mem_sync. Schnittstellenform:
int rknn_mem_sync(rknn_context context, rknn_tensor_mem* mem, rknn_mem_sync_mode mode);
Dabei bezeichnet context den Kontext (auf anderen Plattformen als RV1103/RV1103B/RV1106/RV1106B standardmäßig NULL), mem den von rknn_create_mem zurückgegebenen Zeiger vom Typ rknn_tensor_mem* und mode die Richtung der Datensynchronisierung.
5.11 Inferenz mit dünn besetzten Modellen
Diese Funktion dünnt die Gewichte eines Torch-Modells während des Trainings automatisch aus und verwendet RKNN für die Inferenz mit dünn besetzten Gewichten, um die Inferenzzeit zu verkürzen. Derzeit wird nur RK3576 unterstützt.
5.11.1 Prinzip der Ausdünnung
Während des Trainings werden ausgewählte Gewichte nach einer benutzerdefinierten Regel auf null gesetzt. Vorgesehen sind 4:2-Ausdünnung in Eingaberichtung, 4:2 in Ausgaberichtung sowie 16:4 in Eingabe-/Ausgaberichtung und 16:4 in Ausgabe-/Eingaberichtung. Abbildung 5-16 zeigt das 4:2-Prinzip in Eingaberichtung: Von vier aufeinanderfolgenden Gewichten werden zwei auf null gesetzt. Ist die Größe in der angegebenen Richtung nicht durch 4 teilbar, wird aufgefüllt. Die Kanalzahl der auszudünnenden Gewichte muss größer als 32 sein, damit die Ausdünnung wirksam wird.
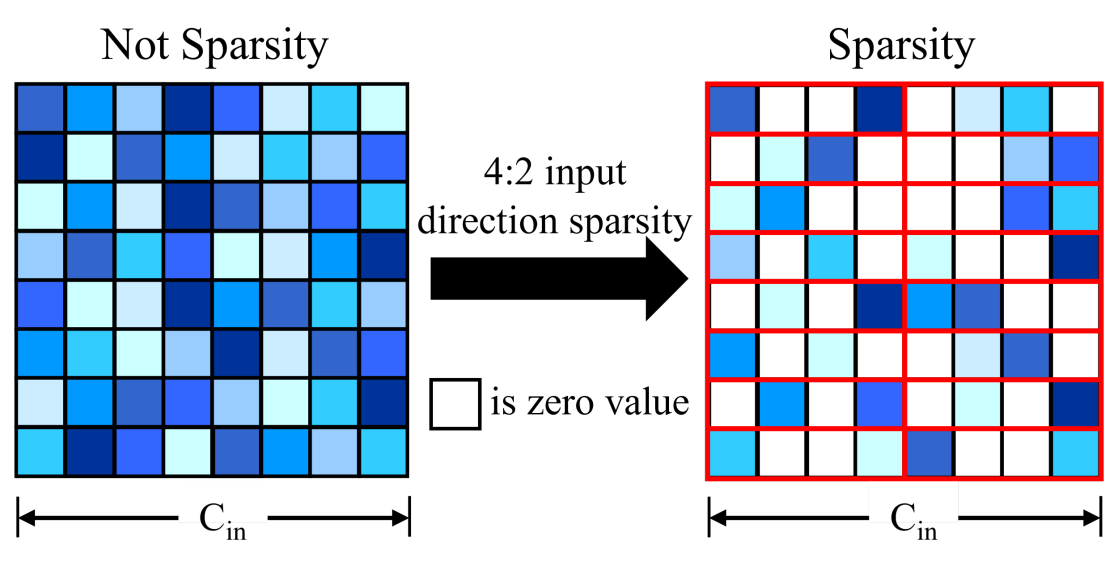
Abbildung 5-16: Prinzip der 4:2-Ausdünnung in Eingaberichtung
Tabelle 5-10 beschreibt die vier Ausdünnungsarten. Eingabe- und Ausgaberichtung beziehen sich auf die Gewichte. Die Gewichtsform einer zweidimensionalen Faltung ist beispielsweise C_out × C_in × K_h × K_w; C_in bezeichnet die Eingaberichtung, C_out die Ausgaberichtung. Bei einer Dünnbesetzung von 75 % kann ein dichtes oder bereits dünn besetztes vortrainiertes Modell verwendet werden. Zur Verringerung des Genauigkeitsverlusts empfiehlt sich ein vortrainiertes Modell mit 4:2-Ausdünnung in Eingabe- oder Ausgaberichtung.
Tabelle 5-10: Ausdünnungsarten für Modellgewichte
| Sparsifizierungsmethode | Sparsitätsgrad | Spezifikation |
|---|---|---|
| 4:2-Sparsifizierung in Eingangsrichtung | 50% | Gewichte in Eingangsrichtung sparsifizieren |
| 4:2-Sparsifizierung in Ausgangsrichtung | 50% | Gewichte in Ausgangsrichtung sparsifizieren |
| 16:4-Sparsifizierung in Eingangs- und Ausgangsrichtung | 75% | Zuerst 4:2-Sparsifizierung in Eingangsrichtung, dann 4:2 in Ausgangsrichtung |
| 16:4-Sparsifizierung in Ausgangs- und Eingangsrichtung | 75% | Zuerst 4:2-Sparsifizierung in Ausgangsrichtung, dann 4:2 in Eingangsrichtung |
5.11.2 Training eines dünn besetzten Modells
1. Sicherstellen, dass cuda verfügbar ist, und das Paket autosparsity installieren.
pip install autosparsity-1.0-cp38-cp38m-linux_x86_64.whl
Das Installationspaket für autosparsity befindet sich unter https://github.com/airockchip/rknn-toolkit2/tree/master/autosparsity/packages
2. Beispiel für automatische 4:2-Ausdünnung in Eingaberichtung von resnet50 aus torchvision:
import torch
import torchvision.models as models
from autosparsity.sparsity import sparsity_model

if __name__ == "__main__":
  model = models.resnet50(pretrained=True).cuda()
  optimizer = None
  mode = 0
  sparsity_model(model, optimizer, mode)
  model.eval()
  x = torch.randn((1,3,224,224)).cuda()
  torch.onnx.export(
  model, x, 'resnet50.onnx', input_names=['inputs'], output_names=['outputs']
  )
Für ein eigenes Modell genügt es, vor dem Training sparsity_model aufzurufen. Beispiel:
# insert model autosparsity code before training
import torch
import torchvision.models as models
from autosparsity.sparsity import sparsity_model

...

model = models.resnet34(pretrained=True).cuda()
mode = 0
sparsity_model(model, optimizer, mode)

# normal training
x, y = DataLoader(args)
for epoch in range(epochs):
  y_pred = model(x)
  loss = loss_func(y_pred, y)
  loss.backward()
  optimizer.step()
  ...
Hinweis: Das Training mit Ausdünnung setzt ein bereits trainiertes Ausgangsmodell voraus. Zunächst sollte daher ein Modell mit guten Ergebnissen trainiert werden; darauf aufbauend erfolgt das Training mit Ausdünnung.
Parameter der Funktion sparsity_model:
Tabelle 5-11: Parameter der Funktion sparsity_model
| Parameter | Spezifikation |
|---|---|
| model | Ursprüngliches Trainingsmodell |
| optimizer | Ursprünglicher Optimierer; Standardwert None |
| mode | Sparsifizierungsmethode; Werte 0, 1, 2, 3, Standardwert 0. 0: 4:2 in Eingangsrichtung (50% Sparsität); 1: 4:2 in Ausgangsrichtung (50%); 2: 16:4 in Eingangs- und anschließend Ausgangsrichtung (75%); 3: 16:4 in Ausgangs- und anschließend Eingangsrichtung (75%). |
| verbose | Protokollierungsstufe: 0, 1, 2; Standardwert 2. 0: Fehler; 1: Fehler und Warnungen; 2: Fehler, Warnungen und Informationen. |
| whitelist | Liste der für Sparsifizierung unterstützten Module: 1d conv, 2d conv, 3d conv, linear, MultiheadAttention. Standardwert [torch.nn.Linear, torch.nn.Conv2d]. |
| allowed_layer_names | Namen der zur Sparsifizierung zugelassenen Schichten. Bei Benutzerkonfiguration werden nur zugelassene Schichten sparsifiziert. Standardwert None. |
| disallowed_layer_names | Namen von Schichten, für die Sparsifizierung unzulässig ist. Vom Benutzer konfigurierte Schichten werden übersprungen. Standardwert []. |
| fast | True aktiviert ein schnelles Verfahren zur Maskenberechnung; Standardwert False. Das standardmäßige Verfahren funktioniert bei manchen Modellen nicht; bei einem Sparsifizierungsfehler versuchsweise True setzen. |
5.11.3 Dünn besetzte Inferenz mit RKNN verwenden
Der Parameter sparse_infer der Schnittstelle config() in RKNN-Toolkit2 aktiviert oder deaktiviert die dünn besetzte Inferenz. Zulässig sind True/False, standardmäßig False. Beispiel zum Aktivieren:
rknn.config(target_platform=’rk3576’, sparse_infer=True)
Vollständiges Python-Beispiel: https://github.com/airockchip/rknn-toolkit2/tree/master/autosparsity/examples
Für die Bereitstellung über die C API zunächst in RKNN-Toolkit2 sparse_infer=True in config() setzen und ein entsprechendes RKNN-Modell erzeugen. Anschließend den üblichen Ablauf der allgemeinen API oder der Zero-Copy-Schnittstelle verwenden.
Bei Python-Inferenz aktiviert verbose=True beim Erzeugen des RKNN-Objekts die Protokollierung der Dünnbesetzung jeder Schicht. Für die C API wird die Umgebungsvariable RKNN_LOG_LEVEL=4 gesetzt. Beispielprotokolle:
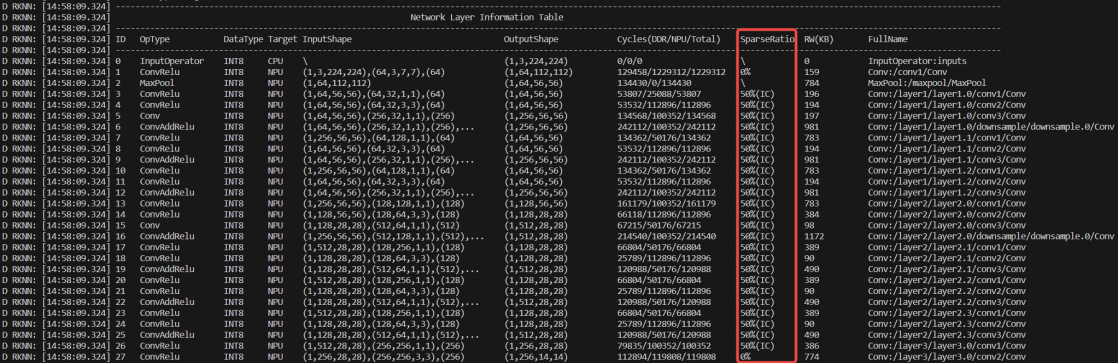
| Log prefix | ID | OpType | DataType | Target | InputShape | OutputShape | Cycles(DDR/NPU/Total) | SparseRatio | RW(KB) | FullName |
|---|---|---|---|---|---|---|---|---|---|---|
| D RKNN: [14:58:09.324] | 0 | InputOperator | INT8 | CPU | \ | (1,3,224,224) | 0/0/0 | \ | 0 | InputOperator:inputs |
| D RKNN: [14:58:09.324] | 1 | ConvRelu | INT8 | NPU | (1,3,224,224),(64,3,7,7),(64) | (1,64,112,112) | 129458/1229312/1229312 | 0% | 159 | Conv:/conv1/Conv |
| D RKNN: [14:58:09.324] | 2 | MaxPool | INT8 | NPU | (1,64,112,112) | (1,64,56,56) | 134430/0/134430 | \ | 784 | MaxPool:/maxpool/MaxPool |
| D RKNN: [14:58:09.324] | 3 | ConvRelu | INT8 | NPU | (1,64,56,56),(64,32,1,1),(64) | (1,64,56,56) | 53807/25088/53807 | 50%(IC) | 196 | Conv:/layer1/layer1.0/conv1/Conv |
| D RKNN: [14:58:09.324] | 4 | ConvRelu | INT8 | NPU | (1,64,56,56),(64,32,3,3),(64) | (1,64,56,56) | 53532/112896/112896 | 50%(IC) | 194 | Conv:/layer1/layer1.0/conv2/Conv |
| D RKNN: [14:58:09.324] | 5 | Conv | INT8 | NPU | (1,64,56,56),(256,32,1,1),(256) | (1,256,56,56) | 134568/100352/134568 | 50%(IC) | 197 | Conv:/layer1/layer1.0/conv3/Conv |
| D RKNN: [14:58:09.324] | 6 | ConvAddRelu | INT8 | NPU | (1,64,56,56),(256,32,1,1),(256),… | (1,256,56,56) | 242112/100352/242112 | 50%(IC) | 981 | Conv:/layer1/layer1.0/downsample/downsample.0/Conv |
| D RKNN: [14:58:09.324] | 7 | ConvRelu | INT8 | NPU | (1,256,56,56),(64,128,1,1),(64) | (1,64,56,56) | 134362/50176/134362 | 50%(IC) | 783 | Conv:/layer1/layer1.1/conv1/Conv |
| D RKNN: [14:58:09.324] | 8 | ConvRelu | INT8 | NPU | (1,64,56,56),(64,32,3,3),(64) | (1,64,56,56) | 53532/112896/112896 | 50%(IC) | 194 | Conv:/layer1/layer1.1/conv2/Conv |
| D RKNN: [14:58:09.324] | 9 | ConvAddRelu | INT8 | NPU | (1,64,56,56),(256,32,1,1),(256),… | (1,256,56,56) | 242112/100352/242112 | 50%(IC) | 981 | Conv:/layer1/layer1.1/conv3/Conv |
| D RKNN: [14:58:09.324] | 10 | ConvRelu | INT8 | NPU | (1,256,56,56),(64,128,1,1),(64) | (1,64,56,56) | 134362/50176/134362 | 50%(IC) | 783 | Conv:/layer1/layer1.2/conv1/Conv |
| D RKNN: [14:58:09.324] | 11 | ConvRelu | INT8 | NPU | (1,64,56,56),(64,32,3,3),(64) | (1,64,56,56) | 53532/112896/112896 | 50%(IC) | 194 | Conv:/layer1/layer1.2/conv2/Conv |
| D RKNN: [14:58:09.324] | 12 | ConvAddRelu | INT8 | NPU | (1,64,56,56),(256,32,1,1),(256),… | (1,256,56,56) | 242112/100352/242112 | 50%(IC) | 981 | Conv:/layer1/layer1.2/conv3/Conv |
| D RKNN: [14:58:09.324] | 13 | ConvRelu | INT8 | NPU | (1,256,56,56),(128,128,1,1),(128) | (1,128,56,56) | 161179/100352/161179 | 50%(IC) | 783 | Conv:/layer2/layer2.0/conv1/Conv |
| D RKNN: [14:58:09.324] | 14 | ConvRelu | INT8 | NPU | (1,128,56,56),(128,64,3,3),(128) | (1,128,28,28) | 66118/112896/112896 | 50%(IC) | 384 | Conv:/layer2/layer2.0/conv2/Conv |
| D RKNN: [14:58:09.324] | 15 | Conv | INT8 | NPU | (1,128,28,28),(512,64,1,1),(512) | (1,512,28,28) | 67215/50176/67215 | 50%(IC) | 98 | Conv:/layer2/layer2.0/conv3/Conv |
| D RKNN: [14:58:09.324] | 16 | ConvAddRelu | INT8 | NPU | (1,256,56,56),(512,128,1,1),(512),… | (1,512,28,28) | 214540/100352/214540 | 50%(IC) | 1172 | Conv:/layer2/layer2.0/downsample/downsample.0/Conv |
| D RKNN: [14:58:09.324] | 17 | ConvRelu | INT8 | NPU | (1,512,28,28),(128,256,1,1),(128) | (1,128,28,28) | 66804/50176/66804 | 50%(IC) | 389 | Conv:/layer2/layer2.1/conv1/Conv |
| D RKNN: [14:58:09.324] | 18 | ConvRelu | INT8 | NPU | (1,128,28,28),(128,64,3,3),(128) | (1,128,28,28) | 25789/112896/112896 | 50%(IC) | 90 | Conv:/layer2/layer2.1/conv2/Conv |
| D RKNN: [14:58:09.324] | 19 | ConvAddRelu | INT8 | NPU | (1,128,28,28),(512,64,1,1),(512),… | (1,512,28,28) | 120988/50176/120988 | 50%(IC) | 490 | Conv:/layer2/layer2.1/conv3/Conv |
| D RKNN: [14:58:09.324] | 20 | ConvRelu | INT8 | NPU | (1,512,28,28),(128,256,1,1),(128) | (1,128,28,28) | 66804/50176/66804 | 50%(IC) | 389 | Conv:/layer2/layer2.2/conv1/Conv |
| D RKNN: [14:58:09.324] | 21 | ConvRelu | INT8 | NPU | (1,128,28,28),(128,64,3,3),(128) | (1,128,28,28) | 25789/112896/112896 | 50%(IC) | 90 | Conv:/layer2/layer2.2/conv2/Conv |
| D RKNN: [14:58:09.324] | 22 | ConvAddRelu | INT8 | NPU | (1,128,28,28),(512,64,1,1),(512),… | (1,512,28,28) | 120988/50176/120988 | 50%(IC) | 490 | Conv:/layer2/layer2.2/conv3/Conv |
| D RKNN: [14:58:09.324] | 23 | ConvRelu | INT8 | NPU | (1,512,28,28),(128,256,1,1),(128) | (1,128,28,28) | 66804/50176/66804 | 50%(IC) | 389 | Conv:/layer2/layer2.3/conv1/Conv |
| D RKNN: [14:58:09.324] | 24 | ConvRelu | INT8 | NPU | (1,128,28,28),(128,64,3,3),(128) | (1,128,28,28) | 25789/112896/112896 | 50%(IC) | 90 | Conv:/layer2/layer2.3/conv2/Conv |
| D RKNN: [14:58:09.324] | 25 | ConvAddRelu | INT8 | NPU | (1,128,28,28),(512,64,1,1),(512),… | (1,512,28,28) | 120988/50176/120988 | 50%(IC) | 490 | Conv:/layer2/layer2.3/conv3/Conv |
| D RKNN: [14:58:09.324] | 26 | ConvRelu | INT8 | NPU | (1,512,28,28),(256,256,1,1),(256) | (1,256,28,28) | 79835/100352/100352 | 50%(IC) | 386 | Conv:/layer3/layer3.0/conv1/Conv |
| D RKNN: [14:58:09.324] | 27 | ConvRelu | INT8 | NPU | (1,256,28,28),(256,256,3,3),(256) | (1,256,14,14) | 112894/119808/119808 | 0% | 774 | Conv:/layer3/layer3.0/conv2/Conv |
Abbildung 5-17: Python-Protokoll für 4:2-Ausdünnung in Eingaberichtung
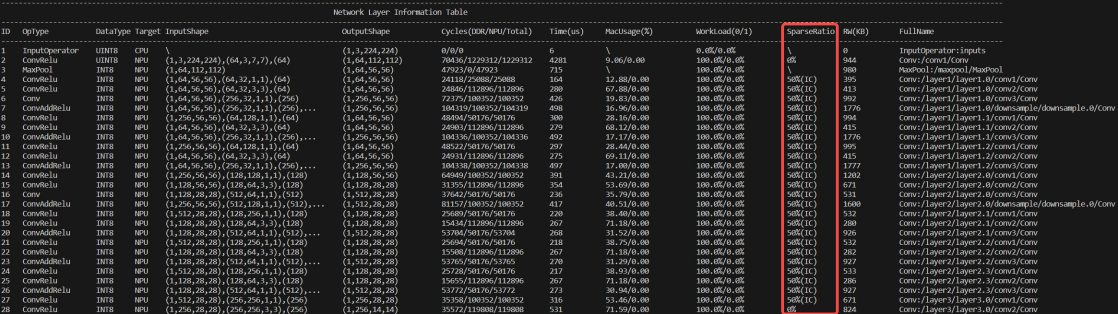
| ID | OpType | DataType | Target | InputShape | OutputShape | Cycles(DDR/NPU/Total) | Time(us) | MacUsage(%) | WorkLoad(0/1) | SparseRatio | RW(KB) | FullName |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | InputOperator | UINT8 | CPU | \ | (1,3,224,224) | 0/0/0 | 6 | \ | 0.0%/0.0% | \ | 0 | InputOperator:inputs |
| 2 | ConvRelu | INT8 | NPU | (1,3,224,224),(64,3,7,7),(64) | (1,64,112,112) | 70436/1229312/1229312 | 4281 | 9.06/0.00 | 100.0%/0.0% | 0% | 944 | Conv:/conv1/Conv |
| 3 | MaxPool | INT8 | NPU | (1,64,112,112) | (1,64,56,56) | 47923/0/47923 | 715 | \ | 100.0%/0.0% | \ | 980 | MaxPool:/maxpool/MaxPool |
| 4 | ConvRelu | INT8 | NPU | (1,64,56,56),(64,32,1,1),(64) | (1,64,56,56) | 24118/25088/25088 | 164 | 12.88/0.00 | 100.0%/0.0% | 50%(IC) | 395 | Conv:/layer1/layer1.0/conv1/Conv |
| 5 | ConvRelu | INT8 | NPU | (1,64,56,56),(64,32,3,3),(64) | (1,64,56,56) | 24846/112896/112896 | 280 | 67.88/0.00 | 100.0%/0.0% | 50%(IC) | 413 | Conv:/layer1/layer1.0/conv2/Conv |
| 6 | Conv | INT8 | NPU | (1,64,56,56),(256,32,1,1),(256) | (1,256,56,56) | 72375/100352/100352 | 426 | 19.83/0.00 | 100.0%/0.0% | 50%(IC) | 992 | Conv:/layer1/layer1.0/conv3/Conv |
| 7 | ConvAddRelu | INT8 | NPU | (1,64,56,56),(256,32,1,1),(256),… | (1,256,56,56) | 104319/100352/104319 | 498 | 16.96/0.00 | 100.0%/0.0% | 50%(IC) | 1776 | Conv:/layer1/layer1.0/downsample/downsample.0/Conv |
| 8 | ConvRelu | INT8 | NPU | (1,256,56,56),(64,128,1,1),(64) | (1,64,56,56) | 48494/50176/50176 | 300 | 28.16/0.00 | 100.0%/0.0% | 50%(IC) | 994 | Conv:/layer1/layer1.1/conv1/Conv |
| 9 | ConvRelu | INT8 | NPU | (1,64,56,56),(64,32,3,3),(64) | (1,64,56,56) | 24903/112896/112896 | 279 | 68.12/0.00 | 100.0%/0.0% | 50%(IC) | 415 | Conv:/layer1/layer1.1/conv2/Conv |
| 10 | ConvAddRelu | INT8 | NPU | (1,64,56,56),(256,32,1,1),(256),… | (1,256,56,56) | 104336/100352/104336 | 492 | 17.17/0.00 | 100.0%/0.0% | 50%(IC) | 1776 | Conv:/layer1/layer1.1/conv3/Conv |
| 11 | ConvRelu | INT8 | NPU | (1,256,56,56),(64,128,1,1),(64) | (1,64,56,56) | 48522/50176/50176 | 297 | 28.44/0.00 | 100.0%/0.0% | 50%(IC) | 995 | Conv:/layer1/layer1.2/conv1/Conv |
| 12 | ConvRelu | INT8 | NPU | (1,64,56,56),(64,32,3,3),(64) | (1,64,56,56) | 24931/112896/112896 | 275 | 69.11/0.00 | 100.0%/0.0% | 50%(IC) | 415 | Conv:/layer1/layer1.2/conv2/Conv |
| 13 | ConvAddRelu | INT8 | NPU | (1,64,56,56),(256,32,1,1),(256),… | (1,256,56,56) | 104338/100352/104338 | 497 | 17.00/0.00 | 100.0%/0.0% | 50%(IC) | 1777 | Conv:/layer1/layer1.2/conv3/Conv |
| 14 | ConvRelu | INT8 | NPU | (1,256,56,56),(128,128,1,1),(128) | (1,128,56,56) | 64949/100352/100352 | 391 | 43.21/0.00 | 100.0%/0.0% | 50%(IC) | 1202 | Conv:/layer2/layer2.0/conv1/Conv |
| 15 | ConvRelu | INT8 | NPU | (1,128,56,56),(128,64,3,3),(128) | (1,128,28,28) | 31355/112896/112896 | 354 | 53.69/0.00 | 100.0%/0.0% | 50%(IC) | 671 | Conv:/layer2/layer2.0/conv2/Conv |
| 16 | Conv | INT8 | NPU | (1,128,28,28),(512,64,1,1),(512) | (1,512,28,28) | 37642/50176/50176 | 236 | 35.79/0.00 | 100.0%/0.0% | 50%(IC) | 531 | Conv:/layer2/layer2.0/conv3/Conv |
| 17 | ConvAddRelu | INT8 | NPU | (1,256,56,56),(512,128,1,1),(512),… | (1,512,28,28) | 81157/100352/100352 | 417 | 40.51/0.00 | 100.0%/0.0% | 50%(IC) | 1600 | Conv:/layer2/layer2.0/downsample/downsample.0/Conv |
| 18 | ConvRelu | INT8 | NPU | (1,512,28,28),(128,256,1,1),(128) | (1,128,28,28) | 25689/50176/50176 | 220 | 38.40/0.00 | 100.0%/0.0% | 50%(IC) | 532 | Conv:/layer2/layer2.1/conv1/Conv |
| 19 | ConvRelu | INT8 | NPU | (1,128,28,28),(128,64,3,3),(128) | (1,128,28,28) | 15434/112896/112896 | 267 | 71.18/0.00 | 100.0%/0.0% | 50%(IC) | 280 | Conv:/layer2/layer2.1/conv2/Conv |
| 20 | ConvAddRelu | INT8 | NPU | (1,128,28,28),(512,64,1,1),(512),… | (1,512,28,28) | 53704/50176/53704 | 268 | 31.52/0.00 | 100.0%/0.0% | 50%(IC) | 926 | Conv:/layer2/layer2.1/conv3/Conv |
| 21 | ConvRelu | INT8 | NPU | (1,512,28,28),(128,256,1,1),(128) | (1,128,28,28) | 25694/50176/50176 | 218 | 38.75/0.00 | 100.0%/0.0% | 50%(IC) | 532 | Conv:/layer2/layer2.2/conv1/Conv |
| 22 | ConvRelu | INT8 | NPU | (1,128,28,28),(128,64,3,3),(128) | (1,128,28,28) | 15508/112896/112896 | 267 | 71.18/0.00 | 100.0%/0.0% | 50%(IC) | 282 | Conv:/layer2/layer2.2/conv2/Conv |
| 23 | ConvAddRelu | INT8 | NPU | (1,128,28,28),(512,64,1,1),(512),… | (1,512,28,28) | 53765/50176/53765 | 270 | 31.29/0.00 | 100.0%/0.0% | 50%(IC) | 927 | Conv:/layer2/layer2.2/conv3/Conv |
| 24 | ConvRelu | INT8 | NPU | (1,512,28,28),(128,256,1,1),(128) | (1,128,28,28) | 25728/50176/50176 | 217 | 38.93/0.00 | 100.0%/0.0% | 50%(IC) | 533 | Conv:/layer2/layer2.3/conv1/Conv |
| 25 | ConvRelu | INT8 | NPU | (1,128,28,28),(128,64,3,3),(128) | (1,128,28,28) | 15655/112896/112896 | 267 | 71.18/0.00 | 100.0%/0.0% | 50%(IC) | 286 | Conv:/layer2/layer2.3/conv2/Conv |
| 26 | ConvAddRelu | INT8 | NPU | (1,128,28,28),(512,64,1,1),(512),… | (1,512,28,28) | 53772/50176/53772 | 273 | 30.94/0.00 | 100.0%/0.0% | 50%(IC) | 927 | Conv:/layer2/layer2.3/conv3/Conv |
| 27 | ConvRelu | INT8 | NPU | (1,512,28,28),(256,256,1,1),(256) | (1,256,28,28) | 35358/100352/100352 | 316 | 53.46/0.00 | 100.0%/0.0% | 50%(IC) | 671 | Conv:/layer3/layer3.0/conv1/Conv |
| 28 | ConvRelu | INT8 | NPU | (1,256,28,28),(256,256,3,3),(256) | (1,256,14,14) | 35572/119808/119808 | 531 | 71.59/0.00 | 100.0%/0.0% | 0% | 824 | Conv:/layer3/layer3.0/conv2/Conv |
Abbildung 5-18: C-API-Protokoll für 4:2-Ausdünnung in Eingaberichtung
SparseRation bezeichnet den Anteil ausgedünnter Gewichte: 4:2 in Eingaberichtung entspricht 50%(IC), 4:2 in Ausgaberichtung 50%(OC), die beiden 16:4-Varianten (Eingabe/Ausgabe und Ausgabe/Eingabe) 75 %. 0 % bedeutet keine Ausdünnung. Die Schreibweise SparseRation stammt aus der Vorlage.
5.11.4 Einschränkungen der dünn besetzten RKNN-Inferenz
Die dünn besetzte Inferenz wird durch die NPU-Hardwarearchitektur umgesetzt. Aufgrund der Hardwarevorgaben unterstützt RK3576 derzeit nur 2d Conv mit group=1. Weitere Einschränkungen folgen unten.
Tabelle 5-12: Einschränkungen der dünn besetzten Inferenz auf RK3576
| Kanalzahl | Datentyp | |
|---|---|---|
| 4:2-Sparsifizierung in Eingangsrichtung | Eingang und Ausgang auf 32 ausgerichtet | Int8; Float16 nicht unterstützt |
| 4:2-Sparsifizierung in Ausgangsrichtung | Eingang und Ausgang auf 32 ausgerichtet | Int8; Float16 nicht unterstützt |
| 16:4-Sparsifizierung in Eingangs- und Ausgangsrichtung | Eingang und Ausgang auf 32 ausgerichtet | Int8; Float16 nicht unterstützt |
| 16:4-Sparsifizierung in Ausgangs- und Eingangsrichtung | Eingang und Ausgang auf 32 ausgerichtet | Int8; Float16 nicht unterstützt |
5.12 Codegen
RKNN-Toolkit2 2.0.0 ergänzt die Schnittstelle Codegen zur Erzeugung von Bereitstellungscode und erleichtert damit den Einstieg. Sie kapselt die Zero-Copy-CAPI; ihr Schnittstellenstil entspricht den Beispielen in RKNN_Model_Zoo. Der erzeugte Code ermöglicht unmittelbare Leistungstests und Genauigkeitsprüfungen und kann als Grundlage für eigene Weiterentwicklungen dienen.
Anwendungsbeispiel:
ret = rknn.codegen(output_path='./rknn_app_demo',
          inputs=['../../caffe/mobilenet_v2/dog_224x224.jpg'], overwrite=True)
Vor codegen muss rknn.export zum Speichern des RKNN-Modells aufgerufen werden. Der Name rknn.export ist aus dem Originaltext übernommen.
output_path bezeichnet das Ausgabeverzeichnis; dessen Namen kann der Benutzer festlegen.
Inputs enthält die Pfadliste der Modelleingaben und darf leer bleiben. Unterstützte Dateiformate sind jpg/png/npy. Bei npy müssen die Datendimensionen mit denen der Modelleingabe übereinstimmen.
Bei overwrite=True werden Dateien im Verzeichnis output_path überschrieben. Standardwert ist False.
Zum Kompilieren und Testen des erzeugten Codes die README.md im Ausgabeverzeichnis beachten.
Enthält inputs gültige Daten, bewertet das Beispiel nach der Inferenz die Unterschiede zwischen CAPI und RKNN-Toolkit2-Simulator anhand der Kosinusähnlichkeit jedes Ausgangs.
Keine Einschränkung auf eine bestimmte NPU-Hardwareplattform; das Board muss Linux oder Android verwenden.
Quantisierte und nicht quantisierte Modelle werden unterstützt.
5.13 ONNX bearbeiten
Nach der Konvertierung einiger Modelle nach RKNN können überflüssige Operationen verbleiben, insbesondere reshape und transpose an Ein- und Ausgängen, die die Inferenzleistung beeinträchtigen. Mit onnx_edit in RKNN-Toolkit2 lassen sich die Ein- und Ausgabedimensionen eines ONNX-Modells ändern, um bei der anschließenden Konvertierung ein leistungsfähigeres RKNN-Modell mit weniger unnötigen reshape- und transpose-Operationen zu erhalten.
5.13.1 Schnittstellenbeschreibung
Anwendungsbeispiel:
from rknn.utils import onnx_edit
ret = onnx_edit(model = './concat_block.onnx',
  export_path = './concat_block_edited.onnx',
  inputs_transform = {'k_in': 'a,b,c,d->1,ad,b,c'},
  outputs_transform = {'k_cache': 'a,b,c,d->1,ab,c,d'},
  dataset = './dataset.txt'
)
Model gibt das zu bearbeitende Modell an und ist erforderlich.
Export_path gibt den Ausgabepfad des neuen Modells an und ist erforderlich.
Inputs_transform ist ein Wörterbuch der Eingabetransformationen: Schlüssel ist der Knotenname, Wert die Transformationsformel. Optional; standardmäßig ein leeres Wörterbuch.
Outputs_transform ist ein Wörterbuch der Ausgangstransformationen. Optional; standardmäßig ein leeres Wörterbuch.
Dataset gibt eine Datei mit den Pfaden der Eingabedaten an; das Format entspricht dataset bei rknn.build. Ist es angegeben, passt onnx_edit neben den Ein- und Ausgabedefinitionen auch die zugehörigen Datensatzdaten an und erzeugt einen neuen Datensatz auf derselben Verzeichnisebene wie export_path. Dieser dient zur Prüfung und Quantisierung des neuen Modells. Optional; standardmäßig leer.
5.13.2 Transformationsformeln
inputs_transform und outputs_transform von onnx_edit enthalten Transformationsformeln mit einer dem Operator einsum ähnlichen Syntax. Beispielsweise transformiert ‘a,b,c,d->1,ad,b,c’ die ursprünglichen Dimensionen ‘a,b,c,d’ nach ‘1,ad,b,c’. Es gelten folgende Regeln:
Die Formel besteht aus zwei durch ‘->’ getrennten Teilen: links die ursprüngliche symbolische Form, rechts die transformierte.
Zulässig sind nur [a-z], ‘,’ und ‘1’. Andere Ziffern werden nicht unterstützt, weil identische Zahlensymbole den Kontext einer transpose-Operation nicht eindeutig bestimmen.
Die Zeichen [a-z] sind unabhängig und besitzen keine Reihenfolge: ‘a,b->b,a’ und ‘c,a->a,c’ bezeichnen dieselbe Transformation.
Die ursprüngliche Form links wird durch ‘,’ in n Teile getrennt; n muss der Dimensionszahl des Modells entsprechen. Für [32,4,1,64] sind beispielsweise ‘a,b,c,d’ oder ‘a,b,1,d’ zulässig.
Jedes ursprüngliche Symbol außer ‘1’ muss in der transformierten Form vorkommen. ‘a,1,c,d->ac,d,1’ ist beispielsweise gültig, ‘a,1,c,d->ac,1’ dagegen ungültig, weil ‘d’ fehlt.
In die transformierte Form dürfen beliebig viele ‘1’ eingefügt werden, um Dimensionen hinzuzufügen, beispielsweise ‘a,b,c-> a,1,cb,1,1’.
Zum Aufteilen einer Dimension erlaubt die ursprüngliche Form mehrere Buchstaben und Zuweisungen. Bei [32,4,1,64] bedeutet ‘ab,c,d,qk[a=2,k =8]->aq,cd,1,kb’: 32 in 2x16 und 64 in 8x8 aufteilen, anschließend transpose und reshape ausführen. Der Teil ‘[ ]’ enthält durch ‘,’ getrennte Zuweisungen. Nicht zugewiesene Werte werden automatisch abgeleitet: Bei a=2 und ab=32 ergibt sich b=16. Ungültige abgeleitete Dimensionen lösen einen Fehler aus: Bei ab=32 und a=5 wäre b=6.4, Dimensionen müssen jedoch ganzzahlig sein.
5.13.3 Beispiele für Transformationsformeln
Dreidimensionale Eingabe in vierdimensionale umwandeln: ‘a,b,c->a,b,1,c’
Fünfdimensionale Eingabe in vierdimensionale umwandeln: ‘a,b,c,d,e->ab,c,d,e’
Operation transpose(0,3,1,2): ‘a,b,c,d->a,d,b,c’
Dimensionen vertauschen und zusammenfassen: ‘a,b,c,d->d,acb,1’
Dimensionen aufteilen, vertauschen und zusammenfassen: ‘a,bc,de,f[b=2,d=4]->ab,fe,dc,1’
6 Einführung in die Quantisierung
6.1 Erläuterung der Quantisierung
6.1.1 Definition der Quantisierung
Modellquantisierung bezeichnet die Umwandlung der Gleitkommaparameter und -operationen eines Deep-Learning-Modells in Festkommadarstellungen, etwa von FLOAT32 nach INT8. Sie reduziert den Speicherbedarf, komprimiert das Modell und beschleunigt die Inferenz, kann jedoch einen gewissen Genauigkeitsverlust verursachen.
6.1.2 Berechnungsprinzip der Quantisierung
Am Beispiel der linearen asymmetrischen Quantisierung erfolgt die Umwandlung von Gleitkommazahlen in vorzeichenbehaftete Festkommazahlen nach folgendem Prinzip:
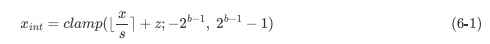
x_int = clamp(round(x / s) + z; -2^(b-1), 2^(b-1) - 1)
Dabei ist x die Gleitkommazahl, x_int die quantisierte Festkommazahl, round(·) die Rundung, s der Quantisierungsskalierungsfaktor, z der Nullpunkt und b die Quantisierungsbitbreite, beispielsweise 8 für INT8. clamp ist die Begrenzungsoperation und wird wie folgt definiert:
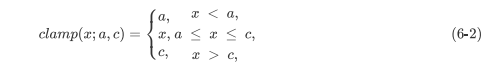
clamp(x; a, c) = a, if x < a
                 x, if a <= x <= c
                 c, if x > c
Die Umwandlung von Festkommazahlen in Gleitkommazahlen heißt Dequantisierung und ist wie folgt definiert:

x ≈ x_hat = s (x_int - z)
Bei gegebenem Quantisierungsbereich (q_min) und Begrenzungsbereich (c_min) werden die Quantisierungsparameter s und z mit folgenden Formeln berechnet:
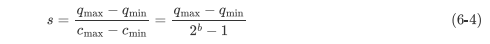
s = (q_max - q_min) / (c_max - c_min) = (q_max - q_min) / (2^b - 1)
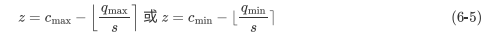
z = c_max - round(q_max / s) OR z = c_min - round(q_min / s)
Der Begrenzungsbereich wird durch den Quantisierungsdatentyp bestimmt, beispielsweise (-128, 127) für INT8. Der Quantisierungsbereich wird durch die jeweiligen Quantisierungsalgorithmen bestimmt; Einzelheiten stehen in Abschnitt 6.1.6 „Quantisierungsalgorithmen“.
6.1.3 Quantisierungsfehler
Die Quantisierung führt zu einem gewissen Genauigkeitsverlust. Nach Gleichung (6-1) entstehen Quantisierungsfehler durch Rundung und Begrenzung, also durch round(·) und clamp. Der Rundungsfehler liegt im Bereich (−s/2, s/2). Ist die Gleitkommazahl x zu groß und der Skalierungsfaktor s zu klein, kann die quantisierte Festkommazahl den Begrenzungsbereich überschreiten und einen Begrenzungsfehler verursachen. Ein größeres s kann theoretisch den Begrenzungsfehler verringern, erhöht jedoch den Rundungsfehler. Zum Ausgleich beider Fehler müssen geeignete Skalierungsfaktoren und Nullpunkte gewählt werden, die den Quantisierungsfehler minimieren.
6.1.4 Lineare symmetrische und lineare asymmetrische Quantisierung
Bei der linearen Quantisierung sind die Abstände zwischen Festkommazahlen gleichmäßig. Beispielsweise teilt die lineare INT8-Quantisierung den Bereich gleichmäßig in 256 Zahlen auf. Bei symmetrischer Quantisierung wird der Nullpunkt vom Datentyp bestimmt und liegt im Symmetriezentrum des quantisierten Festkommabereichs; für INT8 ist er beispielsweise 0. Bei asymmetrischer Quantisierung wird der Nullpunkt nach Gleichung (6-5) berechnet und liegt im Allgemeinen nicht im Symmetriezentrum.
Die symmetrische Quantisierung ist eine vereinfachte Form der asymmetrischen. Theoretisch verarbeitet die asymmetrische Quantisierung ungleichmäßige Datenverteilungen besser und wird daher in der Praxis häufig verwendet.
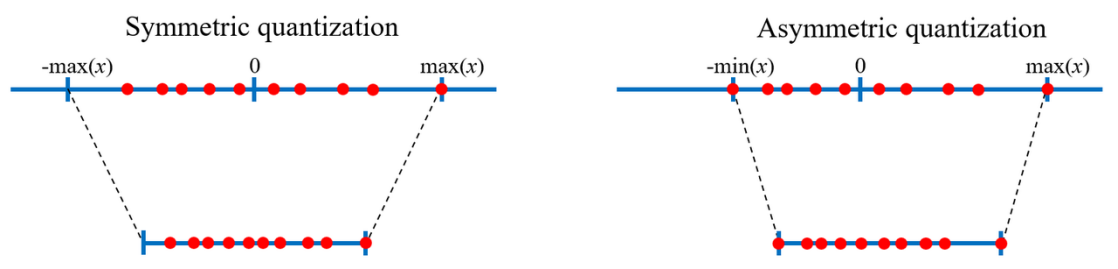
Abbildung 6-1 Lineare symmetrische und asymmetrische Quantisierung
6.1.5 Layerweise und kanalweise Quantisierung
Bei der layerweisen Quantisierung (Per-Layer) werden alle Kanäle eines Layers gemeinsam quantisiert und teilen dieselben Parameter. Die kanalweise Quantisierung (Per-Channel) quantisiert jeden Kanal unabhängig mit eigenen Parametern. Sie bewahrt die Informationen jedes Kanals besser, berücksichtigt Kanalunterschiede und erzielt bessere Quantisierungsergebnisse.
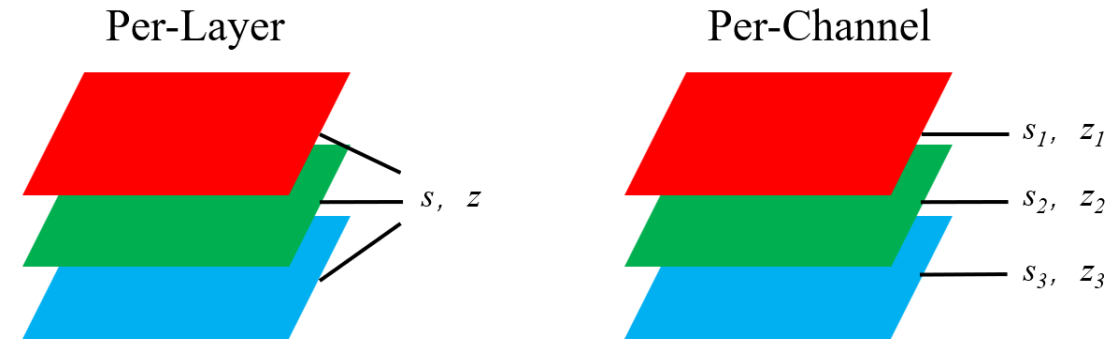
Abbildung 6-2 Layerweise und kanalweise Quantisierung
Hinweis: In RKNN-Toolkit2 gilt die kanalweise Quantisierung nur für Gewichte. Aktivierungen und Zwischenwerte werden weiterhin layerweise quantisiert.
6.1.6 Quantisierungsalgorithmen
Skalierungsfaktor und Nullpunkt sind entscheidend für den Quantisierungsfehler. Die Bestimmung des Quantisierungsbereichs spielt bei ihrer Ermittlung die maßgebliche Rolle. Dieser Abschnitt beschreibt dafür drei Algorithmen: Normal, KL-Divergence und MMSE.
Normal bestimmt die Bereichsgrenzen unmittelbar anhand des Maximums und Minimums der Gleitkommazahlen. Aus dem Prinzip in Abschnitt 6.1.2 folgt, dass Normal keinen Begrenzungsfehler verursacht, jedoch ausreißerempfindlich ist: Große Ausreißer können erhebliche Rundungsfehler bewirken.

q_min = min V

q_max = max V
Dabei ist V der Gleitkommatensor.
KL-Divergence berechnet die Verteilungen der Gleitkomma- und Festkommazahlen, verändert sie durch unterschiedliche Schwellenwerte und bestimmt die Bereichsgrenzen durch Minimierung der KL-Divergenz, um die Ähnlichkeit zu maximieren. Die Verringerung der Verteilungsunterschiede ermöglicht eine bessere Anpassung an ungleichmäßige Daten und mindert den Einfluss einzelner Ausreißer.

arg min_(q_min,q_max) H(Ψ(V), Ψ(V_int))
Dabei ist H(·) die Berechnungsformel der KL-Divergenz, Ψ(·) die Funktion zur Überführung der Daten in eine diskrete Verteilung und V_int der quantisierte Festkommatensor.
MMSE (Minimum Mean Square Error) bestimmt die Bereichsgrenzen durch Minimierung des mittleren quadratischen Fehlers zwischen den ursprünglichen Gleitkommazahlen und deren quantisierten und wieder dequantisierten Werten. Dadurch werden Genauigkeitsverluste durch große Ausreißer teilweise verringert. Die Näherungslösung wird iterativ durch Durchprobieren gesucht, was langsamer ist und mehr Speicher benötigt. Die Quantisierungsgenauigkeit ist jedoch gewöhnlich höher als bei Normal.
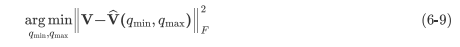
arg min_(q_min,q_max) ||V - V_hat(q_min, q_max)||_F^2
Dabei bezeichnet V̂(q_min, q_max) die quantisierte und dequantisierte Form und ‖·‖_F die Frobeniusnorm.
6.2 Quantisierungskonfiguration
6.2.1 Quantisierungsdatentypen
RKNN-Toolkit2 unterstützt INT8 als Quantisierungsdatentyp.
6.2.2 Empfehlungen zu Quantisierungsalgorithmen
Normal ist schnell und für allgemeine Szenarien geeignet.
KL-Divergence ist etwas langsamer als Normal. Er verbessert die Quantisierungsgenauigkeit bei ungleichmäßigen Verteilungen und kann Verluste durch einzelne Ausreißer mindern.
MMSE ist langsamer und benötigt mehr Speicher. Gegenüber KL-Divergence mindert er ausreißerbedingte Verluste besser. Bei quantisierungsfreundlichen Modellen kann MMSE zur Verbesserung der Genauigkeit ausprobiert werden. In den meisten Szenarien erzielt MMSE eine höhere Genauigkeit als Normal und KL-Divergence.
Standardmäßig wird Normal verwendet. Bei Quantisierungsgenauigkeitsproblemen können KL-Divergence und MMSE ausprobiert werden.
6.2.3 Empfehlungen zum Kalibrierdatensatz
Der Kalibrierdatensatz dient zur Berechnung des Aktivierungsbereichs. Er sollte die unterschiedlichen Datenverteilungen der tatsächlichen Anwendung abdecken. Bei einem Klassifikationsmodell sollten beispielsweise Bilder verschiedener Kategorien des Anwendungsszenarios enthalten sein. Empfohlen werden meist 20-200 Bilder; die Anzahl kann abhängig von der Algorithmuslaufzeit angepasst werden. Mehr Bilder verlängern die Quantisierung, verbessern die Genauigkeit jedoch nicht zwingend.
6.2.4 Konfiguration der Quantisierung
Die Quantisierung wird in RKNN-Toolkit2 über rknn.config() und rknn.build() konfiguriert. Das Verfahren wird mit rknn.config() eingestellt; Aktivierung und Kalibrierdatensatzpfad werden über rknn.build() festgelegt.
rknn.config() enthält folgende Quantisierungseinstellungen:
quantized_dtype: Quantisierungsdatentyp. Derzeit wird nur lineare asymmetrische INT8-Quantisierung unterstützt; Standardwert: ‘asymmetric_quantized-8’.
quantized_algorithm: Auswahl von Normal, KL-Divergence oder MMSE. Werte: ‘normal’, ‘kl_divergence’, ‘mmse’; Standardwert: ‘normal’.
quantized_method: Layerweise oder kanalweise Quantisierung. Werte: ‘layer’ und ‘channel’; Standardwert: ‘channel’.
rknn.build() enthält folgende Quantisierungseinstellungen:
do_quantization: Aktiviert die Quantisierung; Standardwert: ‘False’.
dataset: Pfad zum Kalibrierdatensatz; Standardwert: ‘None’.
Unterstützt wird eine .txt-Datei mit Pfaden zu Kalibrierungsbildern in jpg/png oder npy-Dateien. Jede Zeile enthält einen Pfad, beispielsweise:
a.jpg
b.jpg
Bei mehreren Eingaben werden die zugehörigen Dateien durch Leerzeichen getrennt:
a0.jpg a1.jpg
b0.jpg b1.jpg
6.3 Gemischte Quantisierung
Die gemischte Quantisierung verwendet unterschiedliche Datentypen für verschiedene Layer. Für schlecht quantisierbare Layer werden präzisere Datentypen eingesetzt, um Genauigkeitsverluste zu mindern. Dies verursacht jedoch zusätzlichen Aufwand und erfordert die Festlegung der Datentypen einzelner Layer.
6.3.1 Verwendung der gemischten Quantisierung
Für ein besseres Verhältnis zwischen Leistung und Genauigkeit bietet RKNN-Toolkit2 gemischte Quantisierung. Anhand der Genauigkeitsanalyse kann man manuell festlegen, ob jeder Layer quantisiert werden soll.
Folgende Anwendungen werden unterstützt:
Ausgewählte quantisierte Layer in nicht quantisierte FLOAT16-Berechnungen umwandeln. (Nicht quantisierte Berechnungen auf der NPU sind langsamer und verringern daher die Inferenzgeschwindigkeit.)
Auch die Quantisierungsparameter einzelner Layer können geändert werden. (Dies wird nicht empfohlen.)
6.3.2 Ablauf der gemischten Quantisierung
Die Verwendung umfasst vier Schritte.
1. Das ursprüngliche Modell laden und Quantisierungskonfiguration, temporäre Modelldatei sowie Datendatei erzeugen. Die Aufrufreihenfolge lautet:
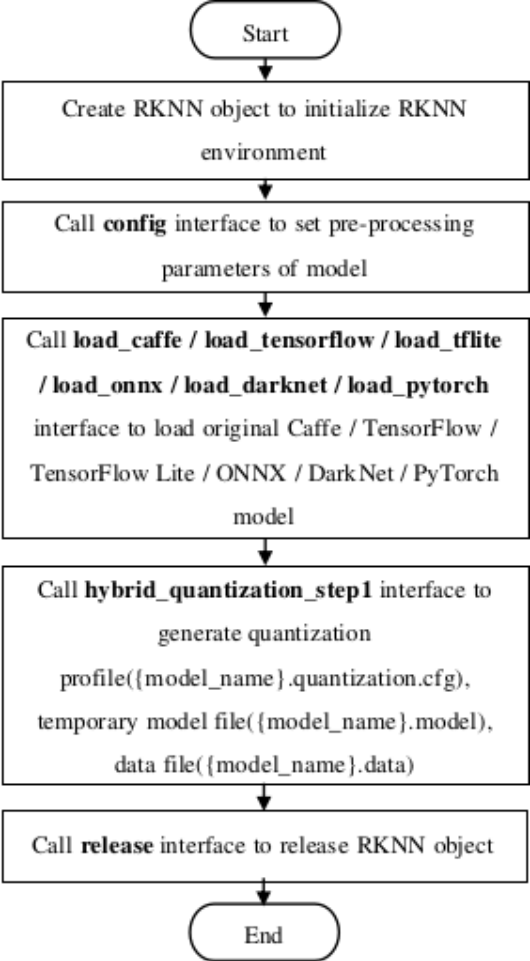
Abbildung 6-3 Schritt 1 der gemischten Quantisierung
2. Die im ersten Schritt erzeugte Konfigurationsdatei bearbeiten.
Nach dem Aufruf von hybrid_quantization_step1 im ersten Schritt entsteht im aktuellen Verzeichnis die Datei {model_name}.quantization.cfg. Ihr Format lautet:
custom_quantize_layers:
  Conv__350:0: float16
  Conv__358:0: float16
  ....
quantize_parameters:
  ....
  FeatureExtractor/MobilenetV2/Conv/Relu6:0:
    qtype: asymmetric_quantized
    qmethod: layer
    dtype: int8
    min:
    - 0.0
    max:
    - 6.0
    scale:
    - 0.023529411764705882
    zero_point:
    - -128
  ....
Im Abschnitt “custom_quantize_layers” können benutzerdefinierte Quantisierungslayer ergänzt werden: Auf den Tensornamen folgt der Quantisierungstyp. Dadurch wird der Berechnungstyp des zugehörigen Layers geändert. Derzeit ist “float16” verfügbar.
Der Abschnitt “quantize_parameters” enthält die Parameter jedes Tensors im Format “tensor_name: quantization_properties_and_parameters”. “min” und “max” sind die Grenzen des Quantisierungsbereichs. Die Ausgabetensornamen lassen sich den Analyseergebnissen entnehmen oder durch Öffnen der temporären Datei {model_name}.model in Netron ermitteln.
3. Das RKNN-Modell erzeugen. Die Aufrufreihenfolge lautet:
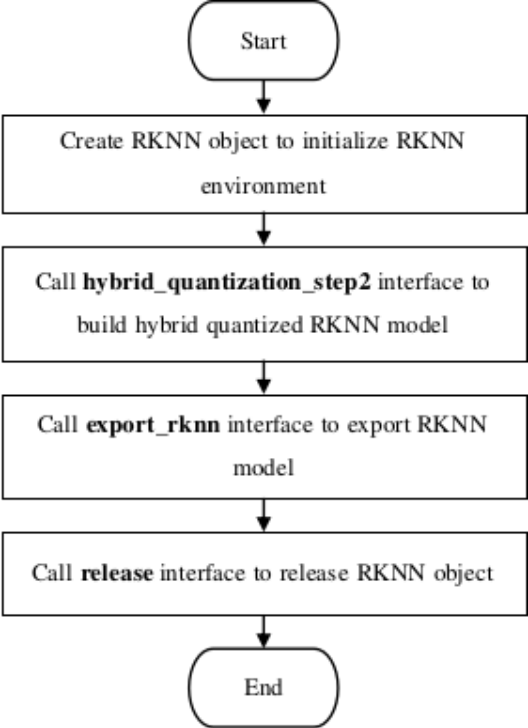
Abbildung 6-4 Schritt 3 der gemischten Quantisierung
4. Mit dem im dritten Schritt erzeugten RKNN-Modell die Inferenz ausführen.
Hinweis: Das RKNN-Toolkit2-Projekt enthält im Verzeichnis “examples/functions/hybrid_quant” ein Beispiel zur gemischten Quantisierung, das als Vorlage dienen kann.
6.3.3 Automatische gemischte Quantisierung
Zur Vereinfachung der gemischten Quantisierung und Behebung von Modellüberläufen bietet RKNN-Toolkit2 einen automatischen Modus. Mit auto_hybrid wird das gemischt quantisierte Modell während der Quantisierung anhand von Schwellenwerten für euklidischen und Kosinusabstand automatisch angepasst. Bei nicht quantisierten Modellen wird jeder Layer auf fp16-Überlauf geprüft; betroffene Layer werden auf int16 umgestellt.
Derzeit werden folgende Szenarien unterstützt:
1. Während der Quantisierung wird das Modell anhand von Schwellenwerten für euklidischen und Kosinusabstand automatisch angepasst. Derzeit wird nur die automatische Umstellung von int8-Quantisierung auf fp16 unterstützt.
ret = rknn.build(do_quantization=True, dataset='./dataset.txt', auto_hybrid=True)
Die Schwellenwerte werden über auto_hybrid_cos_thresh und auto_hybrid_euc_thresh in config eingestellt. Standardmäßig beträgt der Kosinusschwellenwert 0.98 und der euklidische Schwellenwert None, ist also deaktiviert. Damit werden zunächst nur Operatoren mit einer Kosinusgenauigkeit unterhalb des Schwellenwerts in fp16 umgewandelt. Bei aktiviertem euklidischem Schwellenwert werden Operatoren umgestellt, deren Kosinusabstand unter seinem Schwellenwert oder deren euklidischer Abstand über seinem Schwellenwert liegt.
2. Bei nicht quantisierten Modellen wird jeder Layer auf fp16-Überlauf geprüft und bei Überlauf auf int16 umgestellt. Dafür muss ein Datensatz zur Ermittlung des Wertebereichs jedes Layers bereitgestellt werden.
ret = rknn.build(do_quantization=False, dataset='./dataset.txt', auto_hybrid=True)
Anhand der Eingaben werden Maximum und Minimum für jeden Layer berechnet. Überschreiten sie die obere oder untere fp16-Grenze, wird der betreffende Operator auf int16 umgestellt.
6.4 Quantisierungsbewusstes Training (QAT)
6.4.1 Einführung in QAT
Quantization-Aware Training (QAT) soll Genauigkeitsverluste bei Quantisierung mit geringer Bitbreite behandeln. Diese entstehen bei der Überführung des Gleitkommawertebereichs in Festkommazahlen. QAT bezieht den Quantisierungsfehler in die Trainingsverlustfunktion ein und ermöglicht so das Training eines Modells mit Quantisierungsparametern.
Vergleich mit der von RKNN-Toolkit2 angebotenen Quantisierung nach dem Training (PTQ):
| Quantisierungs- verfahren |
Erneutes Training im ursprünglichen Framework |
Datensatz | Anpassung der Gewichtsparameter |
Verlustfunktion | Leistung |
|---|---|---|---|---|---|
| Quantisierung nach dem Training (PTQ) |
Nein | Kleine Menge unbeschrifteter Daten |
Nein | Nicht relevant | Optimal |
| Quantisierungsbewusstes Training (QAT) |
Ja | Vollständiger Trainingsdatensatz |
Ja | Der Quantisierungsverlust wird in die Trainings- verlustfunktion einbezogen. |
Bei Operatoren ohne QAT-Unterstützung ist die Leistung etwas geringer als bei PTQ. |
6.4.2 QAT-Prinzip
Während QAT werden alle Gewichte als Gleitkommawerte gespeichert und alle Berechnungen damit ausgeführt. Dies gewährleistet funktionierende Rückpropagation und wirksames Training. Anders als beim normalen Gleitkommatraining werden an quantisierbaren Stellen FakeQuantize-Module eingefügt, die den Genauigkeitsverlust beim Übergang zu Festkommazahlen simulieren. So kann die Verlustfunktion die Quantisierung berücksichtigen und optimieren, damit die spätere Festkommamodell-Inferenz genaue Ergebnisse liefert.
QAT wird breit eingesetzt und von gängigen Inferenzframeworks unterstützt. Ausführliche Anleitungen sind über folgende Links verfügbar.
Pytorch - https://pytorch.org/blog/quantization-in-practice/#quantization-aware-training-qat
Paddle - https://paddleslim.readthedocs.io/zh-cn/develop/api_cn/dygraph/quanter/qat.html
Tensorflow - https://www.tensorflow.org/model_optimization/guide/quantization/training
6.4.3 Hinweise zur Verwendung von QAT
QAT erfordert zusätzlichen Trainingscode und kann mit Funktionen mancher Open-Source-Repositories kollidieren. Es sollte daher erwogen werden, wenn beide folgenden Bedingungen erfüllt sind:
Die Genauigkeitsprüfung nach Kapitel 7 bestätigt, dass RKNN-PTQ die Genauigkeitsanforderungen nicht erfüllt.
Die Untersuchung der gemischten Quantisierung nach Kapitel 6.3 bestätigt, dass sie die Genauigkeits- und Leistungsanforderungen nicht erfüllt.
6.4.4 QAT-Implementierungsbeispiel und Konfiguration
Nachfolgend finden Sie die QAT-Dokumentation verschiedener Frameworks. Für die konkrete Verwendung ist die offizielle Dokumentation maßgeblich.
PyTorch: https://pytorch.org/docs/stable/quantization.html (PyTorch besitzt mehrere Quantisierungsschnittstellen. RKNN unterstützt derzeit quantisierte Modelle aus der FX-Schnittstelle, insbesondere prepare_qat_fx und den zugehörigen Schnittstellen.)
Paddle: https://www.paddlepaddle.org.cn/tutorials/projectdetail/3949129#anchor-14
TensorFlow: https://www.tensorflow.org/model_optimization/guide/quantization/training
Am Beispiel von PyTorch werden der QAT-Ablauf und wichtige Hinweise erläutert.
# for 1.10 <= torch <= 1.13
import torch
class M(torch.nn.Module):
 def __init__(self):
 super().__init__()
 self.conv = torch.nn.Conv(3, 8, 3, 1)

 def forward(self, x):
 x = self.conv(x)
 return x

# initialize a floating point model
float_model = M().train()

from torch.quantization import quantize_fx, QConfig, FakeQuantize, MovingAverageMinMaxObserver, MovingAveragePerChannelMinMaxObserver

qconfig = QConfig(activation=FakeQuantize.with_args(observer=
        MovingAverageMinMaxObserver,
        quant_min=0,
        quant_max=255,
        reduce_range=False), # reudece_range -> the default is True

 weight=FakeQuantize.with_args(observer=
      MovingAveragePerChannelMinMaxObserver,
      quant_min=-128,
      quant_max=127,
      dtype=torch.qint8,
      qscheme=torch.per_channel_affine,
      #qscheme->the default is torch.per_channel_symmetric
      reduce_range=False))
qconfig_dict = {"": qconfig}
model_qat = quantize_fx.prepare_qat_fx(float_model, qconfig_dict)

# define the training loop for quantization aware training
def train_loop(model, train_data):
 model.train()
 for image, target in data_loader:
  ...
# Run training
train_loop(model_qat, train_loop)

model_qat = quantize_fx.convert_fx(model_qat)
Im obigen Code folgen alle Operationen den offiziellen Beispielen, abgesehen von der Anpassung von qconfig an RKNN-Hardware. Dabei gibt es zwei wesentliche Änderungen:
Bei der Aktivierungsquantisierung wird reduce_range auf False gesetzt. Mit False reicht der effektive Bereich von -128 bis 127, mit True nur von -64 bis 63, was schlechtere Quantisierungsergebnisse bewirkt. RKNN-Hardware unterstützt reduce_range = False.
Für die Gewichtsquantisierung wird qscheme auf torch.per_channel_affine gesetzt. Das voreingestellte torch.per_channel_symmetric fixiert zero_point auf 0; RKNN-Hardware unterstützt jedoch auch andere Nullpunkte. Deshalb wird torch.per_channel_affine gewählt.
6.4.5 Von QAT unterstützte Operatoren
Bei PyTorch werden zunächst Conv- und Linear-Operatoren mit Gewichten nach QAT-Regeln quantisiert. Danach werden weitere Operatoren geprüft und gegebenenfalls regulär quantisiert. Erfüllt ein Operator weder QAT- noch reguläre Quantisierungsregeln, verbleibt er bei FP32-Berechnungen.
Der Unterstützungsumfang unterscheidet sich je nach Framework. Einzelheiten zu Framework und Version finden sich unter:
Pytorch: https://github.com/pytorch/pytorch/blob/main/torch/ao/quantization/quantization_mappings.py
Paddle: https://github.com/PaddlePaddle/Paddle/blob/86df789a567f1285101c57b6e3ada4b952c58f48/python/paddle/quantization/config.py
Tensorflow: https://www.tensorflow.org/model_optimization/api_docs/python/tfmot/quantization/keras/QuantizeConfig
6.4.6 Behandlung von Gleitkommaoperatoren im QAT-Modell
Kann ein Operator im QAT-Modell nicht quantisiert werden, wird mit Gleitkommazahlen gerechnet. Bei der RKNN-Konvertierung sind zwei Fälle zu unterscheiden.
1. Vorheriger und nachfolgender Operator sind quantisierbar:
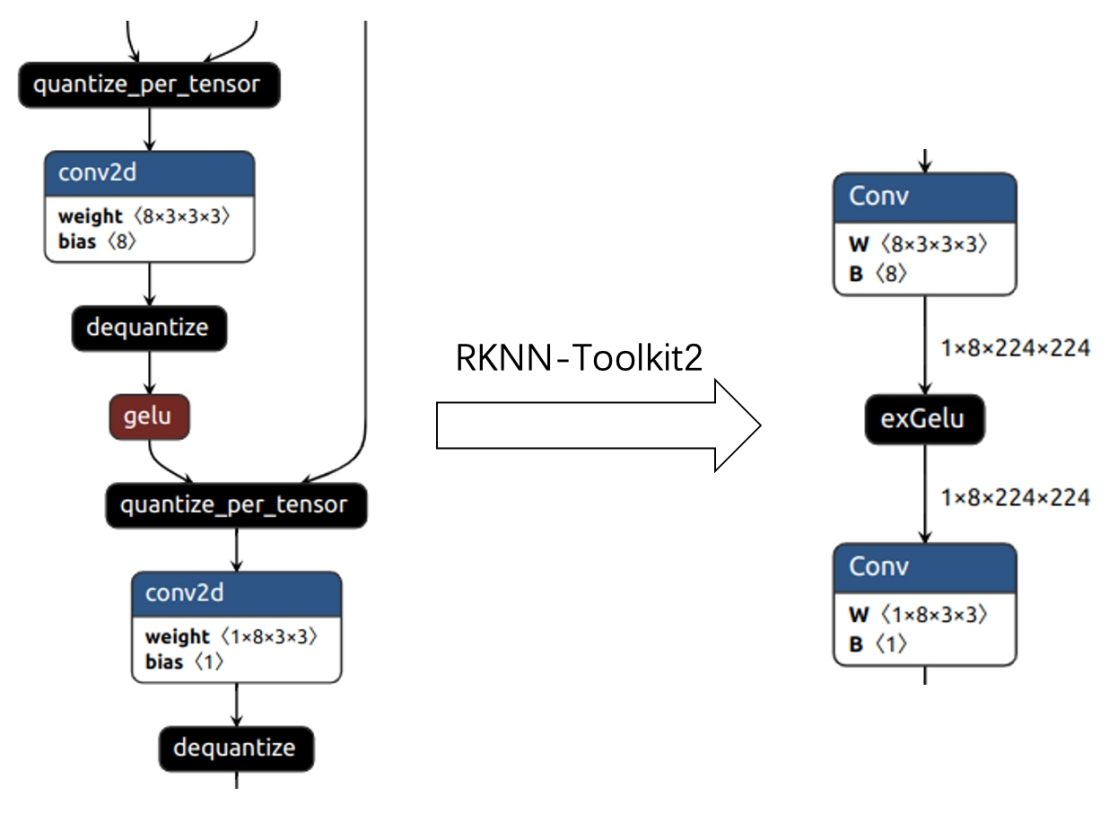
Abbildung 6-5 Quantisierbare Operatoren vor und nach dem QAT OP
Links arbeitet gelu im ursprünglichen Modell mit Gleitkommazahlen, während der vorherige und nachfolgende conv2d quantisiert sind. Beim Laden mit RKNN-Toolkit2 wird der dazwischenliegende Gleitkommaoperator ebenfalls quantisiert, um die Inferenzleistung ohne Genauigkeitsverlust zu verbessern. Rechts ist die resultierende RKNN-Struktur dargestellt.
1. Davor oder danach befinden sich nicht quantisierbare Operatoren:
Abbildung 6-6 Nicht quantisierbare Operatoren vor und nach dem QAT OP
Links arbeiten gelu und softmax im ursprünglichen Modell mit Gleitkommazahlen, während die umgebenden conv2d quantisiert sind. Da gelu und softmax Quantisierungsparameter fehlen, bleiben sie beim Laden mit RKNN-Toolkit2 im Gleitkommaformat. Rechts wird im RKNN-Modell vor exGelu ein Dequantisierungsoperator exDataConvert und nach Softmax ein Quantisierungsoperator exDataConvert eingefügt. Diese zusätzlichen Umwandlungen verursachen weitere Latenz.
6.4.7 Zusammenfassung der QAT-Erfahrungen
1. QAT-Konfiguration
Für bessere Ergebnisse müssen QAT-Einstellungen oft an die Hardware angepasst werden. Für RKNPU sollte qconfig anhand der Codehinweise in Abschnitt 6.4.4 konfiguriert werden.
2. Anpassung der im Modell gespeicherten Quantisierungsparameter
Beispielsweise können die im Modell gespeicherten Parameter des sigmoid-Operators von den tatsächlich bei der Inferenz verwendeten abweichen. Im offiziellen Code (https://github.com/pytorch/pytorch/blob/main/aten/src/ATen/native/quantized/cpu/qsigmoid.cpp) werden sie zur Inferenzzeit angepasst: min wird auf 0 gesetzt und max auf [Die Quelle nennt keinen max-Wert.]
3. Um dies zu berücksichtigen, passt RKNN-Toolkit2 die Parameter solcher Operatoren bei der Modellkonvertierung an und nähert dadurch die Ergebnisse der ursprünglichen PyTorch-Inferenz an.
7 Fehlersuche bei der Genauigkeit
Die Fehlersuche bei der Modellgenauigkeit umfasst gewöhnlich Simulator und Board-Laufzeit. Korrekte Simulatorergebnisse sind Voraussetzung für korrekte Inferenz auf dem Board. Deshalb muss zunächst die Simulatorausgabe sichergestellt werden, bevor die Board-Laufzeit untersucht wird.
Dieses Kapitel enthält Empfehlungen und Lösungen für beide Fälle. Die Abbildung zeigt die einzelnen Prüfschritte:
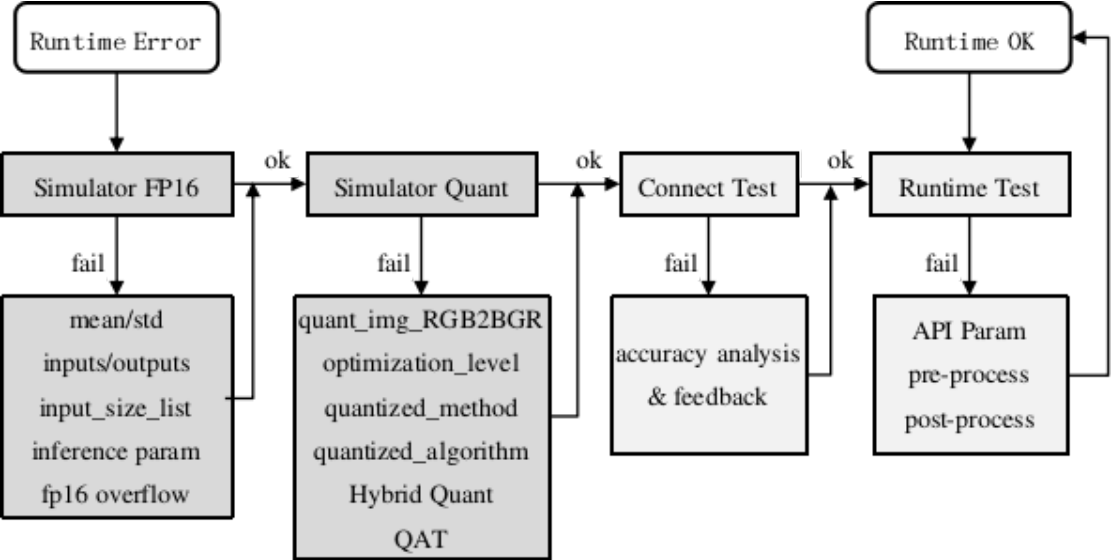
Abbildung 7-1 Schritte der Genauigkeitsanalyse
Die Simulatorprüfung unterteilt sich in FP16-Genauigkeit und Quantisierungsgenauigkeit (dunkle Felder der Abbildung).
Die Laufzeitprüfung unterteilt sich in die Prüfung mit angeschlossenem Board und die Runtime-Prüfung (helle Felder).
Der Kosinusabstand kann als grundlegendes Genauigkeitskriterium dienen; die endgültigen Auswirkungen der Quantisierung müssen jedoch am Datensatz validiert werden.
7.1 Fehlersuche bei der Simulatorgenauigkeit
Korrekte Simulatorinferenz ist Voraussetzung für korrekte Board-Inferenz und muss daher zuerst sichergestellt werden.
Der RKNN-Toolkit2-Simulator führt FP16- oder quantisierte Inferenz aus. Korrekte FP16-Ergebnisse sind Voraussetzung für korrekte quantisierte Inferenz. Bei Quantisierungsproblemen wird deshalb zuerst FP16 und danach die Quantisierungsgenauigkeit geprüft.
7.1.1 FP16-Genauigkeit im Simulator
RKNPU unterstützt derzeit keine FP32-Berechnungen, daher verwendet der Simulator ohne Quantisierung standardmäßig FP16. Zur Umwandlung in ein FP16-RKNN-Modell wird rknn.build() mit do_quantization = False aufgerufen. Anschließend liefern rknn.init_runtime(target=None) und rknn.inference() die FP16-Simulatorergebnisse.
Bei falscher FP16-Ausgabe sind folgende Prüfungen möglich:
Konfigurationsfehler
Die meisten Modelleinstellungen liegen in rknn.config(); auch einzelne Einstellungen anderer APIs können jedoch die FP16-Genauigkeit beeinflussen. Die wichtigsten Parameter sind:
mean_values / std_values: Normalisierungsparameter. Im ursprünglichen Modell wird die Normalisierung gewöhnlich in der Eingabevorverarbeitung ausgeführt. Bei RKNN kann sie in der Inferenz enthalten sein; bei aktivierter Quantisierung wird zunächst der Kalibrierdatensatz normalisiert. Verwendet das ursprüngliche Modell eine Normalisierung, müssen diese Parameter mit dessen Werten übereinstimmen.
input_size_list: Falsche Eingabeknotenformen in rknn.load_tensorflow(), rknn.load_pytorch() oder rknn.load_onnx() führen zu falschen Inferenzergebnissen.
inputs / outputs: Falsche Eingabe- oder Ausgabeknotennamen in rknn.load_tensorflow() und rknn.load_onnx() führen zu falschen Inferenzergebnissen.
Parameter von inference: Die wichtigsten Eingabeparameter von rknn.inference() sind inputs und data_format.
In Python werden Bilder gewöhnlich mit cv2.imread() gelesen; das Ergebnis ist BGR. Erwartet das ursprüngliche Modell BGR, wie die meisten caffe-Modelle, muss die RGB-Reihenfolge nicht geändert werden. Für RGB-Eingaben wird cv2.cvtColor(img, cv2.COLOR_BGR2RGB) benötigt. cv2.imread() liefert 3 Dimensionen, die meisten Modelle erwarten jedoch 4. Daher muss vor rknn.inference() mit np.expand_dims(img, 0) eine Dimension ergänzt werden. Das Layout von cv2.imread() und der Standardwert von data_format sind NHWC; data_format muss deshalb nicht gesetzt werden.
Werden die Daten nicht mit cv2.imread() gelesen, muss ihr Layout bekannt sein und data_format entsprechend gesetzt werden. Die Datenform muss mit dem ursprünglichen Modell übereinstimmen; bei Bildern gilt dies auch für die RGB-Reihenfolge.
Die Parameterprüfung ist entscheidend: Falsche Einstellungen sind eine häufige Ursache fehlerhafter FP16-Ergebnisse. Vorgehen:
1. Die ursprüngliche Modellinferenz im ursprünglichen Framework ausführen und Ergebnisse speichern.
2. Das Modell mit RKNN-Toolkit2 und denselben Eingabedaten in FP16 konvertieren und ausführen: do_quantization = False in rknn.build() und target = None in rknn.init_runtime(). Die Simulatorergebnisse speichern.
3. Beide Ergebnisse vergleichen. Stimmen sie weitgehend überein, beispielsweise anhand des Kosinusabstands, sind die Einstellungen korrekt.
4. Bei Abweichungen die genannten Parameter überprüfen.
Sind die Einstellungen korrekt und die Ergebnisse trotzdem unterschiedlich, überschreiten Modell-Tensoren möglicherweise den FP16-Wertebereich.
Überschreitung des FP16-Wertebereichs
Beim Übergang von FP32 zu FP16 können Zwischentensoren überlaufen. Modelle rechnen gewöhnlich mit FP32; Werte außerhalb des FP16-Bereichs (-65504~65504) verursachen Überläufe und fehlerhafte Ergebnisse.
Zur Überlaufprüfung dient rknn.accuracy_analysis(…, target=None), siehe Modellgenauigkeitsanalyse. Auffällige Werte wie ‘inf’ in entire oder single unter simulator_error können FP16-Überläufe anzeigen. Die Struktur kann beispielsweise durch zusätzliche BN-Layer so angepasst werden, dass alle Tensoren im FP16-Bereich bleiben.
Sind Einstellungen korrekt und FP16-Überläufe ausgeschlossen, können Unterschiede auf die Simulatorimplementierung zurückgehen. Stellen Sie dem Rockchip-NPU-Team eine reproduzierbare Modelldatei zur Analyse und Behebung bereit.
7.1.2 Quantisierungsgenauigkeit im Simulator
Nach Ausschluss von FP16-Problemen kann das Modell mit rknn.build() und do_quantization = True quantisiert werden. Anschließend prüft rknn.accuracy_analysis(…, target=None) die Simulatorquantisierung; siehe Modellgenauigkeitsanalyse.
Sinkt die Genauigkeit in entire unter simulator_error deutlich, ohne dass single einen einzelnen stark abweichenden Layer zeigt, sind hauptsächlich folgende Bereiche zu prüfen:
Konfigurationsfehler
Wie bei FP16 führen falsche Einstellungen zu Quantisierungsproblemen. Auch bei korrekter FP16-Konfiguration müssen deshalb die folgenden Quantisierungsparameter geprüft werden.
quant_img_RGB2BGR: Gibt an, ob beim Laden der Quantisierungsbilder RGB2BGR ausgeführt wird, gewöhnlich bei caffe-Modellen. Einzelheiten stehen bei quant_img_RGB2BGR. Die Einstellung muss der Kanalreihenfolge der Trainingsbilder entsprechen; andernfalls kann die Genauigkeit stark sinken.
optimization_level: Optimierungsstufe; Standardwert 3 priorisiert Geschwindigkeit. Einige Regeln werden zur Leistungssteigerung aktiviert, obwohl sie die Genauigkeit geringfügig beeinflussen. Eine niedrigere Stufe, etwa 0, deaktiviert diese Regeln.
dataset: Kalibrierdatensatz von rknn.build() zur Berechnung von scale/zero_point jedes Tensors. Weicht er stark vom tatsächlichen Einsatzszenario ab, kann die Genauigkeit sinken. Auch zu viele oder zu wenige Bilder beeinflussen sie; üblich sind 20 bis 200 Bilder.
Die Quantisierungsparameter werden gewöhnlich wie folgt geprüft:
1. Quantisierte Inferenz ausführen und mit der ursprünglichen Modellinferenz im ursprünglichen Framework vergleichen. Bei geringen Abweichungen können quant_img_RGB2BGR und dataset als weitgehend korrekt gelten.
2. Bleiben deutliche Abweichungen bestehen:
Erwartet das ursprüngliche Modell BGR, wie häufig bei caffe, setzen Sie quant_img_RGB2BGR auf True. Die RGB-Reihenfolge lässt sich im Eingabeverarbeitungscode der vorherigen FP16-Prüfung nachvollziehen.
Verwenden Sie zunächst nur ein Bild zur Quantisierung, also eine Zeile in dataset.txt, und führen Sie damit die Inferenz aus. Verbessert sich dessen Genauigkeit deutlich, war der bisherige Kalibrierdatensatz möglicherweise ungünstig. Wählen Sie Bilder, die besser zum Einsatzszenario passen. Ohne deutliche Verbesserung liegt die Ursache möglicherweise nicht am dataset.
Wurde ursprünglich nur ein Bild verwendet, also eine Zeile in dataset.txt, kann der Datensatz auf etwa 20 bis 200 Bilder erweitert werden.
Nach diesen Prüfungen sollten keine vollständig falschen Quantisierungsergebnisse mehr auftreten. Andernfalls sind die Einstellungen erneut zu prüfen. Ist die Konfiguration korrekt, die Genauigkeit jedoch unzureichend, können Quantisierungsverfahren und -algorithmen geändert werden.<br>Quantisierungsverfahren und -algorithmen
Manche Modelle sind wenig quantisierungsfreundlich. Probieren Sie andere Verfahren und Algorithmen aus. Die Verfahren layer und channel werden über quantized_method in rknn.config() gewählt (Standard: channel). Die Algorithmen normal, kl_divergence und mmse werden über quantized_algorithm in rknn.config() eingestellt (Standard: normal). Vorgehen:
1. Wurde layer verwendet, wechseln Sie zu channel. Kanalweise Quantisierung ist häufig deutlich genauer als layerweise Quantisierung.
2. Wird bereits channel verwendet und reicht die Genauigkeit nicht aus, wechseln Sie von normal zu kl_divergence oder mmse. Dies kann die Quantisierungsdauer deutlich erhöhen, aber bessere Genauigkeit liefern. Die Laufzeitleistung wird dadurch nicht verschlechtert.
Bleibt entire unter simulator_error unzureichend und zeigt single starke Genauigkeitsverluste einzelner Layer, kann eine ungünstige Gewichtsverteilung die Ursache sein. Beispielsweise können stark ungleichmäßige Conv-Gewichte nach der Quantisierung erhebliche Verluste verursachen. Gemischte Quantisierung kann helfen:
1. Ermitteln Sie mit der Genauigkeitsanalyse stark verlustbehaftete Layer und notieren Sie ihre Ausgabetensornamen. Da Fehler layerweise kumulieren, beeinflussen frühe Layer das Endergebnis stärker. Berücksichtigen Sie sowohl den Verlust in single unter simulator_error als auch die Layerposition.
2. Tragen Sie die ermittelten Tensornamen in die Konfiguration der gemischten Quantisierung ein; siehe den entsprechenden Abschnitt.
3. Schließen Sie die gemischte Quantisierung ab und prüfen Sie die Genauigkeit. Zur Beobachtung der Änderungen kann erneut die Analyseschnittstelle verwendet werden.
Gemischte Quantisierung verbessert gewöhnlich die Genauigkeit. Reicht dies nicht aus, können weitere Layer einbezogen werden, allerdings zulasten der Inferenzleistung. Genauigkeit und Geschwindigkeit müssen daher abgewogen werden. Liegt der betroffene Operator im letzten Layer, kann seine Ausführung alternativ in die Nachverarbeitung verlegt werden, um dessen Genauigkeitsproblem zu vermeiden.
QAT (quantisierungsbewusstes Training):
Reicht die Genauigkeit nach gemischter Quantisierung weiterhin nicht aus oder genügt sie zwar, aber die Leistung nicht, kann das Modell mit QAT neu trainiert werden. Exportieren Sie es einschließlich Quantisierungsparametern, etwa als ONNX, PyTorch oder TensorFlow Lite. Einzelheiten stehen im Abschnitt zum quantisierungsbewussten Training (QAT).
7.2 Fehlersuche bei der Laufzeitgenauigkeit
Trotz korrekter Simulatorergebnisse kann die C-API-Bereitstellung auf dem Board falsche Ergebnisse liefern. Typische Ursachen sind ein Fehler der Board-Runtime, falsche Verwendung der RKNPU2 C API oder fehlerhafte Vor-/Nachverarbeitung.
Prüfen Sie zunächst im Modus mit angeschlossenem Board, ob ein Runtime-Fehler vorliegt. Funktioniert dieser korrekt, untersuchen Sie die C-API-Bereitstellung.
7.2.1 Genauigkeit mit angeschlossenem Board
1. Richten Sie die Board-Debuggingumgebung gemäß NPU-Umgebungseinrichtung ein, verbinden Sie das Board per USB mit dem PC und führen Sie RKNN-Toolkit2-Inferenz mit target in rknn.init_runtime() aus, etwa target=’rk3566’. Prüfen Sie die ungefähre Richtigkeit: Der Simulator bildet die NPU nicht exakt nach, daher müssen die Ergebnisse nicht vollständig übereinstimmen.
2. Deutliche Abweichungen vom Simulator deuten zunächst auf einen Board-Runtime-Fehler hin. Führen Sie die Genauigkeitsanalyse mit rknn.accuracy_analysis() und target aus, etwa target=’rk3566’; siehe Modellgenauigkeitsanalyse. Danach werden die Ergebnisse jedes Layers ausgegeben.
3. Prüfen Sie single_sim unter runtime_error. Ein niedriger cos-Kosinuswert oder hoher euc-Abstand, gelb oder rot markiert, kann die Differenz zwischen entire von runtime_error und simulator_error vergrößern. Dies kann auf Genauigkeitsverluste oder Fehler der Layerimplementierung in der Runtime hinweisen. Analyseergebnisse und reproduzierbares Modell können dem Rockchip-NPU-Team zur Behebung übergeben werden.
7.2.2 Runtime-Genauigkeit
Ist die Genauigkeit mit angeschlossenem Board korrekt, im eigenen Programm jedoch nicht, kann die Ursache im C/C++-Code mit RKNN C API liegen. Prüfen Sie Schnittstellenkonfiguration sowie Vor-/Nachverarbeitung; diese müssen vollständig mit dem Simulator übereinstimmen. Vorgehen:
1. Eingabekonfiguration und -daten prüfen
Prüfen Sie die C-API-Eingabe. Wurden Mittelwert und Varianz bereits bei der RKNN-Toolkit2-Konvertierung konfiguriert, ist keine erneute Normalisierung im C/C++-Code nötig. Bei 3-dimensionalen Eingaben muss die Kanalreihenfolge dem Training entsprechen; für 4-dimensionale Eingaben gilt fmt=NHWC, andernfalls fmt=UNDEFINED. Bei der allgemeinen API ist die Puffergröße gleich Tensorelementzahl mal Bytes pro Element. Für Zero-Copy stehen Speichergröße von rknn_create_mem und Datenformat im Abschnitt zur RKNN-Runtime-Zero-Copy-Verwendung.
Nach der Konfigurationsprüfung sind die Eingabelayerdaten zu prüfen. Setzen Sie vor dem Programmstart RKNN_LOG_LEVEL=5. Layer-Ergebnisse werden als numpy-Dateien in /data/dumps (Android) oder /userdata/dumps (Linux) gespeichert. Prüfen Sie die Datei mit InputOperator. Bei der allgemeinen API enthält sie die normalisierte Eingabe, bei Zero-Copy die Daten vor der Normalisierung.
2. Ausgabekonfiguration und -daten prüfen
Nach der Eingabeprüfung ist die Ausgabe zu prüfen. Bei der allgemeinen API liefert want_float=1 float32-Ergebnisse, want_float=0 einen quantisierten Datentyp oder FP16 bei nicht quantisierten Daten. Für Zero-Copy stehen Speichergröße und Eingabedatenformat von rknn_create_mem() im Abschnitt zur RKNN-Runtime-Zero-Copy-Verwendung.
Öffnen Sie die erzeugte layerweise numpy-Datei mit OutputOperator und prüfen Sie die Ausgabe. Bei bestätigter korrekter Eingabe und falscher Ausgabe kann die Runtime-Verarbeitung bestimmter Eingabe-/Ausgabetypen fehlerhaft sein. Übergeben Sie Analyse und reproduzierbares Modell dem Rockchip-NPU-Team zur Behebung.
8 Leistungsoptimierung
8.1 Ablauf der Modellleistungsanalyse
8.1.1 Laufzeitumgebung prüfen
Vor jeder Leistungsanalyse und Optimierung müssen einheitliche Ausgangsbedingungen der Testumgebung festgelegt werden. Nur dann sind Messdaten aussagekräftig. Beispielsweise kann dieselbe Modellinferenz bei unterschiedlichen Frequenzen stark schwanken und nicht durch die mittlere Frame-Zeit eines einzigen Batches beschrieben werden.
Bei Abfrage und Konfiguration der Testumgebung sind folgende Aspekte zu beachten:
CPU-, DDR- und NPU-Frequenzen abfragen und einstellen
Feste Frequenzen beeinflussen die Ausführungsgeschwindigkeit direkt; höhere Frequenzen liefern gewöhnlich mehr Leistung. Der Zusammenhang ist jedoch nicht linear, und höhere Frequenzen erhöhen den Energieverbrauch.
Befehle zum Festlegen der Frequenzen: https://github.com/airockchip/rknn_model_zoo/blob/main/scaling_frequency.sh
Alternativ lässt sich der Leistungsmodus mit folgendem Befehl einstellen:
echo performance | tee $(find /sys/ -name *governor) /dev/null || true
Version des NPU-Kerneltreibers prüfen
Optimierungen bestimmter Funktionen oder Operatoren können von der Kerneltreiberversion abhängen. Neuere Versionen können aktuelle Low-Level-Optimierungen enthalten. Prüfen Sie deshalb, ob ein ausreichend neuer Treiber verwendet wird. Empfohlen wird 0.8.8 oder neuer; dies ist nicht zwingend.
Die Treiberversion lässt sich mit folgenden Befehlen prüfen:
cat /sys/kernel/debug/rknpu/version # for RK3566/RK3568/RK3588/RK3562/RK3576
cat /proc/rknpu/version # for RV1106/RV1106B/RV1103/RV1103B/RV1126B
Hinweis: RK2118 unterstützt die Abfrage der NPU-Version noch nicht.<br>NPU-Auslastung prüfen
Die NPU-Auslastung ist der Zeitanteil, in dem die NPU Aufgaben ausführt. Sie beschreibt ihre Aktivität. Ein niedriger Wert bedeutet längere Wartezeiten auf neue Aufgaben. Prüfen Sie Datenkopierzeiten, Vor-/Nachverarbeitung und weitere Anwendungsfaktoren. Auch Multithreading kann die NPU-Auslastung erhöhen.
Die NPU-Auslastung ist nicht gleich der tatsächlichen MAC-Ausnutzung. Letztere beschreibt die Effizienz der Aufgabenausführung in den Hardwareeinheiten.
Befehl zur Abfrage der NPU-Auslastung:
cat /sys/kernel/debug/rknpu/load
# or
cat /proc/debug/rknpu/load
Hinweis: RK2118 unterstützt die Abfrage der NPU-Auslastung noch nicht.
8.1.2 Analyse der Laufzeitanteile bei der Bereitstellung
Die Gesamtlaufzeit besteht aus Anwendungszeit, Ein-/Ausgabekopierzeit und Modellinferenzzeit. Ihre Verteilung zeigt Optimierungsprioritäten. Die Abschnitte können mit Zeitstempeln im Programm gemessen werden.
Anwendungszeit:
Dies umfasst die nicht NPU-bezogene Zeit des Inferenzablaufs, typischerweise Vorverarbeitung, Nachverarbeitung und Programmlogik. Dieser Teil liegt vollständig unter Benutzerkontrolle. Bei hohem Anteil können neben Codevereinfachung und -optimierung bestimmte Operationen durch Spezialhardware beschleunigt werden.
Beispielsweise können Matrixmultiplikation und -addition mit der Matmul API auf der NPU beschleunigt werden, Bildskalierungen über RGA.
Ein-/Ausgabekopierzeit:
Die allgemeine API kopiert zwischen Ein-/Ausgabespeicher und NPU-Speicher; diese Zeit lässt sich beim API-Aufruf ausgeben. Sie hängt von DDR und CPU ab. Bei kleinen Datenmengen ist sie gering, bei großen nicht vernachlässigbar. Daher werden Zero-Copy-APIs empfohlen.
Bei Zero-Copy greift die NPU direkt auf den Ein-/Ausgabespeicher zu. Einzelheiten stehen im Abschnitt zur RKNN-Runtime-Zero-Copy-Schnittstelle.
Inferenzzeit:
Die NPU-Inferenzzeit hängt unter anderem von Modellgröße und Version der Compileroptimierungen ab. Die von RKNN LOG ausgegebene Zeit unterscheidet sich je nach RKNN_LOG_LEVEL, da Protokollausgaben selbst Zeit benötigen.
Zur Messung der Einzelbildinferenz wird gewöhnlich LOG-Stufe 1 verwendet und über mehrere Durchläufe gemittelt.
8.2 Leistungsanalyse
8.2.1 Profildaten ermitteln
Für die Laufzeit jedes Layers kann vor Programmstart folgender Befehl zur detaillierten Ausgabe eingegeben werden:
export RKNN_LOG_LEVEL=4
./run_rknn_test ./test.rknn ./input.jpg
Unter Android lassen sich anschließend detaillierte Protokolle über logcat abrufen.
Mit RKNN-Toolkit2 lässt sich die Zeit jedes Layers wie folgt ermitteln:
rknn.init_runtime(target=platform, perf_debug=True)
rknn.eval_perf()
Es ergibt sich folgender Leistungsanalysebericht:
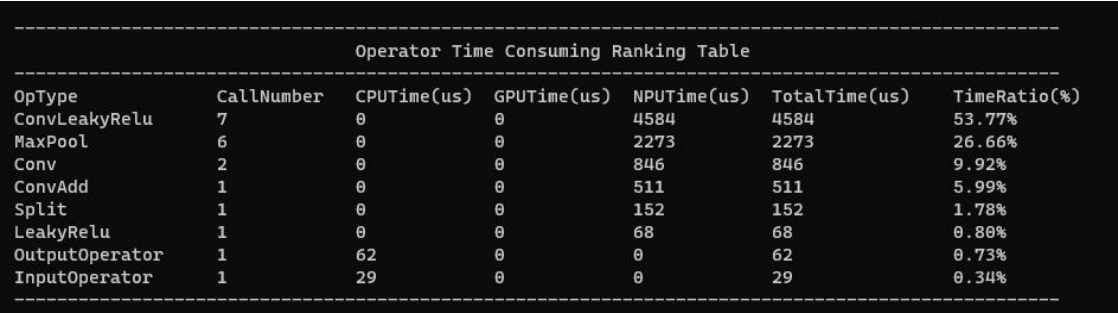
| OpType | CallNumber | CPUTime(us) | GPUTime(us) | NPUTime(us) | TotalTime(us) | TimeRatio(%) |
|---|---|---|---|---|---|---|
| ConvLeakyRelu | 7 | 0 | 0 | 4584 | 4584 | 53.77% |
| MaxPool | 6 | 0 | 0 | 2273 | 2273 | 26.66% |
| Conv | 2 | 0 | 0 | 846 | 846 | 9.92% |
| ConvAdd | 1 | 0 | 0 | 511 | 511 | 5.99% |
| Split | 1 | 0 | 0 | 152 | 152 | 1.78% |
| LeakyRelu | 1 | 0 | 0 | 68 | 68 | 0.80% |
| OutputOperator | 1 | 62 | 0 | 0 | 62 | 0.73% |
| InputOperator | 1 | 29 | 0 | 0 | 29 | 0.34% |
Abbildung 8-1 Leistungsanalysebericht
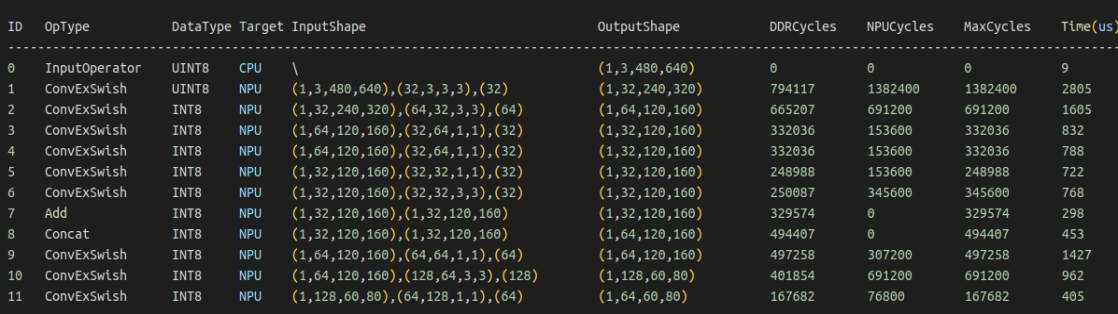
| ID | OpType | DataType | Target | InputShape | OutputShape | DDRCycles | NPUCycles | MaxCycles | Time(us) |
|---|---|---|---|---|---|---|---|---|---|
| 0 | InputOperator | UINT8 | CPU | \ | (1,3,480,640) | 0 | 0 | 0 | 9 |
| 1 | ConvExSwish | INT8 | NPU | (1,3,480,640),(32,3,3,3),(32) | (1,32,240,320) | 794117 | 1382400 | 1382400 | 2805 |
| 2 | ConvExSwish | INT8 | NPU | (1,32,240,320),(64,32,3,3),(64) | (1,64,120,160) | 665207 | 691200 | 691200 | 1605 |
| 3 | ConvExSwish | INT8 | NPU | (1,64,120,160),(32,64,1,1),(32) | (1,32,120,160) | 332036 | 153600 | 332036 | 832 |
| 4 | ConvExSwish | INT8 | NPU | (1,64,120,160),(32,64,1,1),(32) | (1,32,120,160) | 332036 | 153600 | 332036 | 788 |
| 5 | ConvExSwish | INT8 | NPU | (1,32,120,160),(32,32,1,1),(32) | (1,32,120,160) | 248988 | 153600 | 248988 | 722 |
| 6 | ConvExSwish | INT8 | NPU | (1,32,120,160),(32,32,3,3),(32) | (1,32,120,160) | 250087 | 345600 | 345600 | 768 |
| 7 | Add | INT8 | NPU | (1,32,120,160),(1,32,120,160) | (1,32,120,160) | 329574 | 0 | 329574 | 298 |
| 8 | Concat | INT8 | NPU | (1,32,120,160),(1,32,120,160) | (1,64,120,160) | 494407 | 0 | 494407 | 453 |
| 9 | ConvExSwish | INT8 | NPU | (1,64,120,160),(64,64,1,1),(64) | (1,64,120,160) | 497258 | 307200 | 497258 | 1427 |
| 10 | ConvExSwish | INT8 | NPU | (1,64,120,160),(128,64,3,3),(128) | (1,128,60,80) | 401859 | 691200 | 691200 | 962 |
| 11 | ConvExSwish | INT8 | NPU | (1,128,60,80),(64,128,1,1),(64) | (1,64,60,80) | 167682 | 76800 | 167682 | 405 |
Abbildung 8-2 Leistungsanalysebericht
Gesamt- und Layerprofile erleichtern das Auffinden relevanter Informationen und die Wahl einer gezielten Optimierungsstrategie. Danach werden Layerzeiten zur Suche nach zeitintensiven Operatoren, die Auswirkungen von Nicht-NPU-Operatoren und Engpässe der NPU-Operatoren untersucht. Diese Prüfungen werden nachfolgend erläutert.
8.2.2 Layerweise Zeitanalyse
In Times lassen sich zeitintensive Operatoren finden und zuerst optimieren. Op Type zeigt, ob sie demselben OpType angehören und gemeinsam optimiert werden können.
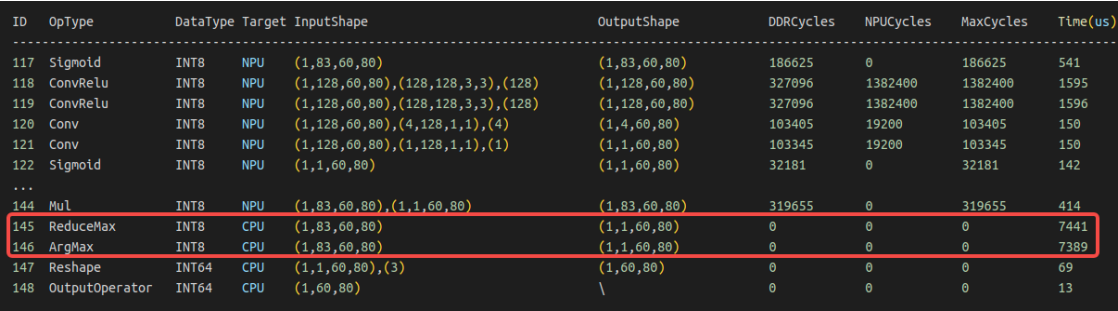
| ID | OpType | DataType | Target | InputShape | OutputShape | DDRCycles | NPUCycles | MaxCycles | Time(us) |
|---|---|---|---|---|---|---|---|---|---|
| 117 | Sigmoid | INT8 | NPU | (1,83,60,80) | (1,83,60,80) | 186625 | 0 | 186625 | 541 |
| 118 | ConvRelu | INT8 | NPU | (1,128,60,80),(128,128,3,3),(128) | (1,128,60,80) | 327096 | 1382400 | 1382400 | 1595 |
| 119 | ConvRelu | INT8 | NPU | (1,128,60,80),(128,128,3,3),(128) | (1,128,60,80) | 327096 | 1382400 | 1382400 | 1596 |
| 120 | Conv | INT8 | NPU | (1,128,60,80),(4,128,1,1),(4) | (1,4,60,80) | 103405 | 19200 | 103405 | 150 |
| 121 | Conv | INT8 | NPU | (1,128,60,80),(1,128,1,1),(1) | (1,1,60,80) | 103345 | 19200 | 103345 | 150 |
| 122 | Sigmoid | INT8 | NPU | (1,1,60,80) | (1,1,60,80) | 32181 | 0 | 32181 | 142 |
| … | … | … | … | … | … | … | … | … | … |
| 144 | Mul | INT8 | NPU | (1,83,60,80),(1,1,60,80) | (1,83,60,80) | 319655 | 0 | 319655 | 414 |
| 145 | ReduceMax | INT8 | CPU | (1,83,60,80) | (1,1,60,80) | 0 | 0 | 0 | 7441 |
| 146 | ArgMax | INT8 | CPU | (1,83,60,80) | (1,1,60,80) | 0 | 0 | 0 | 7389 |
| 147 | Reshape | INT64 | CPU | (1,1,60,80),(3) | (1,60,80) | 0 | 0 | 0 | 69 |
| 148 | OutputOperator | INT64 | CPU | (1,60,80) | \ | 0 | 0 | 0 | 13 |
Abbildung 8-3 Leistungsanalyse zeitintensiver Operatoren
Ein zeitintensiver Operator ist nicht zwangsläufig ineffizient. Bei hoher Mac-Ausnutzung sollte seine Größe zur Laufzeitverkürzung reduziert werden. Niedrige Ausnutzung erfordert besondere Aufmerksamkeit.
8.2.3 Auswirkungen von CPU-Operatoren
Die Abbildung zeigt einige zeitintensive Operatoren auf der CPU. Ihre Verlagerung auf die NPU kann den Laufzeiteinfluss deutlich verringern. Viele Leistungsprobleme werden dadurch gelöst; CPU-Operatorzeiten verdienen daher besondere Aufmerksamkeit.
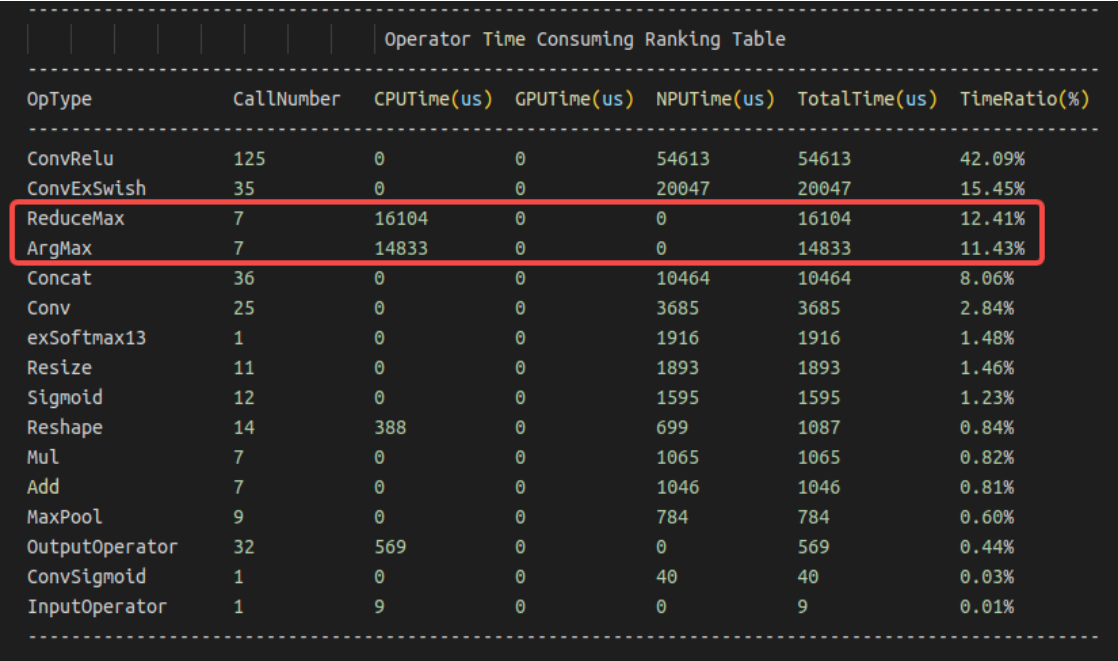
| OpType | CallNumber | CPUTime(us) | GPUTime(us) | NPUTime(us) | TotalTime(us) | TimeRatio(%) |
|---|---|---|---|---|---|---|
| ConvRelu | 125 | 0 | 0 | 54613 | 54613 | 42.09% |
| ConvExSwish | 35 | 0 | 0 | 20047 | 20047 | 15.45% |
| ReduceMax | 7 | 16104 | 0 | 0 | 16104 | 12.41% |
| ArgMax | 7 | 14833 | 0 | 0 | 14833 | 11.43% |
| Concat | 36 | 0 | 0 | 10464 | 10464 | 8.06% |
| Conv | 25 | 0 | 0 | 3685 | 3685 | 2.84% |
| exSoftmax13 | 1 | 0 | 0 | 1916 | 1916 | 1.48% |
| Resize | 11 | 0 | 0 | 1893 | 1893 | 1.46% |
| Sigmoid | 12 | 0 | 0 | 1595 | 1595 | 1.23% |
| Reshape | 14 | 388 | 0 | 699 | 1087 | 0.84% |
| Mul | 7 | 0 | 0 | 1065 | 1065 | 0.82% |
| Add | 7 | 0 | 0 | 1046 | 1046 | 0.81% |
| MaxPool | 9 | 0 | 0 | 784 | 784 | 0.60% |
| OutputOperator | 32 | 569 | 0 | 0 | 569 | 0.44% |
| ConvSigmoid | 1 | 0 | 0 | 40 | 40 | 0.03% |
| InputOperator | 1 | 9 | 0 | 0 | 9 | 0.01% |
Abbildung 8-4 Leistungsanalyse von CPU-Operatoren
Operatoren werden gewöhnlich aus folgenden Gründen außerhalb der NPU ausgeführt:
Die Operatorgröße überschreitet die Grenze; siehe Größenbeschränkungen im OpList-Dokument.
Der Operator wird noch nicht auf der NPU unterstützt. Prüfen Sie OpList; im Github-Projekt kann ein Issue eingereicht werden.
Hardwarebeschränkungen verhindern die NPU-Unterstützung; prüfen Sie eine äquivalente Algorithmusimplementierung mit anderen unterstützten NPU-Verfahren.
8.2.4 Engpässe der NPU-Operatoren analysieren
Bei langen NPU-Operatorlaufzeiten zeigen DDR Cycles/NPU Cycles/Total Cycles, ob der theoretische Engpass in Bandbreite oder Rechenleistung liegt. DDR Cycles beschreibt die Lese-/Schreibzyklen, bereits auf die NPU-Frequenz umgerechnet und deshalb direkt mit NPU Cycle vergleichbar.
Wie nachfolgend dargestellt:
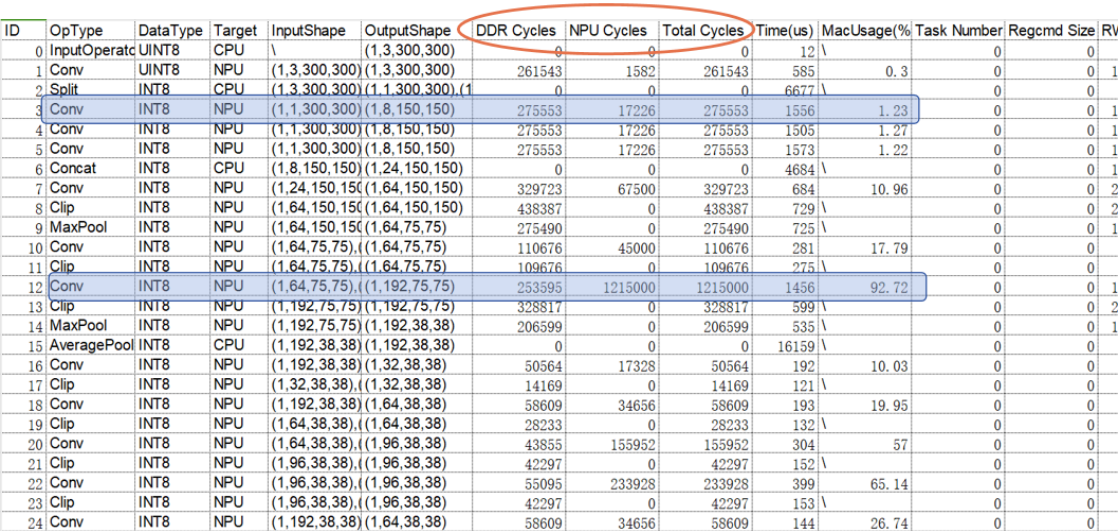
| ID | OpType | DataType | Target | InputShape | OutputShape | DDR Cycles | NPU Cycles | Total Cycles | Time(us) | MacUsage(% [clipped] | Task Number | Regcmd Size | RW [clipped] |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | InputOperat [clipped] | UINT8 | CPU | \ | (1,3,300,300) | 0 | 0 | 0 | 12 | \ | 0 | 0 | [clipped] |
| 1 | Conv | UINT8 | NPU | (1,3,300,300) | (1,3,300,300) | 261543 | 1582 | 261543 | 585 | 0.3 | 0 | 0 | 1 [clipped] |
| 2 | Split | INT8 | CPU | (1,3,300,300) | (1,1,300,300),(1 [clipped] | 0 | 0 | 0 | 6677 | \ | 0 | 0 | [clipped] |
| 3 | Conv | INT8 | NPU | (1,1,300,300) | (1,8,150,150) | 275553 | 17226 | 275553 | 1556 | 1.23 | 0 | 0 | 1 [clipped] |
| 4 | Conv | INT8 | NPU | (1,1,300,300) | (1,8,150,150) | 275553 | 17226 | 275553 | 1505 | 1.27 | 0 | 0 | 1 [clipped] |
| 5 | Conv | INT8 | NPU | (1,1,300,300) | (1,8,150,150) | 275553 | 17226 | 275553 | 1573 | 1.22 | 0 | 0 | 1 [clipped] |
| 6 | Concat | INT8 | CPU | (1,8,150,150) [clipped] | (1,24,150,150) | 0 | 0 | 0 | 4684 | \ | 0 | 0 | 1 [clipped] |
| 7 | Conv | INT8 | NPU | (1,24,150,150) | (1,64,150,150) | 329723 | 67500 | 329723 | 684 | 10.96 | 0 | 0 | 2 [clipped] |
| 8 | Clip | INT8 | NPU | (1,64,150,150) | (1,64,150,150) | 438387 | 0 | 438387 | 729 | \ | 0 | 0 | 2 [clipped] |
| 9 | MaxPool | INT8 | NPU | (1,64,150,150) | (1,64,75,75) | 275490 | 0 | 275490 | 725 | \ | 0 | 0 | 1 [clipped] |
| 10 | Conv | INT8 | NPU | (1,64,75,75) | (1,64,75,75) | 110676 | 45000 | 110676 | 281 | 17.79 | 0 | 0 | [clipped] |
| 11 | Clip | INT8 | NPU | (1,64,75,75) | (1,64,75,75) | 109676 | 0 | 109676 | 275 | \ | 0 | 0 | [clipped] |
| 12 | Conv | INT8 | NPU | (1,64,75,75) | (1,192,75,75) | 253595 | 1215000 | 1215000 | 1456 | 92.72 | 0 | 0 | 1 [clipped] |
| 13 | Clip | INT8 | NPU | (1,192,75,75) | (1,192,75,75) | 328817 | 0 | 328817 | 599 | \ | 0 | 0 | 2 [clipped] |
| 14 | MaxPool | INT8 | NPU | (1,192,75,75) | (1,192,38,38) | 206599 | 0 | 206599 | 535 | \ | 0 | 0 | 1 [clipped] |
| 15 | AveragePool [clipped] | INT8 | CPU | (1,192,38,38) | (1,192,38,38) | 0 | 0 | 0 | 16159 | \ | 0 | 0 | [clipped] |
| 16 | Conv | INT8 | NPU | (1,192,38,38) | (1,32,38,38) | 50564 | 17328 | 50564 | 192 | 10.03 | 0 | 0 | [clipped] |
| 17 | Clip | INT8 | NPU | (1,32,38,38) | (1,32,38,38) | 14169 | 0 | 14169 | 121 | \ | 0 | 0 | [clipped] |
| 18 | Conv | INT8 | NPU | (1,192,38,38) | (1,64,38,38) | 58609 | 34656 | 58609 | 139 | 19.95 | 0 | 0 | [clipped] |
| 19 | Clip | INT8 | NPU | (1,64,38,38) | (1,64,38,38) | 28233 | 0 | 28233 | 132 | \ | 0 | 0 | [clipped] |
| 20 | Conv | INT8 | NPU | (1,64,38,38) | (1,96,38,38) | 43855 | 155952 | 155952 | 304 | 57 | 0 | 0 | [clipped] |
| 21 | Clip | INT8 | NPU | (1,96,38,38) | (1,96,38,38) | 42297 | 0 | 42297 | 152 | \ | 0 | 0 | [clipped] |
| 22 | Conv | INT8 | NPU | (1,96,38,38) | (1,96,38,38) | 55095 | 233928 | 233928 | 399 | 65.14 | 0 | 0 | [clipped] |
| 23 | Clip | INT8 | NPU | (1,96,38,38) | (1,96,38,38) | 42297 | 0 | 42297 | 153 | \ | 0 | 0 | [clipped] |
| 24 | Conv | INT8 | NPU | (1,192,38,38) | (1,64,38,38) | 58609 | 34656 | 58609 | 144 | 26.74 | 0 | 0 | [clipped] |
Abbildung 8-5 Leistungsanalyse von NPU-Operatoren
Im dritten Layer sind DDR Cycles wesentlich größer als NPU Cycles: Lesen und Schreiben benötigen mehr Zyklen als die Berechnung. Der Conv-Engpass liegt somit in der Bandbreite.
Im zwölften Layer sind DDR Cycles wesentlich kleiner als NPU Cycles: Lesen und Schreiben benötigen weniger Zyklen als die Berechnung. Der Conv-Engpass liegt somit in der Rechenleistung.
NPU Cycles zeigt derzeit nur die benötigten Conv-Zyklen; weitere Operatortypen sollen später ergänzt werden.
8.3 Beschleunigung durch Quantisierung
Quantisierung reduziert Rechenaufwand und Bandbreitenbedarf erheblich. Zudem ist die INT8-Rechenleistung der NPU wesentlich höher als die FP16-Leistung, sodass Modelle deutlich schneller laufen können. Die Bereitstellung quantisierter Modelle wird empfohlen; Vorgehensweisen stehen in der Einführung zur Quantisierung.
8.4 Graphoptimierung
Graphoptimierung ermöglicht abgestimmte Verbesserungen des gesamten Modells. Nach der Ermittlung zeitintensiver Operatoren oder Teilgraphen sind verschiedene Umformungen möglich. Ziele sind das Entfernen redundanter Operatoren, das Verlagern auf die NPU und die Nutzung hardwareeffizienter Operatoren. Diese Ziele können sich widersprechen: Eine NPU-Verlagerung benötigt möglicherweise zusätzliche Operatoren. Trotz höherer Operatorzahl kann dies durch bessere Gesamtinferenzleistung sinnvoll sein.
RKNN-Toolkit2 optimiert den Graphen bereits teilweise während der Modellkonvertierung. Dies deckt jedoch nicht alle Fälle ab; in nicht berücksichtigten Szenarien bleiben redundante Operationen. Benutzer können anhand der hier beschriebenen Ideen vorab optimieren. Die Methoden sind nicht verpflichtend und müssen situationsgerecht eingesetzt werden.
8.4.1 Nicht-NPU-OPs in NPU-OPs umwandeln
Nicht-NPU-Operatoren lassen sich durch äquivalente Graphumformungen durch NPU-unterstützte Operatoren ersetzen.
Am Beispiel shufflenetv2_0.5 wird Channel-Shuffle durch eine Faltung ersetzt. Gewichte von 0/1 bewirken die Datenumordnung. Können Transpose und Reshape nicht auf der NPU ausgeführt werden, lassen sie sich zur Umordnung in Conv integrieren.
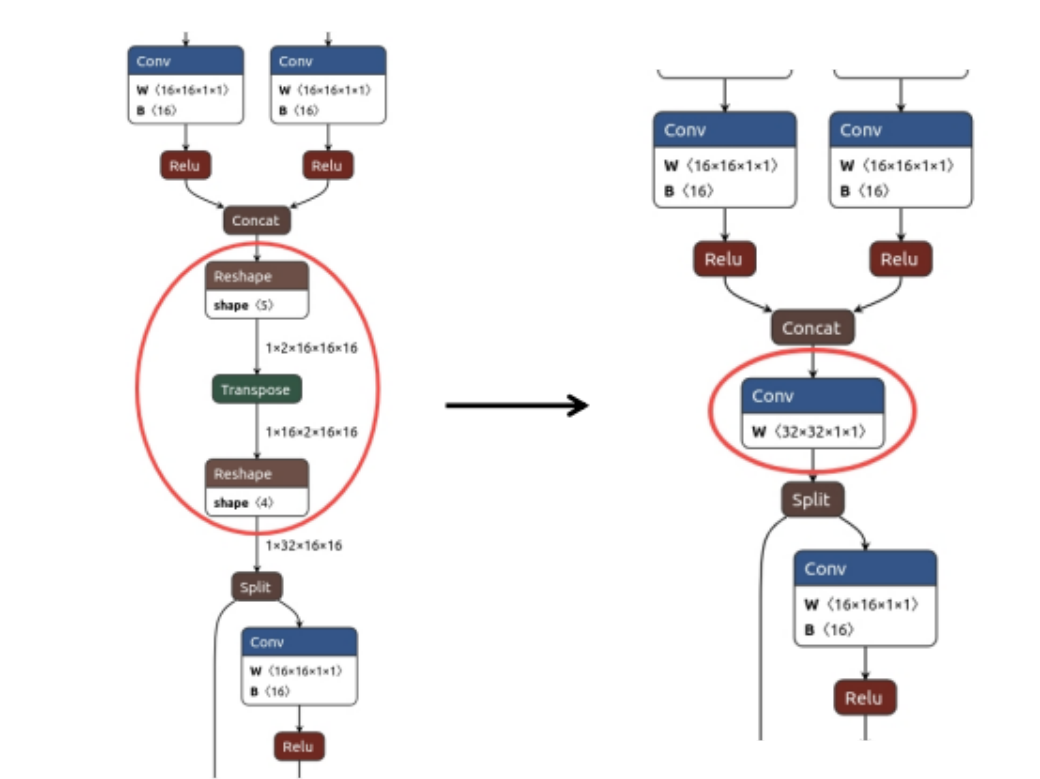
Abbildung 8-6 Umordnung durch Faltung
8.4.2 Hardware-Fusion für Netzwerkentwurf und Graphoptimierung nutzen
Die NPU unterstützt die Fusion bestimmter Operatoren. Ihr Ablauf kann entsprechend den Fusionsregeln angepasst werden.
Die RKNN-Graphoptimierung deckt nicht alle Fälle ab. Manche theoretisch fusionierbaren Strukturen werden im endgültigen Graphen nicht zusammengeführt. Dies kann durch manuelle Algorithmusanpassung behoben werden.
Beispielsweise ermöglicht eine Vertauschung von Transpose und Clip ohne Änderung des Berechnungsergebnisses die Fusion von Conv und Clip und verbessert dadurch die Leistung.
Abbildung 8-7 Graphoptimierung und Operatorfusion
Hardware-Fusionsregeln:
| Unterstützte Fusionsregeln | Für die Zukunft geplante Fusionsregeln |
|---|---|
| Conv+Relu | Activation+Add(Mul) |
| Conv+PRelu(LeakyRelu) | Add(Mul)+Activation |
| Conv+Clip | Conv+Mul |
| Conv+Sigmoid(Tanh/Elu/Silu…) | Conv+Activation+Mul |
| Conv+Add | Conv+Activation+Pooling |
| Conv+Activation+Add | Conv+Activation+Add(Mul)+Pooling |
8.4.3 Teilgraphumformung
Manchmal wird ein Algorithmus zugunsten der Anschaulichkeit ohne Berücksichtigung der Bereitstellungsleistung entworfen und erzeugt komplexe, redundante Graphen. Äquivalente Umformungen eines Teilbereichs können die Rechenschritte reduzieren.
Die gezeigte äquivalente Yolov5-nano-Umformung integriert mehrere komplexe Slice-Operationen in Conv zu einem neuen Conv und vereinfacht den Graphen deutlich.
Quelle des Ansatzes: https://github.com/ultralytics/yolov5/issues/4825
Abbildung 8-8 Äquivalente Graphumformung
8.4.4 „Gleichartige Terme zusammenfassen“ und „Gemeinsame Faktoren ausklammern“
Mehrfach hintereinander ausgeführte Operationen lassen sich zu einem Operator zusammenfassen, etwa Reshape, Transpose, Slice und bestimmte Add/Mul/Sub/Div.
Im folgenden Beispiel werden gleichartige Operatoren durch eine einfache Umordnung des Graphen zusammengeführt.
Abbildung 8-9 Zusammenfassen gleichartiger Operatoren
Gemeinsame Teile mancher Graphstrukturen lassen sich durch Umordnung gleichartiger Operationen in eine einzige Operation auslagern.
Beispielsweise lässt sich reshape durch Umordnung der Operatoren auslagern und nur einmal ausführen.
Abbildung 8-10 Zusammenführen wiederholter Operatoren
8.5 Optimierung auf Operatorebene
Optimierung auf Operatorebene ist gezielter: Anpassungen bestimmter Operatoren können weitere Leistungssteigerungen bringen. Entscheidend sind Größen, die die Hardware besonders effizient verarbeitet. Ähnlich große Operatoren können bei ausgerichteten und nicht ausgerichteten Dimensionen stark unterschiedliche Laufzeiten haben, weil die Hardware bei Letzteren zusätzliche Operationen zur Korrektheit benötigt. Deshalb beeinflusst die Größenwahl die Leistung erheblich. Nachfolgend einige Ansätze.
8.5.1 DDR-freundliche OP-Größen (nicht verpflichtend)
Bestimmte ausgerichtete Größen verbessern sowohl die NPU-Recheneffizienz als auch DDR-Zugriffe. Bei gleicher Bandbreite erhöhen günstigere Zugriffe die DDR-Effizienz und damit die Leistung. Nachfolgend stehen nicht verpflichtende Größenempfehlungen.
Anforderungen an die Kanalausrichtung
Die Anforderungen stehen in der folgenden Tabelle.
Tabelle 8-1 RK3566/RK3568
| Conv | Depthwise Conv | Andere OP | ||
|---|---|---|---|---|
| Datentyp | Eingabe- kanäle |
Ausgabe- kanäle |
Eingabe- und Ausgabekanäle |
Eingabe- und Ausgabekanäle |
| Int8 | 32 | 16 | 32 | 8 |
| Int16 | 16 | 8 | 16 | 4 |
| Float16 | 16 | 8 | 16 | 4 |
| BFloat16 | 16 | 8 | 16 | 4 |
Tabelle 8-2 RK3588/RK3576/RV1126B
| Conv | Depthwise Conv | Andere OP | ||
|---|---|---|---|---|
| Datentyp | Eingabe- kanäle |
Ausgabe- kanäle |
Eingabe- und Ausgabekanäle |
Eingabe- und Ausgabekanäle |
| Int8 | 32 | 32 | 64 | 16 |
| Int16 | 32 | 16 | 32 | 8 |
| Float16 | 32 | 16 | 32 | 8 |
| BFloat16 | 32 | 16 | 32 | 8 |
| TFloat32 | 16 | 16 | 16 | 4 |
Tabelle 8-3 RV1106/RV1103
| Conv | Depthwise Conv | Andere OP | ||
|---|---|---|---|---|
| Datentyp | Eingabe- kanäle |
Ausgabe- kanäle |
Eingabe- und Ausgabekanäle |
Eingabe- und Ausgabekanäle |
| Int8 | 32 | 16 | 32 | 16 |
| Int16 | 16 | 16 | 16 | 8 |
Tabelle 8-4 RK3562
| Conv | Depthwise Conv | Andere OP | ||
|---|---|---|---|---|
| Datentyp | Eingabe- kanäle |
Ausgabe- kanäle |
Eingabe- und Ausgabekanäle |
Eingabe- und Ausgabekanäle |
| Int8 | 32 | 16 | 32 | 16 |
| Int16 | 32 | 8 | 16 | 8 |
| Float16 | 32 | 8 | 16 | 8 |
| BFloat16 | 32 | 8 | 16 | 8 |
| TFloat32 | 16 | 8 | 8 | 4 |
Ausrichtung auf 4 bei Height * Width > 1
Bei gleicher Größe sind Operatoren mit größerer Width und kleinerer Height DDR-freundlicher. In der Abbildung ist die rechte Faltung effizienter als die linke.
Abbildung 8-11 Vergleich gleich großer Faltungen
8.5.2 Operatoren mit hoher Ausnutzung entwerfen
Für eine hohe Gesamtausnutzung der Rechenleistung sollten ineffiziente Operatoren vermieden und günstige Größen gewählt werden. Nachfolgend werden möglichst zu vermeidende Operatoren sowie der Zusammenhang zwischen Faltungsgröße und Ausnutzung erläutert.
Ineffiziente Operatoren vermeiden
Reduzieren Sie möglichst die folgenden drei Operatortypen.
Tabelle 8-5 Drei Arten ineffizienter Operatoren
| Datenübertragung | Größenumformung | Andere Aktivierungsfunktion als Relu |
|---|---|---|
| Transpose | Resize | Sigmoid |
| Reshape | Tile | Tanh |
| Split | Pooling | Softplus |
| Concat | Pad | Hardswish |
Zusammenhang zwischen Faltungsgröße und Ausnutzung
Faltungsleistung hängt sowohl von Rechenleistung als auch Bandbreite ab. Daher wird häufig die MAC-Ausnutzung verwendet, um die Nutzung der Hardware-Rechenleistung zu beschreiben.
Dieser Zusammenhang dient als Orientierung beim Modellentwurf. Nachfolgend ungefähre Richtwerte auf Basis empirischer Daten:
Bezeichnungen: KH — Kernelhöhe, KW — Kernelbreite, KC — Kernelkanäle, type_bytes — Gewichtsbitbreite geteilt durch 8, Ksize — KW oder KH, Kstride — Schrittweite in KW- oder KH-Richtung.
Erfüllt die Kanalzahl des Eingabe- und Ausgabe-Tensor der Faltung die Ausrichtungsanforderungen (siehe Tabelle in 8.4.1), ist die Ausnutzung höher.
Bei einer Eingabe-Tensor-Kanalzahl < 256 ist die Ausnutzung relativ hoch. Bei > 512 nimmt sie mit zunehmender Kanalzahl allmählich ab.
Bezüglich der Gewichtsgröße ist die Ausnutzung bei KH* KW * KC * type_bytes < 6K Bytes relativ hoch. Oberhalb einer bestimmten Größe sinkt sie deutlich.
Je größer Ksize / Kstride, desto höher die Ausnutzung. Beispielsweise ist Ksize=3, Kstride=1 günstiger als Ksize=2, Kstride=1.
Die Ausnutzung sinkt, wenn Height * Width des Ausgabe-Tensor < 16 ist.
Je größer Channel des Ausgabe-Tensor, desto höher die Ausnutzung.
Oben wurden die Größeneinflüsse einzeln betrachtet. Die tatsächliche MAC-Ausnutzung einer Faltung im bereitgestellten Modell ergibt sich aus dem Zusammenspiel vieler Faktoren.
8.5.3 Teilgraphfusion
RKNN ordnet bestimmte Graphbeziehungen benutzerdefinierten Operatoren zu, wie unten gezeigt. Erfolgt keine Zusammenführung, prüfen Sie, ob abweichende Verbindungen die Mustererkennung verhindern.
Abbildung 8-12 Glu-Teilgraphfusion
Abbildung 8-13 LayerNorm-Teilgraphfusion
Unterstützte Teilgraph-Fusionsregeln:
Split + Sigmoid + Mul -> GLU
ReduceMean + Sub + Pow + ReduceMean + Add + Sqrt + Div (+ Mul + Add) -> LayerNorm
9 Speicherbedarf optimieren
9.1 Speicheraufteilung und Analysemethoden
9.1.1 Speicheraufteilung während der RKNN-Modellausführung
Der Laufzeitspeicher eines RKNN-Modells besteht hauptsächlich aus vier Teilen: Gewichten und internen Tensoren, Registerkonfigurationen, Eingabe- und Ausgabetensoren. Üblicherweise wird er während rknn_init angelegt.
9.1.2 Modellspeicher analysieren
Nach rknn_init() bei Bedarf den zugewiesenen Modellspeicher abfragen oder die externe Zuweisung der Gewichte vorbereiten: rknn_query mit RKNN_QUERY_MEM_SIZE aufrufen. Abgefragt werden Gewichte und interner Speicher ohne Ein-/Ausgaben sowie die für die Inferenz belegten DMA- und SRAM-Speicherbereiche. SRAM wird als 0 gemeldet, wenn es nicht aktiviert oder diese Funktion nicht vorhanden ist.
Beispielcode:
 rknn_context ctx = 0;
 // Load RKNN Model
 int ret = rknn_init(&ctx, model_path, 0, NULL, NULL);
 if (ret < 0) {
  printf("rknn_init fail! ret=%d\n", ret);
  return -1;
 }

 // Get weight and internal mem size
 rknn_mem_size mem_size;
 ret = rknn_query(ctx, RKNN_QUERY_MEM_SIZE, &mem_size, sizeof(mem_size));
 if (ret != RKNN_SUCC) {
  printf("rknn_query fail! ret=%d\n", ret);
  return -1;
 }
 printf("total weight size: %d, total internal size: %d\n", mem_size.total_weight_size, mem_size.total_internal_size);
9.2 Extern zugewiesenen Speicher verwenden
9.2.1 Ein- und Ausgabespeicher extern zuweisen
Wie im C-API-Zero-Copy-Ablauf beschrieben, können Ein- und Ausgabetensoren bei Verwendung der Zero-Copy-API extern zugewiesen und anschließend für die NPU konfiguriert werden. Den detaillierten Ablauf zeigt das zugehörige Zero-Copy-Flussdiagramm. Externe Speicherzuweisung ist nur über die Zero-Copy-API möglich. Dies ist vor allem für Anwendungen gedacht, die NPU-Speicher selbst verwalten, anstatt ihn über rknn_create_mem() anzulegen.
Externer Speicher kann über physische Adresse oder fd beschrieben werden. Dafür dienen hauptsächlich diese beiden Schnittstellen:
rknn_create_mem_from_phys(): Erzeugt die Struktur rknn_tensor_mem anhand der physischen Adresse.
rknn_create_mem_from_fd(): Erzeugt die Struktur rknn_tensor_mem anhand des fd.
Das folgende Beispiel weist Speicher über mpi mmz zu. rknn_create_mem_from_phys() verwendet die physische Adresse des externen Speichers, um eine rknn_tensor_mem-Struktur mit den physischen Speicherinformationen zu erzeugen.
......

// Create input tensor memory
rknn_tensor_mem* input_mems[1];
// default input type is int8 (normalize and quantize need compute in outside)
// if set uint8, will fuse normalize and quantize to npu
input_attrs[0].type = input_type;
// default fmt is NHWC, npu only support NHWC in zero copy mode
input_attrs[0].fmt = input_layout;

input_mems[0] = rknn_create_mem_from_phys(ctx, input_phys, input_virt, input_attrs[0].size_with_stride);

......

// Create output tensor memory
rknn_tensor_mem* output_mems[io_num.n_output];
for (uint32_t i = 0; i < io_num.n_output; ++i) {
  output_mems[i] = rknn_create_mem_from_phys(ctx, output_physs[i], output_virts[i], output_attrs[i].size);
}

// Set input tensor memory
ret = rknn_set_io_mem(ctx, input_mems[0], &input_attrs[0]);
if (ret < 0) {
  printf("rknn_set_io_mem fail! ret=%d\n", ret);
  return -1;
}

// Set output tensor memory
for (uint32_t i = 0; i < io_num.n_output; ++i) {
  // set output memory and attribute
  ret = rknn_set_io_mem(ctx, output_mems[i], &output_attrs[i]);
  if (ret < 0) {
    printf("rknn_set_io_mem fail! ret=%d\n", ret);
    return -1;
  }
}
Neben der physischen Adresse lässt sich extern zugewiesener Speicher auch über fd verwenden. Beispielcode:
int mb_flags = RK_MMZ_ALLOC_TYPE_CMA | RK_MMZ_ALLOC_UNCACHEABLE;

// Allocate weight memory in outside
MB_BLK weight_mb;
rknn_tensor_mem* weight_mem;
ret = RK_MPI_MMZ_Alloc(&weight_mb, mem_size.total_weight_size, mb_flags);
if (ret < 0) {
  printf("RK_MPI_MMZ_Alloc failed, ret: %d\n", ret);
  return ret;
}
void* weight_virt = RK_MPI_MMZ_Handle2VirAddr(weight_mb);
if (weight_virt == NULL) {
  printf("RK_MPI_MMZ_Handle2VirAddr failed!\n");
  return -1;
}
int weight_fd = RK_MPI_MMZ_Handle2Fd(weight_mb);
if (weight_fd < 0) {
  printf("RK_MPI_MMZ_Handle2Fd failed!\n");
  return -1;
}
weight_mem = rknn_create_mem_from_fd(ctx, weight_fd, weight_virt, mem_size.total_weight_size, 0);
printf("weight mb info: virt = %p, fd = %d, size: %d\n", weight_virt, weight_fd, mem_size.total_weight_size);
9.2.2 Modellspeicher extern zuweisen
Wie im Abschnitt zur Speicheraufteilung und -analyse erläutert, besteht Modellspeicher aus internem Speicher und Gewichtsspeicher. Für extern zugewiesenen Modellspeicher die Gewichte über rknn_set_weight_mem() und den internen Speicher über rknn_set_internal_mem() konfigurieren. Beispielcode:
// Load RKNN Model
ret = rknn_init(&ctx, model_virt, model_size, RKNN_FLAG_MEM_ALLOC_OUTSIDE, NULL);
TIME_END(rknn_init);
if (ret < 0) {
  printf("rknn_init fail! ret=%d\n", ret);
  return -1;
}

//query and inset input / output tensor
......

// Allocate weight memory in outside
MB_BLK weight_mb;
rknn_tensor_mem* weight_mem;
ret = RK_MPI_MMZ_Alloc(&weight_mb, SIZE_ALIGN_128(mem_size.total_weight_size), mb_flags);
void* weight_virt = RK_MPI_MMZ_Handle2VirAddr(weight_mb);
int weight_fd = RK_MPI_MMZ_Handle2Fd(weight_mb);

weight_mem = rknn_create_mem_from_fd(ctx, weight_fd, weight_virt, mem_size.total_weight_size, 0);

ret = rknn_set_weight_mem(ctx, weight_mem);
if (ret < 0) {
  printf("rknn_set_weight_mem fail! ret=%d\n", ret);
  return -1;
}
printf("weight mb info: virt = %p, fd = %d, size: %d\n", weight_virt, weight_fd, mem_size.total_weight_size);

// Allocate internal memory in outside
MB_BLK internal_mb;
rknn_tensor_mem* internal_mem;
ret = RK_MPI_MMZ_Alloc(&internal_mb, SIZE_ALIGN_128(mem_size.total_internal_size), mb_flags);
void* internal_virt = RK_MPI_MMZ_Handle2VirAddr(internal_mb);
int internal_fd = RK_MPI_MMZ_Handle2Fd(internal_mb);

internal_mem = rknn_create_mem_from_fd(ctx, internal_fd, internal_virt, mem_size.total_internal_size, 0);
ret = rknn_set_internal_mem(ctx, internal_mem);
if (ret < 0) {
  printf("rknn_set_internal_mem fail! ret=%d\n", ret);
  return -1;
}
printf("internal mb info: virt = %p, fd = %d, size: %d\n", internal_virt, internal_fd, mem_size.total_internal_size);
9.3 Internen Speicher wiederverwenden
Die RKNN-API ermöglicht externe Verwaltung des NPU-Speichers. RKNN_FLAG_MEM_ALLOC_OUTSIDE legt fest, dass Speicher für die Zwischenmerkmale des Modells extern zugewiesen wird. Typische Anwendungen:
Bei der Bereitstellung weist der Benutzer den gesamten NPU-Speicher selbst zu und kann damit die Speicheraufteilung des Gesamtsystems koordinieren.
Beim seriellen Ausführen mehrerer Modelle wird der Speicher für Zwischenmerkmale in verschiedenen Kontexten wiederverwendet. Dies ist besonders für Geräte wie RV1103/RV1106 mit stark begrenztem Speicher nützlich.
Im Quelldiagramm belegt Internal Tensor von Modell 1 mehr Speicher als Modell 2. Bei serieller Ausführung kann die Anwendung für beide einen gemeinsamen Bereich 0x00000000~0x000c4000 zuweisen. Nach der Inferenz von Modell 1 verwendet Modell 2 denselben Bereich zum Lesen/Schreiben seiner Internal-Tensor-Daten und spart dadurch Speicher. Dies sind schematische Quelladressen, keine validierten Board-Adressen.
Abbildung 9-1: Internal Tensor zweier Modelle teilen denselben Speicheradressraum
Die Modellpfade seien model_path_a und model_path_b. Beispielcode:
rknn_init(&ctx_a, model_path_a, 0, RKNN_FLAG_MEM_ALLOC_OUTSIDE, NULL);
rknn_query(ctx_a, RKNN_QUERY_MEM_SIZE, &mem_size_a, sizeof(mem_size_a));

rknn_init(&ctx_b, model_path_b, 0, RKNN_FLAG_MEM_ALLOC_OUTSIDE, NULL);
rknn_query(ctx_b, RKNN_QUERY_MEM_SIZE, &mem_size_b, sizeof(mem_size_b));

// Get the largest internal size of the two models
max_internal_size = MAX(mem_size_a.total_internal_size, mem_size_b.total_internal_size);
internal_mem_max = rknn_create_mem(ctx_a, max_internal_size);
// Set a model internal memory
internal_mem_a = rknn_create_mem_from_fd(ctx_a, internal_mem_max->fd,
internal_mem_max->virt_addr, mem_size_a.total_internal_size, 0);
rknn_set_internal_mem(ctx_a, internal_mem_a);
// Set b model internal memory
internal_mem_b = rknn_create_mem_from_fd(ctx_b, internal_mem_max->fd,
internal_mem_max->virt_addr, mem_size_b.total_internal_size, 0);
rknn_set_internal_mem(ctx_b, internal_mem_b);
9.4 RKNN-Kontext in mehreren Threads wiederverwenden
In einer Multithread-Anwendung kann ein Modell gleichzeitig von mehreren Threads ausgeführt werden. Initialisiert jeder einen eigenen Kontext, steigt der Speicherbedarf stark. Die Anwendung kann daher eine gemeinsame Kontextnutzung erwägen, um wiederholte RKNN-Kontextzuweisung zu vermeiden und Laufzeitspeicher zu sparen.
Die RKNN-API stellt folgende Schnittstelle zur Kontextwiederverwendung bereit:
int rknn_dup_context(rknn_context* context_in,rknn_context* context_out)
context_in ist der initialisierte Kontext; context_out ist der Kontext, der context_in wiederverwendet.
Im folgenden Diagramm ist die Modellstruktur beider Kontexte identisch, wodurch Kontextwiederverwendung möglich ist.
Abbildung 9-2: Kontextwiederverwendung bei zwei identischen Modellen
9.5 Gewichte zwischen Modellen mit unterschiedlicher Auflösung teilen
Sind die Gewichte mehrerer Modelle mit unterschiedlichen Auflösungen identisch, können sie zur Speicherersparnis geteilt werden. In RKNPU SDK <= 1.5.0 ermöglicht dies dynamischen Auflösungswechsel bei geringem Speicherbedarf; nach 1.5.0 wird dieser Mechanismus laut Quelle durch dynamic shape ersetzt.
Im folgenden Diagramm sind die Gewichte der Modelle A und B vollständig identisch.
Abbildung 9-3: Gemeinsame Gewichte zweier Modelle mit unterschiedlichen Auflösungen
Gemeinsame Gewichte für Modelle unterschiedlicher Auflösung werden wie folgt umgesetzt:
1. Bei der RKNN-Konvertierung ein Modell als Master mit remove_weight=False in rknn.config und das andere als Slave mit remove_weight=True konfigurieren. Das Master-RKNN-Modell enthält die Gewichte; das Slave-Modell enthält keine Gewichte der Faltungsklasse.
2. Bei der Bereitstellung zuerst das Master-RKNN-Modell, danach das Slave-Modell initialisieren. Beim Slave RKNN_FLAG_SHARE_WEIGHT_MEM und den Parameter rknn_init_extend mit dem Master-Kontext verwenden. Die Modellpfade seien model_A und model_B. Beispielcode:
rknn_context context_A;
rknn_context context_B;
ret = rknn_init(&context_A,model_A,0,0,NULL);
...
rknn_init_extend extend;
extend.ctx = context_A;
ret = rknn_init(&context_B,model_B,0,RKNN_FLAG_SHARE_WEIGHT_MEM,&extend);
10 Fehlerbehebung
10.1 Probleme mit der NPU-SDK-Umgebung
Versionskompatibilität
NPU-Kerneltreiber und Runtime
Es wird empfohlen, den NPU-Kerneltreiber auf Version 0.9.2 oder höher zu aktualisieren. Versuchen Sie bei Problemen, diese durch ein Update auf die neueste NPU-Kerneltreiberversion zu beheben.
RKNN-Modell (Version durch RKNN-Toolkit2 bestimmt) und Runtime:
Tabelle 10-1 Zuordnung von RKNN-Modell- und Runtime-Versionen
| RKNN-Modellversion | Runtime-Version |
|---|---|
| 1.2.0 | >=1.2.0 und <=1.5.0 |
| 1.3.0 | >=1.3.0 und <=1.5.0 |
| 1.4.0 | >=1.4.0 und <=1.5.0 |
| 1.5.0 | 1.5.0 |
| 1.5.2 | >=1.5.2 |
| 1.6.0 | >=1.5.2 |
| 2.0.0 | >=2.0.0 |
| 2.1.0 | >=2.1.0 |
NPU-Kerneltreiber aktualisieren
Zum Aktualisieren des NPU-Treibers wird ein Update der vollständigen Firmware empfohlen. Diese muss vom Boardhersteller bereitgestellt werden.
NPU in Docker verwenden
Ordnen Sie beim Start des Docker-Containers die NPU-Ressourcen den angegebenen Pfaden zu. Beispielbefehle:
docker run -t -i --privileged -v /dev/dri/renderD129:/dev/dri/renderD129 -v /proc/device-tree/compatible:/proc/device-tree/compatible -v /usr/lib/librknnrt.so:/usr/lib/librknnrt.so ai_application:v1.0.0 /bin/bash
Parametererklärung:
/dev/dri/renderD129 ist der NPU-Geräteknoten des RK3588. Runtime benötigt diesen Knoten zum Aktivieren der NPU.
/proc/device-tree/compatible enthält das SOC-Modell. Komponenten wie RKNN-Toolkit Lite2 beziehen daraus Informationen zum aktuellen SOC.
/usr/lib/librknnrt.so ist die Runtime-Datei. RKNN-Toolkit Lite2 und RKNPU2 C API benötigen sie für den Zugriff auf NPU-Ressourcen.
ai_application:v1.0.0 bedeutet <Docker-Image-Name>:<Version>.
10.2 Installationsprobleme bei RKNN-Toolkit2
Zu strenge Abhängigkeiten verhindern die Installation von RKNN-Toolkit2
Wenn alle benötigten Bibliotheken installiert sind, manche Versionen jedoch nicht den Anforderungen entsprechen, können Sie –no-deps an den Installationsbefehl anhängen, um die Umgebungsprüfung bei der Installation des Python-wheel-Pakets zu deaktivieren:
pip install rknn-toolkit2*.whl --no-deps
PyTorch-Abhängigkeit
Empfohlene PyTorch-Versionen: 1.6.0, 1.9.0, 1.10 oder 1.13.1.
Die Ladefunktion für PyTorch-Modelle hängt von der PyTorch-Bibliothek ab. PyTorch-Modelle werden in Gleitkomma- und quantisierte Modelle unterteilt, einschließlich QAT- und PTQ-Modellen.
Für mit PyTorch 1.6.0 exportierte Modelle wird empfohlen, die von RKNN-Toolkit2 verwendete PyTorch-Version herunterzustufen, um Ladefehler zu vermeiden.
Für quantisierte Modelle (QAT, PTQ) wird empfohlen, sie mit PyTorch 1.10~1.13.1 zu exportieren und die PyTorch-Abhängigkeit von RKNN-Toolkit2 auf 1.10~1.13.1 zu aktualisieren.
Zusammenfassend sollte die für den Modellexport verwendete PyTorch-Version möglichst der PyTorch-Version entsprechen, von der RKNN-Toolkit2 abhängt.
TensorFlow-Abhängigkeit
Empfohlene TensorFlow-Versionen: 2.6.2, 2.8.0.
Das Laden von TensorFlow-Modellen in RKNN-Toolkit2 hängt von der TensorFlow-Bibliothek ab. Wegen der begrenzten Kompatibilität zwischen TensorFlow-Versionen können andere Versionen beim Laden Fehler verursachen. Die beim Export verwendete Tensorflow-Version sollte deshalb möglichst der Tensorflow-Abhängigkeit von RKNN-Toolkit2 entsprechen.
Probleme aufgrund der TensorFlow-Version treten normalerweise bei rknn.load_tensorflow() auf; die Fehlermeldung verweist auf den Pfad der verwendeten TensorFlow-Bibliothek.
Namenskonvention des RKNN-Toolkit2-Installationspakets
Am Beispiel der veröffentlichten Version 1.5.2 gelten folgende Namensregeln für das RKNN-Toolkit2-wheel-Paket:
rknn_toolkit2-1.5.2+b642f30c-cp38-cp38-linux_x86_64.whl
rknn_toolkit2: Werkzeugname.
1.5.2: Version.
b642f30c: Commit-ID.
cp<xx>-cp<xx>: unterstützte Python-Version; cp38-cp38 steht beispielsweise für Python 3.8.
linux_x86_64: Systemtyp und CPU-Architektur.
Ein nicht passender Systemtyp, eine nicht passende CPU-Architektur oder Python-Version führt zum Fehlschlagen der RKNN-Toolkit2-Installation.
Ist eine ARM-Linux-Version von RKNN-Toolkit2 verfügbar?
Es gibt keine ARM-Linux-Version. Für Inferenz über die Python-Schnittstelle unter ARM Linux können Sie RKNN-Toolkit-lite2 installieren, das dies unterstützt.
Installation der bfloat16-Bibliothek fehlgeschlagen
Bei der Installation der bfloat16-Bibliothek ist folgender Fehler aufgetreten:
Der Original-Screenshot ist abgeschnitten; nur sichtbarer Text wurde übertragen. Unsichtbare Teile werden nicht ergänzt.
bfloat16.cc:2013:57: note: expected a type, got ‘bfloat16’
bfloat16.cc:2013:57: error: type/value mismatch at argument 2 in templa
e, class Functor> struct greenwaves::{anonymous}::UnaryUFunc’
bfloat16.cc:2013:57: note: expected a type, got ‘bfloat16’
bfloat16.cc:2015:67: error: ‘>>’ should be ‘> >’ within a nested templa
RegisterUFunc<BinaryUFunc<bfloat16, bfloat16, ufuncs::NextAfter>>(
                                                               ^
bfloat16.cc:2015:58: error: type/value mismatch at argument 1 in templa
e, class Functor> struct greenwaves::{anonymous}::BinaryUFunc’
RegisterUFunc<BinaryUFunc<bfloat16, bfloat16, ufuncs::NextAfter>>(
Abbildung 10-1 Fehlerprotokoll der Installation der bfloat16-Abhängigkeit
Wechseln Sie die pip-Paketquelle zu Alibaba oder aktualisieren Sie RKNN-Toolkit2 auf 1.5.0 oder neuer; ab 1.5.0 entfällt die Abhängigkeit von bfloat16.
10.3 Beschreibung der Modellkonvertierungsparameter
Dieser Abschnitt erläutert hauptsächlich die Verwendung häufig benötigter Parameter bei der Modellkonvertierung.
Durch das Modell bestimmte Parameter
Bei der Modellkonvertierung beeinflussen rknn.config() und rknn.build() das Ergebnis. Auch die über rknn.load_onnx und rknn.load_tensorflow() festgelegten Ein- und Ausgabeknoten sowie die über rknn.load_pytorch() und rknn.load_tensorflow() angegebenen Eingabegrößen beeinflussen es.
Grundlegende Schritte der Modellkonvertierung:
1. Quantisierungsdaten vorbereiten und die Datei dataset.txt bereitstellen.
2. Die NPU-Plattform, etwa RK3566 oder RV1106, bestimmen und target_platform in rknn.config() setzen.
3. Bei einem 3-kanaligen Eingabebild und Quantisierungsdaten im Bildformat (jpg, png) klären, ob das Modell RGB oder BGR erwartet, und entsprechend quant_img_RGB2BGR in rknn.config() setzen.
4. Die beim Training verwendeten Normalisierungsparameter prüfen, um mean_values und std_values in rknn.config festzulegen.
5. Die Modelleingabegröße prüfen und die entsprechenden Parameter der load-Schnittstelle setzen, beispielsweise input_size_list in rknn.load_pytorch().
6. Die erforderliche Quantisierungsbitbreite bestimmen, um quantized_dtype in rknn.config() festzulegen. Entfällt die Quantisierung oder wird ein bereits quantisiertes Modell geladen, kann dieser Schritt übersprungen werden.
7. Den Quantisierungsalgorithmus bestimmen, um quantized_algorithm in rknn.config() festzulegen. Entfällt die Quantisierung oder wird ein bereits quantisiertes Modell geladen, kann dieser Schritt übersprungen werden.
8. Prüfen, ob eine Quantisierung erforderlich ist, um do_quantization in rknn.build() festzulegen. Bei aktivierter Quantisierung muss dataset in rknn.build() die Quantisierungsdaten angeben.
Plattformübergreifende Kompatibilität von RKNN-Modellen
Für die durch target_platform in rknn.config() festgelegte Plattform gelten folgende Kompatibilitätsbeziehungen:
Das RKNN-Modell für RK3566 kann auf RK3568 verwendet werden.
Das RKNN-Modell für RK3588 kann auf RK3588s verwendet werden.
Das RKNN-Modell für RV1106 kann auf RV1103 verwendet werden.
Format und Anforderungen der Quantisierungsdaten
Quantisierungsdaten können in zwei Formaten vorliegen: als Bilder (jpg, png), die RKNN-Toolkit2 über OpenCV liest, oder als npy-Dateien, die über numpy eingelesen werden.
Für Modelle ohne RGB/BGR-Bildeingabe wird empfohlen, Quantisierungsdaten im numpy-npy-Format bereitzustellen.
Format von dataset.txt bei mehreren Modelleingaben
Für die Modellquantisierung muss dataset.txt die Datenpfade angeben. Jede Zeile bildet einen Eingabesatz. Bei mehreren Eingaben werden diese in derselben Zeile durch Leerzeichen getrennt aufgeführt.
Beispiel: Modell mit einer Eingabe und zwei Quantisierungsdatensätzen:
sampleA.npy
sampleB.npy
Beispiel: Modell mit drei Eingaben und zwei Quantisierungsdatensätzen:
sampleA_in0.npy sampleA_in1.npy sampleA_in2.npy
sampleB_in0.npy sampleB_in1.npy sampleB_in2.npy
quant_img_RGB2BGR in rknn.config() prüfen
Bei Bildern (jpg, png) als Quantisierungsdaten muss quant_img_RGB2BGR berücksichtigt werden.
Wurde das Modell mit RGB-Bildern trainiert, setzen Sie quant_img_RGB2BGR auf False oder lassen die Einstellung weg. Verwenden Sie dann sowohl für Python API als auch RKNPU2 CAPI RGB-Eingabebilder.
Wurde das Modell mit BGR-Bildern trainiert, setzen Sie quant_img_RGB2BGR auf True. Verwenden Sie für Python API und RKNPU2 CAPI BGR-Eingabebilder. quant_img_RGB2BGR beeinflusst ausschließlich das Einlesen der Bilder beim Quantisieren.
Bei Quantisierungsdaten im numpy-npy-Format sollte quant_img_RGB2BGR zur Vermeidung von Verwechslungen nicht verwendet werden.
Berechnungsreihenfolge von mean, std und quant_img_RGB2BGR in rknn.config()
quant_img_RGB2BGR beeinflusst nur das Lesen von Bildern beim Quantisieren, nicht die anderen Schritte.
Daher wird bei den Inferenzschnittstellen von RKNN-Toolkit2 Python API und RKNPU2 C API zuerst Mean von den Eingabedaten abgezogen, anschließend durch std dividiert und das Ergebnis dem RKNN-Modell zugeführt.
mean_values und std_values in rknn.config() für Modelle mit einer anderen Kanalzahl als 3 oder mit mehreren Eingaben einstellen.
mean_values und std_values verwenden dasselbe Einstellungsformat. Als Beispiel dient mean_values.
Bei N Eingabekanälen lautet mean_values: [[channel_1, channel_2, channel_3, channel_4, …, channel_n]].
Bei mehreren Eingaben lautet mean_values: [[channel_1, channel_2, channel_3, channel_4, …, channel_n], [channel_1, channel_2, channel_3, channel_4, …, channel_n]].
Quantisierungsalgorithmus und Anzahl der Quantisierungsbilder
RKNN-Toolkit2 bietet über quantized_algorithm in rknn.config() drei Algorithmen zur Kalibrierung der Quantisierungsparameter: normal, mmse und kl_divergence. Standard ist normal.
normal ist der grundlegende Quantisierungsalgorithmus.
mmse verarbeitet die Berechnungsergebnisse der Zwischenschichten iterativ und begrenzt Gewichte auf einen bestimmten Bereich, um die Inferenzgenauigkeit zu erhöhen. Eine Verbesserung ist nicht garantiert; gegenüber normal benötigt die Quantisierung mehr Speicher und Zeit.
kl_divergence benötigt mehr Zeit als normal, aber wesentlich weniger als mmse. In bestimmten Szenarien mit ungleichmäßiger Merkmalsverteilung sind bessere Ergebnisse möglich.
Verwenden Sie zunächst normal. Bei unzureichender Quantisierungsgenauigkeit versuchen Sie mmse oder kl_divergence.
Für normal oder kl_divergence werden 20-200 Datensätze empfohlen, für mmse 20-50.
Unterschiede der Ein- und Ausgaben bei der Inferenz quantisierter und nicht quantisierter Modelle
Beim allgemeinen RKNPU2 C API, also ohne pass_through oder zero_copy, hängt der Eingabedatentyp wie uint8 oder float nicht davon ab, ob das Modell quantisiert ist. Ausgaben können automatisch in float32 umgewandelt werden oder das Modellformat behalten. Bei der Python-Inferenzschnittstelle bestehen Unterschiede; die genaue Zuordnung folgt:
Tabelle 10-2 Unterschiede zwischen Python-Inferenzschnittstelle und allgemeinem C API
| Nach der Modellquantisierung | Python-Inferenzschnittstelle (rknn.inference()) | C-API-Inferenzschnittstelle (rknn.run()) (ohne pass_through und zero_copy) |
|---|---|---|
| Einschränkungen des Eingabetyps | Keine Einschränkungen. rknn.inference() erhält eine Liste von numpy-Arrays mit Datentypattribut. Die Eingabe wird automatisch in den vom RKNN-Modell benötigten Datentyp konvertiert. |
Keine Einschränkungen. rknn_tensor_type in rknn_inputs kann entsprechend der tatsächlichen Eingabe RKNN_TENSOR_FLOAT32, RKNN_TENSOR_FLOAT16, RKNN_TENSOR_INT8, RKNN_TENSOR_UIN8 oder RKNN_TENSOR_INT16 festlegen. Danach wird die Eingabe automatisch in den vom RKNN-Modell benötigten Datentyp konvertiert. |
| Ändert sich der Ausgabedatentyp? | Unverändert. Unabhängig von der Quantisierung liefert die Python-Schnittstelle rknn.inference() immer float-Ausgaben. Ein anderer Datentyp kann nicht angegeben werden. |
Geändert. Im RKNPU2 C API kann das Attribut von rknn outputs auf want_float=1 gesetzt werden, um float zu erhalten. Nach der Quantisierung liefert want_float=0 den vom Modell definierten Typ. Bei i8-Quantisierung entstehen beispielsweise int8-Ausgaben. |
| Ändert sich das Eingabeformat (NCHW, NHWC)? | Unverändert. Unabhängig von der Quantisierung kann data_format in rknn.inference() je nach Bedarf auf nchw oder nhwc gesetzt werden. |
Geändert. Unabhängig von der Quantisierung kann rknn_tensor_format in der Struktur rknn inputs je nach Bedarf auf NCHW oder NHWC gesetzt werden. |
Gibt es einen Online-Vorkompilierungsmodus?
RKNN-Toolkit2 exportiert nur offline vorkompilierte Modelle und unterstützt keine online vorkompilierten Modelle wie RKNN-Toolkit1. Daher gibt es keine Modusauswahl zwischen Offline- und Online-Vorkompilierung.
Kann ein mit RKNN-Toolkit konvertiertes RKNN-Modell auf RK3566 verwendet werden?
Nein.
Mit RKNN-Toolkit konvertierte Modelle sind für RK1806 / RK1808 / RK3399Pro / RV1109 / RV1126 vorgesehen; RK3566 benötigt ein mit RKNN-Toolkit2 konvertiertes Modell. RKNN-Toolkit2-Modelle eignen sich für Plattformen wie RK2118/ RV1103B/ RV1103 / RV1106B / RV1106 / RV1126B / RK3562 / RK3566 / RK3568 / RK3576/ RK3588.
Anleitungen für RKNN-Toolkit finden Sie im Projekt: https://github.com/airockchip/rknn-toolkit
Anleitungen für RKNN-Toolkit2 finden Sie im Projekt: https://github.com/airockchip/rknn-toolkit2
10.4 Häufige Fragen zu Deep-Learning-Frameworks
10.4.1 Von RKNN-Toolkit2 unterstützte Deep-Learning-Frameworks und Versionen
Siehe Abschnitt 3.1.
10.4.2 Unterstützte Operatoren je Framework
RKNN-Toolkit2 unterstützt verschiedene Frameworks in unterschiedlichem Umfang. Details enthält das Dokument RKNNToolkit2_OP_Support unter folgendem Link:
https://github.com/airockchip/rknn-toolkit2/blob/master/doc/
10.4.3 Fragen zur Konvertierung von ONNX-Modellen
„Error parsing message“ beim Laden des Modells
Beispielsweise schlägt die Konvertierung des Modells examples/onnx/resnet50v2 mit folgender Meldung fehl:
E load_onnx: Catch exception when loading onnx model: /rknn_resnet_demo/resnet50v2.onnx!

E lod_onnx: Traceback (most recent call last):

E load_onnx: File "rknn/api/rknn_base.py", line 1094, in rknn.api.rknn_base.RKNNBase.load_onnx

E load_onnx: File "/usr/local/lib/python3.6/dist-packages/onnx/__init__.py", line 115, in load_model

……

E load_onnx: google.protobuf.message.DecoderError: Error parsing message
Möglicherweise ist resnet50v2.onnx beschädigt oder nicht vollständig heruntergeladen. Laden Sie das Modell erneut herunter und prüfen Sie den MD5-Wert, beispielsweise:
22ed6e6a8fb9192f0980acca0c941414 resnet50v2.onnx
Werden dynamische Eingabeformen unterstützt?
Eine ONNX-Eingabeform [-1, 3, -1, -1] bedeutet beispielsweise, dass batch, height und width nicht festgelegt sind. RKNN-Toolkit2 vor Version 1.5.2 unterstützt keine dynamischen Eingabeformen.
Ab Version 1.5.2 werden dynamische Eingabeformen über dynamic_input in rknn.config() unterstützt; Details siehe Abschnitt 5.4.
Fehler beim Festlegen eines eigenen Ausgabeknotens
Beispielsweise erzeugt rknn.load_onnx() mit gesetztem outputs-Parameter folgenden Fehler:
E load_onnx: the '378' in outputs=['378', '439', '500'] is invalied!
Das Protokoll meldet, dass Ausgabeknoten 378 ungültig ist. outputs muss auf den korrekten Namen des Ausgabeknotens gesetzt werden.
10.4.4 Fragen zur Konvertierung von Pytorch-Modellen
Fehler beim Laden eines Pytorch-Modells: torch._C besitzt kein Attribut _jit_pass_inline
Fehlerprotokoll:
'torch._C' has no attribute '_jit_pass_inline'
Aktualisieren Sie PyTorch auf 1.6.0 oder neuer.
Speicherformat von Pytorch-Modellen
Derzeit werden nur mit torch.jit.trace() exportierte Modelle unterstützt. torch.save() speichert lediglich das Wörterbuch der Gewichtsparameter ohne Netzwerkstruktur. Es lässt sich deshalb nicht regulär importieren und in ein RKNN-Modell konvertieren.
PytorchStreamReader-Fehler bei der Konvertierung
Fehlerprotokoll:
E Catch exception when loading pytorch model: ./mobilenet0.25_Final.pth!

E Traceback (most recent call last):

……

E cpp_module = torch._C.import_ir_module(cu, f, map_location, extra_files)

E RuntimeError: [enforce fail at inline container.cc:137]. PytorchStreamReader failed reading zip archive: faild
finding central directory frame #0 ……
Ursache ist, dass das PyTorch-Modell keine Informationen zur Netzwerkstruktur enthält.
Eine .pth-Datei enthält meist nur Gewichte. Initialisieren Sie zum Export mit Netzwerkstruktur das entsprechende Netzwerk und laden Sie die .pth-Gewichte mit net.load_state_dict(). Erfassen Sie Struktur und Gewichte anschließend mit torch.jit.trace(). Speichern Sie das aufgezeichnete Modell mittels torch.jit.save() als .pt; rknn.load_pytorch() kann es dann in RKNN konvertieren.
KeyError bei der Konvertierung
Fehlerprotokoll:
E Traceback (most recent call last):

……

E KeyError: 'aten::softmax'
Eine Meldung wie KeyError: ‘aten::xxx’ bedeutet, dass die aktuelle Version diesen Operator nicht unterstützt. Solche Fehler werden mit RKNN-Toolkit2-Updates behoben; verwenden Sie die neueste Version.
„Syntax error in input! LexToken(xxx)“ bei der Konvertierung
Fehlerprotokoll:
WARNING: Token 'COMMENT' defined, but not used

WARNING: There is 1 unused token

!!!!! Illegal character '"'

Syntax error in input! LexToken(NAMED_IDENTIFIER, 'fc', 1, 27)

!!!!! Illegal character '"'
Dieser Fehler kann mehrere Ursachen haben. Prüfen Sie in folgender Reihenfolge:
1) Das Netzwerk wurde nicht von torch.nn.module abgeleitet. Erstellen Sie es durch Ableitung von torch.nn.module und erzeugen Sie danach die pt-Datei mit torch.jit.trace().
2) Aktualisieren Sie RKNN-Toolkit2 auf 1.4.0 oder neuer. Empfohlene torch-Versionen sind 1.6.0, 1.9.0, 1.10.0 oder 1.13.1.
10.4.5 Fragen zur Konvertierung von Tensorflow-Modellen
Fehler mit einem Tensorflow1.x-Modell
Beim Laden eines tensorflow1.x-Modells über rknn.load_tensorflow() erscheint folgende Meldung:
E load_tensorflow: Catch exception when loading tensorflow model: ./yolov3_mobilenetv2.pb!

E load_tensorflow: Traceback (most recent call last):

……

E load_tensorflow: tensorflow.python.framework.errors_impl.InvalidArgumentError: Node
'MobilenetV2/expanded_conv/depthwise/BatchNorm/cond/Switch_1' expects to be colocated with unknown node
'MobilenetV2/expanded_conv/depthwise/BatchNorm/moving_mean'

E load_tensorflow: During handling of the above exception, another exception occurred:

E load_tensorflow: Traceback (most recent call last):

E load_tensorflow: File "rknn/api/rknn_base.py", line 990, in rknn.api.rknn_base.RKNNBase.load_tensorflow

……

E load_tensorflow: return func(*args, **kwargs)

E load_tensorflow: File "/usr/local/lib/python3.6/dist-packages/tensorflow/python/framework/importer.py", line
431, in import_graph_def

E load_tensorflow: raise ValueError(str(e))

E load_tensorflow: ValueError: Node 'MobilenetV2/expanded_conv/depthwise/BatchNorm/cond/Switch_1' expects
to be colocated with unknown node 'MobilenetV2/expanded_conv/depthwise/BatchNorm/moving_mean'
Empfehlungen:
Wenn TensorFlow 1.x installiert ist, aktualisieren Sie auf TensorFlow 2.x.
Aktualisieren Sie RKNN-Toolkit2/RKNPU2 auf die neueste Version.
TransformGraph-Fehler
Fehlerprotokoll:
Traceback (most recent call last):

File "test.py", line 80, in <module>

input_size_list=[[1, 368, 368, 3]])

File "/usr/local/lib/python3.6/site-packages/rknn/api/rknn.py", line 68, in load_tensorflow

input_size_list=input_size_list, outputs=outputs)

File "rknn/api/rknn_base.py", line 940, in rknn.api.rknn_base.RKNNBase.load_tensorflow
File "/usr/local/lib/python3.6/dist-packages/tensorflow/tools/graph_transforms/__init__", line 51, in
TransformGraph.transforms_string, status)

File "/usr/local/lib/python3.6/dist-packages/tensorflow/python/framework/errors_impl.py". ;ome 548, in __exit__

C_api.TF_GetCode(self.status.status)

Tensorflow.python.framework.error_impl.InvalidArgumentError: Beta input to batch norm has bad shape: [24]
Ursachen:
1) RKNN-Toolkit2 ruft zur Modelloptimierung die native TensorFlow-Funktion TransformGraph auf, die jedoch fehlschlägt.
2) Möglicherweise ist die beim Export verwendete TensorFlow-Version nicht mit der installierten Version kompatibel.
Empfehlungen:
Exportieren Sie das Modell mit TensorFlow 1.14.0 oder suchen Sie ein gleichartiges Modell in einem anderen Deep-Learning-Framework.
Fehler „Shape must be rank 4 but is rank 0“
Beim Laden des pb-Modells mit folgendem Befehl:
  rknn.load_tensorflow(tf_pb='./model.pb',

  inputs=["X","Y"],

  outputs=['generator/xs'],

  input_size_list=1, INPUT_SIZE, INPUT_SIZE, 3)
Folgender Fehler tritt auf:
  E load_tensorflow: Catch exception when loading tensorflow model: ./model.pb!

  E load_tensorflow: Traceback (most recent call last):

  E load_tensorflow: File "/usr/local/lib/python3.6/dist-packages/tensorflow/python/framework/importer.py", line
427, in import_graph_def

  E load_tensorflow: graph._c_graph, serialized, options) # pylint: disable=protected-access

  E load_tensorflow: tensorflow.python.framework.errors_impl.InvalidArgumentError: Shape must be rank 4 but is
rank 0 for 'generator/conv2d_3/Conv2D' (op: 'Conv2D') with input shapes: [], [7,7,3,32].
Möglicherweise besitzt das Modell mehrere Eingaben und input_size_list von rknn.load_tensorflow() wurde nicht gemäß Vorgabe ausgefüllt. Siehe folgendes Beispiel in examples/functions/multi_input_test:
  rknn.load_tensorflow(tf_pb='./conv_128.pb',

  inputs=['input1', 'input2', 'input3', 'input4'],

  outputs=['output'],

  input_size_list=[[1, 128, 128, 3], [1, 128, 128, 3],

  [1, 128, 128, 3], [1, 128, 128, 1]])
Fehlersuche beim Laden von Modellen
Prüfen Sie zunächst, ob das ursprüngliche Framework das Modell korrekt laden und aufrufen kann.
Aktualisieren Sie anschließend RKNN-Toolkit2 auf die neueste Version. Nicht unterstützte Schichten oder Operatoren sollten im Debug-Protokoll erscheinen. Aktivieren Sie bei Bedarf mit RKNN(verbose=True) ausführlichere Konvertierungsprotokolle.
Bleibt das Problem bestehen, übermitteln Sie die RKNN-Toolkit2-Version und das ausführliche Fehlerprotokoll an das Rockchip-NPU-Entwicklungsteam.
10.5 Probleme bei der Modellquantisierung
Auswirkung der Quantisierung auf die Modellgröße
Es gibt zwei Fälle. Bei einem importierten quantisierten Modell verwendet do_quantization=False in rknn.build() dessen Quantisierungsparameter. Bei einem Gleitkommamodell erfolgt keine Quantisierung, die Gewichte werden jedoch nahezu ohne Genauigkeitsverlust von float32 in float16 umgewandelt. Beide Fälle reduzieren die Modellgröße und damit den Speicherbedarf.
Müssen Quantisierungsbilder dieselbe Größe wie die Modelleingabe haben?
Nicht erforderlich.
RKNN-Toolkit2 passt die Bildgröße automatisch an. Dies kann jedoch Bildinformationen verändern und die Quantisierungsgenauigkeit beeinflussen. Bilder in der passenden Eingabegröße sind daher vorzuziehen.
Bei Kalibrierungsdaten in einem Nicht-Bildformat, etwa npy, muss die Form mit der Modelleingabe übereinstimmen.
Müssen Kalibrierungsdaten an rknn_batch_size angepasst werden?
Nicht erforderlich.
rknn_batch_size in rknn.build() ändert nur die batch-Dimension des endgültig exportierten RKNN-Modells von 1 auf rknn_batch_size und beeinflusst die Quantisierung nicht. Kalibrierungsdaten werden daher wie für ein Modell ohne Batch-Verarbeitung vorbereitet.
Konvertierungsprogramm hängt oder wird während der Quantisierung beendet
Während der Modellquantisierung reserviert RKNN-Toolkit2 Bereiche des Systemspeichers. Dadurch kann das Programm hängen oder vom System beendet werden.
Lösung: Vergrößern Sie den Arbeitsspeicher oder den virtuellen Speicher (Swap-Partition).
10.6 Probleme bei der Modellkonvertierung
Häufige Konvertierungsfehler
Konvertierungsfehler wie die folgenden sind wahrscheinlich auf einen Fehler der aktuellen Version zurückzuführen. Versuchen Sie ein Update auf die neueste RKNN-Toolkit2-Version.
Fehler im Zusammenhang mit infer_shapes
  (op_type:Mul, name:Where_2466_mul): Inferred elem type differs from existing elem type: (FLOAT) vs
(INT64)

  E build: Catch exception when building RKNN model!

  E build: Traceback (most recent call last):

  E build: File "rknn/api/rknn_base.py", line 1555, in rknn.api.rknn_base.RKNNBase.build

  E build: File "rknn/api/graph_optimizer.py", line 5409, in rknn.api.graph_optimizer.GraphOptimizer.run

  E build: File "rknn/api/graph_optimizer.py", line 5123, in
rknn.api.graph_optimizer.GraphOptimizer._fuse_ops

  E build: File "rknn/api/ir_graph.py", line 180, in rknn.api.ir_graph.IRGraph.rebuild

  E build: File "rknn/api/ir_graph.py", line 140, in rknn.api.ir_graph.IRGraph._clean_model

  E build: File "rknn/api/ir_graph.py", line 56, in rknn.api.ir_graph.IRGraph.infer_shapes

  E build: File "/home/anaconda3/envs/rk2/lib/python3.6/site-packages/onnx/shape_inference.py", line 35, in
infer_shapes

  E build: inferred_model_str = C.infer_shapes(model_str, check_type)

  E build: RuntimeError: Inferred elem type differs from existing elem type: (FLOAT) vs (INT64)
oder:
  E build: Traceback (most recent call last):

  E build: File "rknn/api/rknn_base.py", line 1643, in rknn.api.rknn_base.RKNNBase.build

  E build: File "rknn/api/graph_optimizer.py", line 6256, in
rknn.api.graph_optimizer.GraphOptimizer.fuse_ops

  E build: File "rknn/api/ir_graph.py", line 285, in rknn.api.ir_graph.IRGraph.rebuild

  E build: File "rknn/api/ir_graph.py", line 149, in rknn.api.ir_graph.IRGraph._clean_model

  E build: File "rknn/api/ir_graph.py", line 62, in rknn.api.ir_graph.IRGraph.infer_shapes

  E build: File "/usr/local/lib/python3.6/dist-packages/onnx/shape_inference.py", line 35, in infer_shapes

  E build: inferred_model_str = C.infer_shapes(model_str, check_type)
  E build: RuntimeError: Inferred shape and existing shape differ in rank: (0) vs (3)
oder:
  (op_type:ReduceMax, name:ReduceMax_18): Interred shape and existing shape differ in rank: (3) vs (0)

  E build: Catch exception when building RKNN model!

  E build: Traceback (most recent call last):

  ……

  E build: RuntimeError: Interred shape and existing shape differ in rank: (3) vs (0)
Fehler im Zusammenhang mit _p_fuse_two_mul
  E build: Catch exception when building RKNN model!

  E build: Traceback (most recent call last):

  E build: File "rknn/api/rknn_base.py", line 1643, in rknn.api.rknn_base.RKNNBase.build

  E build: File "rknn/api/graph_optimizer.py", line 6197, in
rknn.api.graph_optimizer.GraphOptimizer.fuse_ops

  E build: File "rknn/api/graph_optimizer.py", line 204, in rknn.api.graph_optimizer._p_fuse_two_mul

  E build: ValueError: non-broadcastable output operand with shape () doesn't match the broadcast shape
(3,2)
Fehler wie „Segmentation fault“
Beispielsweise ein Konvertierungsfehler beim picodet-Modell:
 I _fold_constant remove nodes = ['Shape_0', 'Gather_4', 'Shape_1', 'Gather_6', 'Unsqueeze_0',
'Concat_8', 'Cast_3']

Segmentation fault (Core dumped)
Fehler im Zusammenhang mit _p_fuse_mul_into_conv
E build: Catch exception when building RKNN model:

……
E build: ValueError: non broadcastable output operand whith shape (1,258,1,256) doesn`t match the
broadcast shape (80256,258,1,256)
Feststellen, ob ein Operator in RKNN unterstützt wird
Konvertieren Sie das Modell direkt. Bei einem nicht unterstützten Operator erscheint eine entsprechende Meldung.
Sie können auch die folgenden beiden Dokumente zur Operatorunterstützung heranziehen:
doc/RKNNToolKit2_OP_Support-x.x.x.md im RKNN-Toolkit2-Paket enthält eine grobe Unterstützungsliste für jedes Framework.
doc/RKNN_Compiler_Support_Operator_List_vx.x.x.pdf im RKNPU2-Paket enthält detaillierte RKNN-Operatorspezifikationen.
Meldung, dass ‘expand’ nicht unterstützt wird
Empfehlungen:
1. Die neue Version unterstützt ‘Expand’ bereits auf der CPU. Versuchen Sie ein Update von RKNN-Toolkit2 / RKNPU2 auf die neueste Version.
2. Ändern Sie das Modell und verwenden Sie ‘Repeat’ statt ‘Expand’.
Meldung „Meet unsupported dims in reducesum“
Bei der Konvertierung erscheint „Meet unsupported dims in reducesum, dims: 6“, wie nachfolgend gezeigt:
D RKNN: [14:54:19.434] >>>>>> start: N4rknn17RKNNInitCastConstE

D RKNN: [14:54:19.434] <<<<<<<< end: N4rknn17RKNNInitCastConstE

D RKNN: [14:54:19.434] >>>>>> start: N4rknn20RKNNMultiSurfacePassE

D RKNN: [14:54:19.434] <<<<<<<< end: N4rknn20RKNNMultiSurfacePassE

D RKNN: [14:54:19.434] >>>>>> start: N4rknn14RKNNTilingPassE

D RKNN: [14:54:19.434] <<<<<<<< end: N4rknn14RKNNTilingPassE

D RKNN: [14:54:19.434] >>>>>> start: N4rknn23RKNNProfileAnalysisPassE

D RKNN: [14:54:19.434] <<<<<<<< end: N4rknn23RKNNProfileAnalysisPassE

D RKNN: [14:54:19.434] >>>>>> start: OpEmit

E RKNN: [14:54:19.438] Meet unsupported dims in reducesum, dims: 6

Aborted (core dumped)
Derzeit unterstützt RKNN keine 6-dimensionalen Operatoren. Meist werden nur 4 Dimensionen unterstützt; für andere Dimensionen gelten Einschränkungen.
Konvertierungsfehler durch NonMaxSuppression
Nachverarbeitungsoperatoren wie NonMaxSuppression werden derzeit von RKNN nicht unterstützt.
Der Teilgraph für die Nachverarbeitung kann entfernt werden, beispielsweise:
rknn.load_onnx(model='picodet_xxx.onnx', outputs=['concat_4.tmp_0', 'tmp_16'])
Die entfernten Teilgraphen werden separat auf der CPU verarbeitet.
Fehler wie „invalid expand shape“
Beispielsweise tritt beim Konvertieren von rvm_mobilenetv3_fp32.onnx folgender Fehler auf:
[E:onnxruntime:, sequential_executor.cc:333 Execute] Non-zero status code returned while running Expand node.
Name:'Expand_294' Status Message: invalid expand shape

E build: Catch exception when building RKNN model!
E build: Traceback (most recent call last):

E build: File "rknn/api/rknn_base.py", line 1638, in rknn.api.rknn_base.RKNNBase.build

E build: File "rknn/api/graph_optimizer.py", line 5529, in rknn.api.graph_optimizer.GraphOptimizer.fold_constant

E build: File "rknn/api/session.py", line 69, in rknn.api.session.Session.run

E build: File "/home/cx/work/tools/Anaconda3/envs/rknn/lib/python3.8/site-packages/onnxruntime/capi/onnxruntime_inference_collection.py", line 124, in run

E build: return self._sess.run(output_names, input_feed, run_options)

E build: onnxruntime.capi.onnxruntime_pybind11_state.InvalidArgument: [ONNXRuntimeError] : 2 :
INVALID_ARGUMENT : Non-zero status code returned while running Expand node. Name:'Expand_294' Status
Message: invalid expand shape
Da der Eingabewert downsample_ratio die Größe interner Merkmale ändert, handelt es sich im Wesentlichen um einen dynamischen Graphen. Ändern Sie die downsample_ratio-Logik so, dass Eingabewerte nicht die Form interner Merkmale steuern. Wird ein dynamischer Graph benötigt, kann nach einem Update auf RKNN-Toolkit2 1.5.2 dynamic_shape zur Simulation verwendet werden. Auch dabei muss die downsample_ratio-Logik geändert werden, sodass Eingabewerte keine internen Formen steuern. Derzeit unterstützt dynamic_shape nur variable Eingabeformen.
Fehler mit mean_values in rknn.config()
mean/std sind wie folgt eingestellt:
rknn.config(mean_values=[128, 128, 128], std_values=[128, 128, 128])
Folgender Fehler wird gemeldet:
--> Loading model

transpose_input for input_1: shape must be rank 4, ignored

E load_tflite: The len of mean_values ([128, 128, 128]) for input 0 is wrong, expect 32!
Möglicherweise besteht die Modelleingabe nicht aus 3-kanaligen Bilddaten, etwa bei einer Form von 1x32. In diesem Fall:
Setzen Sie mean_values / std_values entsprechend der Anzahl der Eingabekanäle.
Benötigt das Modell keine mean/std-Werte, können mean_values / std_values in rknn.config entfallen. mean/std sind im Allgemeinen nur für Bildeingaben relevant.
Fehler bei mehr als 4 Dimensionen (5 oder 6)
Enthält das Modell Operatoren mit mehr als 4 Dimensionen, etwa 5 oder 6, wird folgender Fehler gemeldet:
E build: Catch exception when building RKNN model!

E build: Traceback (most recent call last):

E build: File "rknn/api/rknn_base.py", line 1580, in rknn.api.rknn_base.RKNNBase.build

E build: File "rknn/api/rknn_base.py", line 341, in rknn.api.rknn_base.RKNNBase._generate_rknn

E build: File "rknn/api/rknn_base.py", line 307, in rknn.api.rknn_base.RKNNBase._biild_rknn

E build: IndexError: vector::_M_range_check: __n (which is 4) >= this->size() (which is 4)
RKNN unterstützt derzeit keine Operatoren mit mehr als 4 Dimensionen; diese Knoten können manuell entfernt werden.
Unterstützt RKNN dynamische Faltung?
Derzeit unterstützen RK3588/RK3576/RV1126B dynamische Faltung mit group=1. Andere Plattformen werden noch nicht unterstützt.
Fehler „Not support input data type ‘float16’“
Die Gewichte des mit Pytorch trainierten Modells haben den Typ float16. Bei der Konvertierung in RKNN tritt folgender Fehler auf:
--> Building model

E build: Not support input data type 'float16'

W build: ==================== WARN(3) =================

E rknn-toolkit2 version: 1.3.0-11912b58

E build: Catch exception when building RKNN model!

E build: Traceback (most recent call last):

E build: File "rknn/api/rknn_base.py", line 1638, in rknn.api.rknn_base.RKNNBase.build

E build: File "rknn/api/graph_optimizer.py", line 5524, in rknn.api.graph_optimizer.GraphOptimzer.fold_constant

E build: File "rknn/api/load_checker.py", line 63, in rknn.api.load_checker.create_random_data

E build: File "rknn/api/rknn_log.py", line 113, in rknn.api.rknn_log.RKNNLog.e

E build: ValueError: Not support input data type 'float16'!
RKNN-Toolkit2 unterstützt derzeit keine Pytorch-Modelle mit float16-Gewichten. Diese müssen in float32 umgewandelt werden.
Fehler im Zusammenhang mit dynamischen Graphen
Wenn bei der Modellkonvertierung ein Fehler wie der folgende auftritt:
E build: ValueError: The Op of 'NonZero' is not support! it will cause the graph to be a dynamic graph!
Dies bedeutet, dass der Operator einen dynamischen Graphen erzeugt. Ändern Sie das Modell manuell, ersetzen Sie den Operator oder entfernen Sie ihn.
Größe des RKNN-Modells
Das konvertierte RKNN-Modell kann größer als das Original sein; die Größe kann sogar von der Eingabeform abhängen. Das ist normal: Neben Gewichten und Graphstruktur enthält RKNN umfangreiche NPU-Registerkonfigurationen. Zur Laufzeitoptimierung können außerdem Operatoren zerlegt und weitere Verarbeitungsschritte durchgeführt werden, die das Modell vergrößern.
10.7 Inferenz im Simulator oder auf dem Gerät
Begriffserklärung
Simulator-Inferenz: RKNN-Toolkit2 stellt unter Linux x86_64 einen Simulator bereit, der Modellinferenz ohne Entwicklungsboard ermöglicht. Die Ergebnisse können vom Board abweichen; Inferenz über ein verbundenes Board oder direkt darauf wird bevorzugt.
Inferenz mit verbundenem Board: Das Board ist mit dem PC verbunden; Modellinferenz und Ergebnisabruf erfolgen über die RKNN-Toolkit2 Python API.
Inferenz direkt auf dem Board: Die Ergebnisse werden über das RKNPU2 C API ermittelt.
Simulator-Ergebnisse weichen vom verbundenen Board ab
Dies kann bedeuten, dass die Ergebnisse auf dem Board falsch sind.
Wegen Unterschieden in Hardware und Treibern sind identische Ergebnisse nicht garantiert. Große Abweichungen deuten jedoch wahrscheinlich auf einen Fehler im Boardtreiber hin. Melden Sie das Problem dem RK-NPU-Team zur Analyse und Fehlersuche.
Funktionsweise der Inferenz mit verbundenem Board
RKNN-Toolkit2 kommuniziert mit rknn_server auf dem Board. Modell und Eingabedaten werden vom PC übertragen; anschließend führt RKNPU2 C API die Inferenz auf dem Board aus. Nach Abschluss werden die Ergebnisse an den PC zurückgesendet.
Unterschiede zwischen Inferenz über ein verbundenes Board und direkt auf dem Board
Inferenz mit verbundenem Board basiert auf RKNPU2 C API. Theoretisch sollten die Ergebnisse daher übereinstimmen. Prüfen Sie bei großen Abweichungen Vorverarbeitung, Datentyp und Datenanordnung (NCHW, NHWC).
Sehr kleine Abweichungen sind normal. Sie können etwa durch unterschiedliche Bibliotheken zum Lesen von Bildern oder zur Datentypkonvertierung entstehen.
Direkte Board-Inferenz ist schneller als Inferenz über ein verbundenes Board
Inferenz mit verbundenem Board benötigt zusätzliche Datenkopien und Übertragungen und ist daher langsamer als die direkte Ausführung mit RKNPU2 C API. Maßgeblich für die tatsächliche NPU-Leistung ist deshalb die direkte Board-Inferenz mit RKNPU2 C API.
Ausführlichere Protokolle erhalten
Bei Inferenz mit verbundenem Board finden Modellinitialisierung und Inferenz überwiegend auf dem Entwicklungsboard statt. Auch die meisten Protokolle entstehen dort.
Melden Sie sich für detaillierte Board-Debug-Informationen über die serielle Schnittstelle am Betriebssystem an. Führen Sie die folgenden zwei Befehle zum Setzen der Protokollierungsvariablen aus. Lassen Sie das serielle Fenster geöffnet und starten Sie die Inferenz mit verbundenem Board. Board-Fehlermeldungen erscheinen dann in diesem Fenster:
export RKNN_LOG_LEVEL=5

restart_rknn.sh
Datenlayout für Batch-Inferenz
Das Eingabelayout von rknn.inference kann über 1data_format=’NCHW’ oder data_format=’NHWC’ als NCHW beziehungsweise NHWC festgelegt werden. Standard ist NHWC.
In rknn-toolkit2 verwenden ONNX-Modelle mit 4D-Eingaben bei der Konvertierung normalerweise NCHW. Bei RKNN-Inferenz ist das Standardlayout jedoch NHWC, und das Toolkit konvertiert intern NCHW zu NHWC. Wird data_format=’NCHW’ ausdrücklich gesetzt, entfällt diese Standardkonvertierung und die Eingabe wird unverändert als NCHW verwendet. Beispiele enthält die GitHub-Diskussion: https://github.com/airockchip/rknn-toolkit2/issues/220.
10.8 Häufige Probleme bei der Modellbewertung
Quantisierungsgenauigkeit schlechter als erwartet
Siehe Kapitel 7 dieses Dokuments.
Welche Frameworks für quantisierte Modelle werden unterstützt?
RKNN-Toolkit2 1.4 und neuer unterstützt quantisierte Modelle aus TensorFlow, TensorFlow Lite und PyTorch.
Verbindung zum Gerät bei Inferenz mit verbundenem Board fehlgeschlagen
Bei rknn.accuracy_analysis tritt folgender Fehler auf:
  E accuracy_analysis: Connect to Device Failure (-1)

  E accuracy_analysis: Catch exception when init runtime!

  E accuracy_analysis: Traceback (most recent call last):

  E accuracy_analysis: File "rknn/api/rknn_base.py", line 2001, in rknn.api.rknn_base.RKNNBase.init_runtime

  E accuracy_analysis: File "rknn/api/rknn_runtime.py", line 194, in
rknn.api.rknn_runtime.RKNNRuntime.__init__

  E accuracy_analysis: File "rknn/api/rknn_platform.py", line 331, in rknn.api.rknn_platform.start_ntp_or_adb
Oder bei rknn.inference tritt folgender Fehler auf:
  I target set by user is: rk3568

  I Starting ntp or adb, target is RK3568

  I Device [0c6a9900ef4871e1] not found in ntb device list.

  I Start adb…
  I Connect to Device success!

  I NPUTransfer: Starting NPU Transfer Client, Transfer version 2.1.0 (b5861e7@2020-11-23T11:50:36)

  D NPUTransfer: Transfer spec = local:transfer_proxy

  D NPUTransfer: ERROR: socket read fd = 3, n = -1: Connection reset by peer

  D NPUTransfer: Transfer client closed fd = 3

  E RKNNAPI: rknn_init, server connect fail! ret = -9(ERROR_PIPE)!

  E init_runtime: Catch exception when init_runtime!

  E init_runtime: Traceback (most recent call last):

  E init_runtime: File "rknn/api/rknn_base.py", line 2001, in rknn.api.rknn_base.RKNNBase.init_runtime

  E init_runtime: File "rknn/api/rknn_runtime.py", line 361, in rknn.api.rknn_runtime.RKNNRuntime.build_graph

  E init_runtime: Exception: RKNN init failed. error code: RKNN_ERR_DEVICE_UNAVAILABLE
Möglicherweise läuft rknn_server auf dem Board nicht. Starten Sie den Dienst gemäß Abschnitt 2.2.
rknn_init liefert RKNN_ERROR_MODEL_INVALID
Fehlerprotokoll:
E RKNNAPI: rknn_init, msg_load_ack fail, ack = 1(ACK_FAIL), expect 0(ACK_SUCC)!

D NPUTransfer: Transfer client closed, fd = 4

E init_runtime: Catch exception when init runtime!

E init_runtime: Traceback (most recent call last):

E init_runtime: File "rknn/api/rknn_base.py", line 2011, in rknn.api.rknn_base.RKNNBase.init_runtime

E init_runtime: File "rknn/api/rknn_runtime.py", line 361, in rknn.api.rknn_runtime.RKNNRuntime.build_graph

E init_runtime: Exception: RKNN init failed. error code: RKNN_ERR_MODEL_INVALID
Dieser Fehler tritt üblicherweise in folgenden Fällen auf:
Bei der Erzeugung eines rknn-Modells müssen RKNN-Toolkit2- und Treiberversionen zueinander passen. Aktualisieren Sie RKNN-Toolkit2 / RKNPU2 und die Boardfirmware auf die neuesten Versionen.
target_platform ist falsch gesetzt. Ohne target_platform in rknn.config() läuft das Modell nur auf RK3566/RK3568. Für andere Plattformen wie RK3588/RK3588S/RV1103/RV1106/RK3562 muss beim Aufruf von rknn.config() der passende target_platform angegeben werden.
Tritt der Fehler im Docker-Container auf, ist möglicherweise npu_transfer_proxy auf dem Host nicht beendet worden und stört die Kommunikation. Verlassen Sie den Container, beenden Sie npu_transfer_proxy auf dem Host und starten Sie danach das Inferenzskript erneut im Container.
Möglicherweise liegt ein Problem mit dem RKNN-Modell vor. Verbinden Sie sich seriell mit dem Board, setzen Sie RKNN_LOG_LEVEL=5 und führen Sie restart_rknn.sh aus. Starten Sie anschließend das Programm, erfassen Sie das ausführliche Protokoll und senden Sie es an das Rockchip-NPU-Team.
rknn_init liefert RKNN_ERR_DEVICE_UNAVAILABLE
Fehlerprotokoll:
E RKNNAPI: rknn_init, msg_ioctl_ack fail, data_len = 104985, except 102961!

D NPUTransfer: Transfer client closed, fd = 3

E init_runtime: Catch exception when init_runtime!

E init_runtime: Traceback (most recent call last):

E init_runtime: File "rknn/api/rknn_base.py", line 1961, in rknn.api.rknn_base.RKNNBase.init_runtime

E init_runtime: File "rknn/api/rknn_runtime.py", line 360, in rknn.api.rknn_runtime.RKNNRuntime.build_graph

E init_runtime: Exception: RKNN init failed. error code: RKNN_ERR_DEVICE_UNAVAILABLE
Prüfen Sie Folgendes:
Stellen Sie sicher, dass RKNN-Toolkit2 / RKNPU2 und die Gerätefirmware auf dem neuesten Stand sind. Die Abfrage der Komponentenversionen beschreibt Abschnitt 2.2.
Stellen Sie außerdem sicher, dass adb devices oder rknn.list_devices() das Gerät findet und target sowie device_id in rknn.init_runtime() korrekt sind.
Runtime-Fehler „Invalid RKNN model version 6“
  Loading model …

  E RKNN: [09:13:25.728] 6, 1

  E RKNN: [09:13:25.728] Invalid RKNN model version 6

  E RKNN: [06:28:39.049] rknn_init, load model failed!

  Exception: RKNN init failed. error code: RKNN_ERR_FAIL
Ursache:
Die Runtime-Version ist nicht mit den RKNN-Modellen kompatibel.
Empfehlung:
Aktualisieren Sie RKNN-Toolkit2 und Runtime auf dieselbe Version.
Runtime-Fehler „Invalid RKNN format“
In Runtime tritt folgender Fehler auf:
Loading model …

E RKNN: [06:28:39.048] parseRKNN from buffer: Invalid RKNN format!

E RKNN: [06:28:39.049] rknn_init, load model failed!

rknn_init error ret=-1
Ursachen:
1) target_platform wurde bei der Konvertierung falsch oder nicht gesetzt; ohne Angabe gilt rk3566.
2) Die Runtime-Version ist nicht mit RKNN-Toolkit2 kompatibel.
Empfehlungen:
1) Setzen Sie den korrekten target_platform.
2) Aktualisieren Sie RKNN-Toolkit2 und Runtime auf dieselbe Version.
rknn.inference ist langsamer als rknn.eval_perf
rknn.inference verwendet PC und adb für die Inferenz mit verbundenem Board. Dadurch entsteht ein fester Datenübertragungsaufwand, sodass die Geschwindigkeit von der theoretischen Bewertung durch rknn.eval_perf abweicht.
Für eine realistischere Bildrate wird empfohlen, RKNPU2 C API direkt auf dem Board zu testen.
Mehrere Batches mit rknn.inference()
Aktualisieren Sie RKNN-Toolkit2 auf 1.4.0 oder neuer und geben Sie beim Erstellen des RKNN-Modells die Anzahl der Eingabebilder an. Details enthält die Beschreibung von rknn.build in der RKNN-Toolkit2 API Reference.
Wenn rknn_batch_size größer als 1 ist, beispielsweise 4, muss außerdem der Python-Inferenzcode:
outputs = rknn.inference(inputs=[img])
wie folgt geändert werden:
img = np.expand_dims(img, 0)

img = np.concatenate((img, img, img, img), axis=0)

outputs = rknn.inference(inputs=[img])
Vollständiges Beispiel: examples/functions/multi_batch/
Mehrere RKNN-Modelle ausführen
Für zwei oder mehr Modelle müssen mehrere RKNN-Objekte erstellt werden. Jedes Objekt entspricht einem Modell und wirkt wie ein Kontext. Jedes Modell initialisiert sich, führt Inferenz aus und erhält Ergebnisse in seinem eigenen Kontext, ohne die anderen zu beeinflussen. Auf der NPU werden diese Modelle seriell ausgeführt.
Inferenz dauert sehr lange und liefert falsche Ergebnisse
Dauert die Inferenz länger als 20s und ist das Ergebnis falsch, handelt es sich meist um einen ‘NPU Hang’-Fehler. Versuchen Sie, RKNN-Toolkit2 / RKNPU2 auf die neueste Version zu aktualisieren.
Falsches Board-Ergebnis bei 3-dimensionaler Eingabe
Liefert der Simulator bei 3-dimensionaler Eingabe korrekte Ergebnisse, das verbundene Board jedoch nicht, kann dies an unvollständiger Unterstützung solcher Eingaben durch die aktuelle NPU liegen. Diese Unterstützung soll später verbessert werden.
Empfehlungen:
Ändern Sie die Modelleingabe auf 4D.
Versuchen Sie ein Update von RKNN-Toolkit2 / RKNPU2 auf die neueste Version.
Board-Ergebnisse sind falsch und bei jedem Lauf unterschiedlich
Wenn der Simulator korrekte und reproduzierbare Ergebnisse liefert, das verbundene Board jedoch falsche und wechselnde, kann ein Fehler im NPU-Kerneltreiber des Boards vorliegen. Aktualisieren Sie diesen zusammen mit RKNN-Toolkit2 / RKNPU2 auf die neuesten Versionen.
Genauigkeitsverlust bei vielen Resize-Operatoren
Enthält das ONNX-Modell viele Resize-Operatoren, kann die Genauigkeit nach der RKNN-Konvertierung sinken. Mögliche Ursachen:
1. Die NPU unterstützt Resize derzeit nicht auf Hardwareebene; dies ist für später vorgesehen. RKNN-Toolki2 konvertiert Reszie deshalb in ConvTranspose, was einen geringen Genauigkeitsverlust verursacht.
2. Mehrere hintereinandergeschaltete Resize-Operatoren können Fehler akkumulieren und die Genauigkeit stärker verringern.
Empfehlungen:
1. Vermeiden Sie Resize derzeit möglichst, beispielsweise durch Ersetzen mit ConvTranspose und anschließendes erneutes Training.
2. Ergänzen Sie optimization_level=2 in rknn.config. Resize läuft dann ohne Genauigkeitsverlust auf der CPU, allerdings mit geringerer Leistung.
Alle Inferenzergebnisse sind ‘nan’ bei do_quantization = False
Bei do_quantization=True in rknn.build sind die Ergebnisse unauffällig, bei False werden sie zu ‘nan’. Mögliche Ursache: Mit do_quantization=False arbeitet das RKNN-Modell in fp16, der Ausgabebereich einer Zwischenschicht wie einer Faltung kann aber den fp16-Bereich (65536) überschreiten, beispielsweise -51597~75642.
Empfehlung:
Stellen Sie beim Training sicher, dass Zwischenschichtausgaben den fp16-Bereich nicht überschreiten. Meist lässt sich dies durch eine zusätzliche BN-Schicht lösen.
Ergebnisse von QAT- und RKNN-Modell unterscheiden sich
Nach QAT-Training eines Klassifikators in Pytroch und Konvertierung in RKNN können sich die Pytorch- und RKNN-Inferenzergebnisse unterscheiden. Möglicherweise wurde für die Pytorch-Inferenz engine=’qnnpack’ nicht gesetzt; RKNN verhält sich eher wie qnnpack.
Speicherverbrauch während der Modellausführung ermitteln
Verwenden Sie rknn.eval_memory. Der Protokolleintrag ‘total’ gibt den gesamten belegten Speicher an.
Unterschied zwischen perf_debug=True und False
Bei perf_debug=True wird Debug-Code zum Erfassen der Schichtinformationen ergänzt; manche Parallelisierungsmechanismen können deaktiviert werden. Daher dauert die Ausführung länger als mit perf_debug=False.
perf_debug=True dient vor allem dazu, besonders zeitaufwendige Schichten zu erkennen und daraus eine Optimierung abzuleiten.
Nach einem Docker-Neustart hängt die Inferenz bei der Umgebungsinitialisierung
Beim Docker-Neustart wird npu_transfer_proxy nicht ordnungsgemäß beendet, sodass rknn_server auf dem Board die Trennung des Hosts nicht erkennt. Starten Sie das Board neu, um den Verbindungszustand von rknn_server zurückzusetzen.
10.9 Häufige Fragen zur Verwendung des C API
Gibt rknn_outputs_release() das Array rknn_output frei?
rknn_outputs_release() wird zusammen mit rknn_outputs_get() verwendet und gibt nur den Puffer im rknn_output-Array frei. Entsprechendes gilt für rknn_destroy_mem().
Wie erzeugt rknn_create_mem Speicher in passender Größe?
Für Eingaben gilt: Bei einem quantisierten RKNN-Modell reserviert rknn_create_mem() Speicher anhand von size_with_stride in rknn_tensor_attr, bei einem nicht quantisierten Modell anhand von n_bytes_type * n_elems.
Für Ausgaben reserviert rknn_create_mem() Speicher anhand von n_bytes_type * n_elems.
Wie werden die Eingabedaten gefüllt?
Beim allgemeinen API gilt für 4-dimensionale Eingaben fmt=NHWC, also die Reihenfolge [batch, height, width, channel]. Für Eingaben ungleich 4D gilt fmt=UNDEFINED; die Daten folgen der ursprünglichen Modellform.
Beim Zero-Copy-API kann fmt für 4D-Eingaben NHWC/NC1HWC2 sein. Zum Füllen bei fmt=NC1HWC2 siehe „RKNN Runtime Zero Copy“. Für Eingaben ungleich 4D gilt fmt=UNDEFINED; die Daten folgen der ursprünglichen Modellform.
Wie wird pass_through verwendet?
Das Eingabeformat wird mit RKNN_NATIVE_INPUT_ATTR über rknn_query() abgefragt. Bei einer 4-dimensionalen Form erfordern Kanalzahlen 1, 3 und 4 das Layout NHWC, andere Kanalzahlen NC1HWC2. Bei einer Form ungleich 4 Dimensionen wird UNDEFINED empfohlen.
Im pass_through-Modus wird dtype des Eingabe-Tensors bei quantisierten Modellen üblicherweise als INT8, bei nicht quantisierten als FLOAT16 angegeben.
Wie wird der Fehler „failed to submit“ behoben?
Tritt der Fehler in der ersten Faltungsschicht bei Zero-Copy auf, wurde möglicherweise zu wenig Speicher für den Eingabetensor reserviert. Verwenden Sie dafür size_with_stride aus den Tensorattributen.
Tritt der Fehler in einer mittleren NPU-Schicht auf, ist möglicherweise die Modellkonfiguration falsch. Im Fehlerprotokoll finden Sie einen Link zum neuesten SDK. Aktualisieren Sie die Werkzeugkette oder weisen Sie diese Schicht bei der RKNN-Konvertierung der CPU zu.
Wie wird „Meet unsupport xxx operator“ behoben?
Tritt dieser Fehler beim Demo auf dem Board auf, unterstützt dessen Runtime (librknnrt.so) den Operator meist nicht. Aktualisieren Sie zuerst die RKNN-Werkzeugkette, konvertieren Sie das Modell erneut und führen Sie das Demo nochmals aus.
Bleibt der Fehler mit der neuesten Werkzeugkette bestehen, muss der Operator selbst implementiert werden. Siehe Abschnitt 5.5 zu eigenen Operatoren; alternativ melden Sie das Problem dem RKNN-Team über redmine.
Unterstützen Modelle mit dynamischer Form extern reservierten Speicher bei Zero-Copy?
Versionen vor 1.6.0 unterstützen dies nicht. Spätere Versionen unterstützen die Kontextinitialisierung mit RKNN_FLAG_MEM_ALLOC_OUTSIDE.
Laufzeitbewertung eines benutzerdefinierten Operators
Setzen Sie RKNN_LOG_LEVEL=4 oder höher und starten Sie das C-API-Testdemo. Es gibt die Leistung jeder Schicht einschließlich des benutzerdefinierten Operators aus.
Hinweis: Die gemessene Zeit eines benutzerdefinierten Operators umfasst die Arbeiten im compute-Callback. Bei GPU-Operatoren zählen dazu beispielsweise clImportMemoryARM, Layout- und Datentypkonvertierungen für Ein- und Ausgaben sowie die eigentliche Ausführungszeit des OpenCL-GPU-Kernels.
11 Referenzen
RKNN: https://github.com/airockchip/rknn-toolkit2
RKNN_Model_Zoo: https://github.com/airockchip/rknn_model_zoo
RGA: https://github.com/airockchip/librga