
本文为 RKNN2 V2.5.0 对应平台的算子参考,供 ArmSoM 开发者选型与模型适配时查阅。不能据此认定所有 ArmSoM 板卡均支持这些算子;需按板卡 SoC、实际 Toolkit2、Runtime、NPU 驱动及 BSP 版本核对。原稿没有统一指定适用 Linux 内核,本文未进行 ArmSoM 硬件验证。
来源:本地中英文《RKNN2 算子支持与约束参考》V2.5.0。中文依中文稿;英俄德依英文稿。两稿分别为 374/384 页。各平台限制独立保留,不将一个平台的支持结论推广到另一个平台。英文稿 I/O 原图与输出表仍含中文,本文保留其来源并另附可编辑的本地化表格。ConvTranpose 等原稿拼写及 LSTM/GRU 原始公式保留;不要将本文公式视为 SDK 实现修正。
原稿页码: CN 368–374; EN 378–384.
算子参考系列目录
RKNN2 V2.5.0 · RK3566/RK3568:基础与卷积
RKNN2 V2.5.0 · RK3566/RK3568:循环网络、运算与池化
RKNN2 V2.5.0 · RK3566/RK3568:形状、切片与转置
RKNN2 V2.5.0 · RK3566/RK3568:激活、归一化与扩展算子
RKNN2 V2.5.0 · RK3588:循环网络、运算与池化
RKNN2 V2.5.0 · RK3588:形状、切片与转置
RKNN2 V2.5.0 · RK3588:激活、归一化与扩展算子
RKNN2 V2.5.0 · RK3562:循环网络、运算与池化
RKNN2 V2.5.0 · RK3562:形状、切片与转置
RKNN2 V2.5.0 · RK3562:激活、归一化与扩展算子
RKNN2 V2.5.0 · RV1103/RV1106:基础与卷积
RKNN2 V2.5.0 · RV1103/RV1106:循环网络、运算与池化
RKNN2 V2.5.0 · RV1103/RV1106:形状、切片与转置
RKNN2 V2.5.0 · RV1103/RV1106:激活、归一化与扩展算子
RKNN2 V2.5.0 · RK3576/RV1126B:基础与卷积
RKNN2 V2.5.0 · RK3576/RV1126B:循环网络、运算与池化
RKNN2 V2.5.0 · RK3576/RV1126B:形状、切片与转置
RKNN2 V2.5.0 · RK3576/RV1126B:激活、归一化与扩展算子
RKNN2 V2.5.0 · RK2118:循环网络、运算与池化
RKNN2 V2.5.0 · RK2118:形状、切片与转置
RKNN2 V2.5.0 · RK2118:激活、归一化与扩展算子
RKNN2 V2.5.0 · RV1103B/RV1106B:基础与卷积
RKNN2 V2.5.0 · RV1103B/RV1106B:循环网络、运算与池化
RKNN2 V2.5.0 · RV1103B/RV1106B:形状、切片与转置
RKNN2 V2.5.0 · RV1103B/RV1106B:激活、归一化与扩展算子
RKNN2 V2.5.0 · 模型输入输出、对齐与卷积限制
模型输入输出限制说明
模型输入限制说明
-
该对齐约束仅针对零拷贝 API,普通 API 无此对齐约束
-
输入宽的对齐要求可从零拷贝 API 中的 w_stride 属性查询到,注意: w_stride 不支持更改
-
仅对输入宽(width)在不同的通道(channel)条件下有对齐要求,其他无约束
-
若输入不需要 mean 和 scale,需要将 mean 和 scale 配置为 0 和 1
-
若通道(channel)>4,则 mean/scale 将统一使用第一个数值,即 mean[0]和 scale[0]
-
若首层为浮点类型则没有 quant 操作
-
RV1106/RV1103/RV1103B 不支持 CPU 的 mean/scale/quant 操作
-
详细的用法请参考《Rockchip_RKNPU_User_Guide_RKNN_SDK》
RK3566/RK3568
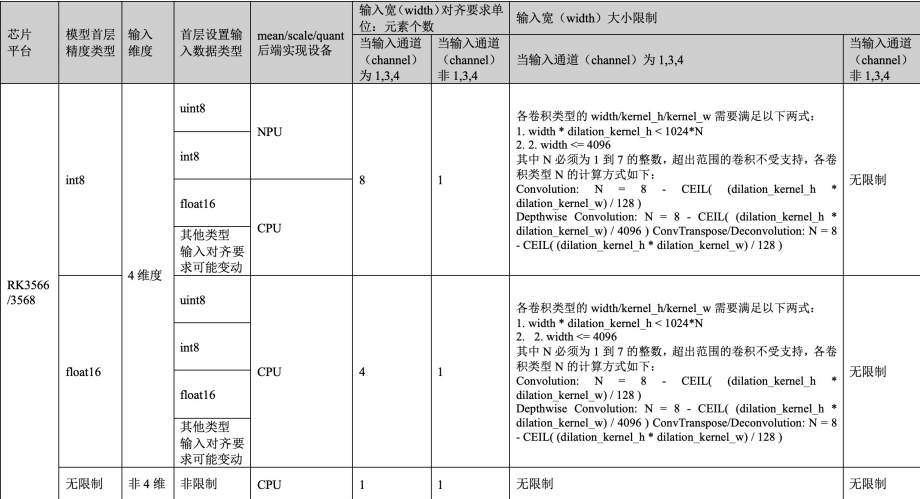
原图可编辑转录(合并单元格展开):
| 平台 | 模型首层精度 | 输入维度 | 首层设置输入数据类型 | mean/scale/quant 后端 | width 对齐(元素数),channel=1,3,4 | width 对齐(元素数),channel≠1,3,4 | width 限制,channel=1,3,4 | width 限制,channel≠1,3,4 |
|---|---|---|---|---|---|---|---|---|
| RK3566/RK3568 | int8 | 4 | uint8 | NPU | 8 | 1 | A | 无限制 |
| RK3566/RK3568 | int8 | 4 | int8 | NPU | 8 | 1 | A | 无限制 |
| RK3566/RK3568 | int8 | 4 | float16 | CPU | 8 | 1 | A | 无限制 |
| RK3566/RK3568 | int8 | 4 | 其他类型(输入对齐要求可能变动) | CPU | 8 | 1 | A | 无限制 |
| RK3566/RK3568 | float16 | 4 | uint8 | CPU | 4 | 1 | B | 无限制 |
| RK3566/RK3568 | float16 | 4 | int8 | CPU | 4 | 1 | B | 无限制 |
| RK3566/RK3568 | float16 | 4 | float16 | CPU | 4 | 1 | B | 无限制 |
| RK3566/RK3568 | float16 | 4 | 其他类型(输入对齐要求可能变动) | CPU | 4 | 1 | B | 无限制 |
| RK3566/RK3568 | 无限制 | 非 4 维 | 无限制 | CPU | 1 | 1 | 无限制 | 无限制 |
各卷积类型的 width/kernel_h/kernel_w 须满足下列两式。N 必须为 1 到 7 的整数,超出范围的卷积不受支持;N 的计算如下。图内 dilation_kernel_h/w 与末章 dilated_kernel_h/w 拼写不一致,保留原图写法。
| 条件 | 公式 |
|---|---|
| A (1) | width * dilation_kernel_h < 1024 * N |
| A (2) | width <= 4096 |
| A / Convolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 128) |
| A / Depthwise Convolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 4096) |
| A / ConvTranspose/Deconvolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 128) |
| 条件 | 公式 |
|---|---|
| B (1) | width * dilation_kernel_h < 1024 * N |
| B (2) | width <= 4096 |
| B / Convolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 128) |
| B / Depthwise Convolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 4096) |
| B / ConvTranspose/Deconvolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 128) |
RK3588
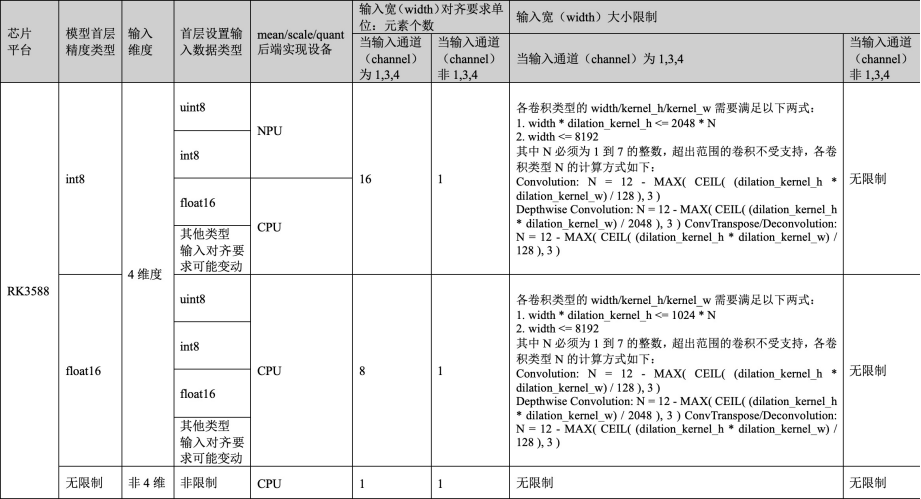
原图可编辑转录(合并单元格展开):
| 平台 | 模型首层精度 | 输入维度 | 首层设置输入数据类型 | mean/scale/quant 后端 | width 对齐(元素数),channel=1,3,4 | width 对齐(元素数),channel≠1,3,4 | width 限制,channel=1,3,4 | width 限制,channel≠1,3,4 |
|---|---|---|---|---|---|---|---|---|
| RK3588 | int8 | 4 | uint8 | NPU | 16 | 1 | A | 无限制 |
| RK3588 | int8 | 4 | int8 | NPU | 16 | 1 | A | 无限制 |
| RK3588 | int8 | 4 | float16 | CPU | 16 | 1 | A | 无限制 |
| RK3588 | int8 | 4 | 其他类型(输入对齐要求可能变动) | CPU | 16 | 1 | A | 无限制 |
| RK3588 | float16 | 4 | uint8 | CPU | 8 | 1 | B | 无限制 |
| RK3588 | float16 | 4 | int8 | CPU | 8 | 1 | B | 无限制 |
| RK3588 | float16 | 4 | float16 | CPU | 8 | 1 | B | 无限制 |
| RK3588 | float16 | 4 | 其他类型(输入对齐要求可能变动) | CPU | 8 | 1 | B | 无限制 |
| RK3588 | 无限制 | 非 4 维 | 无限制 | CPU | 1 | 1 | 无限制 | 无限制 |
各卷积类型的 width/kernel_h/kernel_w 须满足下列两式。N 必须为 1 到 7 的整数,超出范围的卷积不受支持;N 的计算如下。图内 dilation_kernel_h/w 与末章 dilated_kernel_h/w 拼写不一致,保留原图写法。
| 条件 | 公式 |
|---|---|
| A (1) | width * dilation_kernel_h <= 2048 * N |
| A (2) | width <= 8192 |
| A / Convolution | N = 12 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 3) |
| A / Depthwise Convolution | N = 12 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 2048), 3) |
| A / ConvTranspose/Deconvolution | N = 12 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 3) |
| 条件 | 公式 |
|---|---|
| B (1) | width * dilation_kernel_h <= 1024 * N |
| B (2) | width <= 8192 |
| B / Convolution | N = 12 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 3) |
| B / Depthwise Convolution | N = 12 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 2048), 3) |
| B / ConvTranspose/Deconvolution | N = 12 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 3) |
RV1103/RV1106
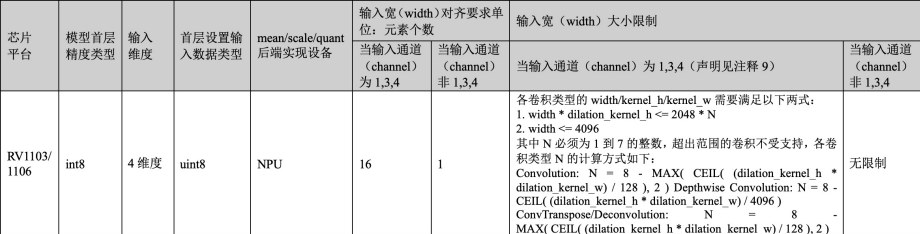
原图可编辑转录(合并单元格展开):
| 平台 | 模型首层精度 | 输入维度 | 首层设置输入数据类型 | mean/scale/quant 后端 | width 对齐(元素数),channel=1,3,4 | width 对齐(元素数),channel≠1,3,4 | width 限制,channel=1,3,4 | width 限制,channel≠1,3,4 |
|---|---|---|---|---|---|---|---|---|
| RV1103/RV1106 | int8 | 4 | uint8 | NPU | 16 | 1 | A | 无限制 |
各卷积类型的 width/kernel_h/kernel_w 须满足下列两式。N 必须为 1 到 7 的整数,超出范围的卷积不受支持;N 的计算如下。图内 dilation_kernel_h/w 与末章 dilated_kernel_h/w 拼写不一致,保留原图写法。
| 条件 | 公式 |
|---|---|
| A (1) | width * dilation_kernel_h <= 2048 * N |
| A (2) | width <= 4096 |
| A / Convolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
| A / Depthwise Convolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 4096) |
| A / ConvTranspose/Deconvolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
原图表头写“声明见注释 9”,提供原稿的输入说明仅列 1–8,未找到注释 9;不猜补。
RK3562
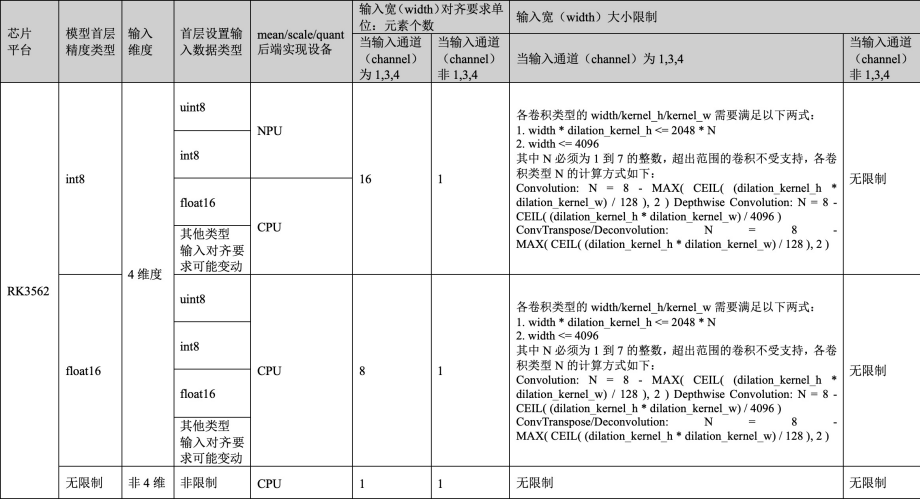
原图可编辑转录(合并单元格展开):
| 平台 | 模型首层精度 | 输入维度 | 首层设置输入数据类型 | mean/scale/quant 后端 | width 对齐(元素数),channel=1,3,4 | width 对齐(元素数),channel≠1,3,4 | width 限制,channel=1,3,4 | width 限制,channel≠1,3,4 |
|---|---|---|---|---|---|---|---|---|
| RK3562 | int8 | 4 | uint8 | NPU | 16 | 1 | A | 无限制 |
| RK3562 | int8 | 4 | int8 | NPU | 16 | 1 | A | 无限制 |
| RK3562 | int8 | 4 | float16 | CPU | 16 | 1 | A | 无限制 |
| RK3562 | int8 | 4 | 其他类型(输入对齐要求可能变动) | CPU | 16 | 1 | A | 无限制 |
| RK3562 | float16 | 4 | uint8 | CPU | 8 | 1 | B | 无限制 |
| RK3562 | float16 | 4 | int8 | CPU | 8 | 1 | B | 无限制 |
| RK3562 | float16 | 4 | float16 | CPU | 8 | 1 | B | 无限制 |
| RK3562 | float16 | 4 | 其他类型(输入对齐要求可能变动) | CPU | 8 | 1 | B | 无限制 |
| RK3562 | 无限制 | 非 4 维 | 无限制 | CPU | 1 | 1 | 无限制 | 无限制 |
各卷积类型的 width/kernel_h/kernel_w 须满足下列两式。N 必须为 1 到 7 的整数,超出范围的卷积不受支持;N 的计算如下。图内 dilation_kernel_h/w 与末章 dilated_kernel_h/w 拼写不一致,保留原图写法。
| 条件 | 公式 |
|---|---|
| A (1) | width * dilation_kernel_h <= 2048 * N |
| A (2) | width <= 4096 |
| A / Convolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
| A / Depthwise Convolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 4096) |
| A / ConvTranspose/Deconvolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
| 条件 | 公式 |
|---|---|
| B (1) | width * dilation_kernel_h <= 2048 * N |
| B (2) | width <= 4096 |
| B / Convolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
| B / Depthwise Convolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 4096) |
| B / ConvTranspose/Deconvolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
RK3576/RV1126B
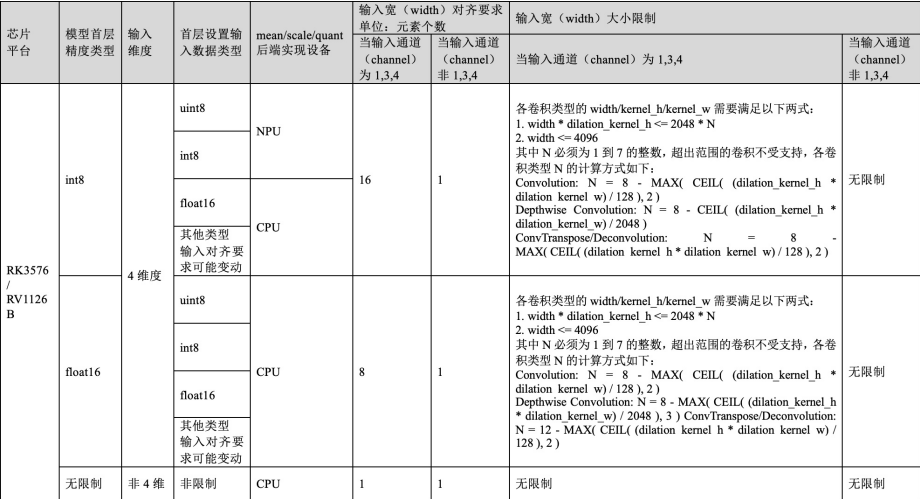
原图可编辑转录(合并单元格展开):
| 平台 | 模型首层精度 | 输入维度 | 首层设置输入数据类型 | mean/scale/quant 后端 | width 对齐(元素数),channel=1,3,4 | width 对齐(元素数),channel≠1,3,4 | width 限制,channel=1,3,4 | width 限制,channel≠1,3,4 |
|---|---|---|---|---|---|---|---|---|
| RK3576/RV1126B | int8 | 4 | uint8 | NPU | 16 | 1 | A | 无限制 |
| RK3576/RV1126B | int8 | 4 | int8 | NPU | 16 | 1 | A | 无限制 |
| RK3576/RV1126B | int8 | 4 | float16 | CPU | 16 | 1 | A | 无限制 |
| RK3576/RV1126B | int8 | 4 | 其他类型(输入对齐要求可能变动) | CPU | 16 | 1 | A | 无限制 |
| RK3576/RV1126B | float16 | 4 | uint8 | CPU | 8 | 1 | B | 无限制 |
| RK3576/RV1126B | float16 | 4 | int8 | CPU | 8 | 1 | B | 无限制 |
| RK3576/RV1126B | float16 | 4 | float16 | CPU | 8 | 1 | B | 无限制 |
| RK3576/RV1126B | float16 | 4 | 其他类型(输入对齐要求可能变动) | CPU | 8 | 1 | B | 无限制 |
| RK3576/RV1126B | 无限制 | 非 4 维 | 无限制 | CPU | 1 | 1 | 无限制 | 无限制 |
各卷积类型的 width/kernel_h/kernel_w 须满足下列两式。N 必须为 1 到 7 的整数,超出范围的卷积不受支持;N 的计算如下。图内 dilation_kernel_h/w 与末章 dilated_kernel_h/w 拼写不一致,保留原图写法。
| 条件 | 公式 |
|---|---|
| A (1) | width * dilation_kernel_h <= 2048 * N |
| A (2) | width <= 4096 |
| A / Convolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
| A / Depthwise Convolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 2048) |
| A / ConvTranspose/Deconvolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
| 条件 | 公式 |
|---|---|
| B (1) | width * dilation_kernel_h <= 2048 * N |
| B (2) | width <= 4096 |
| B / Convolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
| B / Depthwise Convolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 2048), 3) |
| B / ConvTranspose/Deconvolution | N = 12 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
RK2118
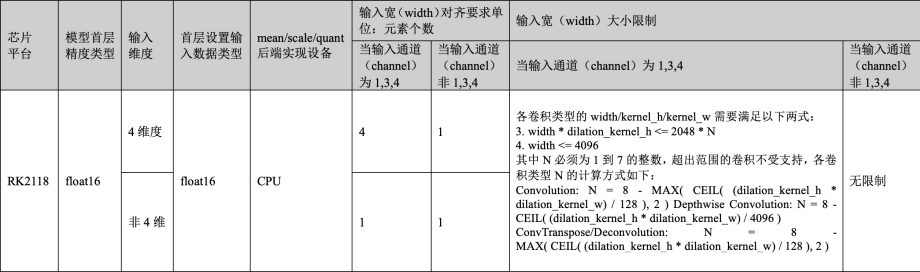
原图可编辑转录(合并单元格展开):
| 平台 | 模型首层精度 | 输入维度 | 首层设置输入数据类型 | mean/scale/quant 后端 | width 对齐(元素数),channel=1,3,4 | width 对齐(元素数),channel≠1,3,4 | width 限制,channel=1,3,4 | width 限制,channel≠1,3,4 |
|---|---|---|---|---|---|---|---|---|
| RK2118 | float16 | 4 | float16 | CPU | 4 | 1 | A | 无限制 |
| RK2118 | float16 | 非 4 维 | float16 | CPU | 1 | 1 | A | 无限制 |
各卷积类型的 width/kernel_h/kernel_w 须满足下列两式。N 必须为 1 到 7 的整数,超出范围的卷积不受支持;N 的计算如下。图内 dilation_kernel_h/w 与末章 dilated_kernel_h/w 拼写不一致,保留原图写法。
| 条件 | 公式 |
|---|---|
| A (1) | width * dilation_kernel_h <= 2048 * N |
| A (2) | width <= 4096 |
| A / Convolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
| A / Depthwise Convolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 4096) |
| A / ConvTranspose/Deconvolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
RV1103B
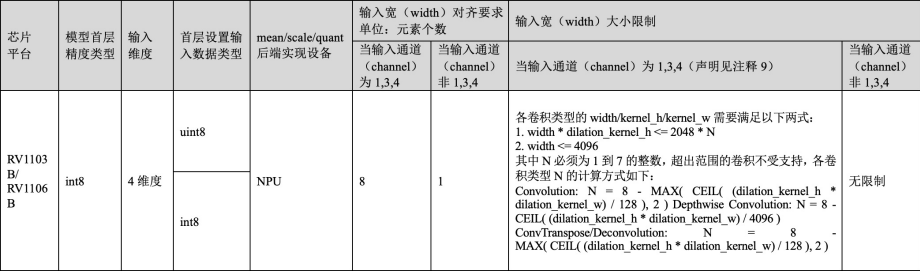
原图可编辑转录(合并单元格展开):
| 平台 | 模型首层精度 | 输入维度 | 首层设置输入数据类型 | mean/scale/quant 后端 | width 对齐(元素数),channel=1,3,4 | width 对齐(元素数),channel≠1,3,4 | width 限制,channel=1,3,4 | width 限制,channel≠1,3,4 |
|---|---|---|---|---|---|---|---|---|
| RV1103B/RV1106B | int8 | 4 | uint8 | NPU | 8 | 1 | A | 无限制 |
| RV1103B/RV1106B | int8 | 4 | int8 | NPU | 8 | 1 | A | 无限制 |
各卷积类型的 width/kernel_h/kernel_w 须满足下列两式。N 必须为 1 到 7 的整数,超出范围的卷积不受支持;N 的计算如下。图内 dilation_kernel_h/w 与末章 dilated_kernel_h/w 拼写不一致,保留原图写法。
| 条件 | 公式 |
|---|---|
| A (1) | width * dilation_kernel_h <= 2048 * N |
| A (2) | width <= 4096 |
| A / Convolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
| A / Depthwise Convolution | N = 8 - CEIL((dilation_kernel_h * dilation_kernel_w) / 4096) |
| A / ConvTranspose/Deconvolution | N = 8 - MAX(CEIL((dilation_kernel_h * dilation_kernel_w) / 128), 2) |
原图表头写“声明见注释 9”,提供原稿的输入说明仅列 1–8,未找到注释 9;不猜补。
模型输出限制说明
-
如果输出 tensor 类型是 NHWC 的,输出转换是 NPU 实现的输出,则有对齐要求,CPU 实现的没有对齐要求。
-
输出精度类型 int8/float16 表示模型最后一层原始输出的数据类型。
-
NCHW 输出,如果是 NPU 实现采用零拷贝接口则输出内存开辟的 size 以 query 出来的 size 为准。
-
NC1HWC2 输出,输出内存开辟的 size 以 query 出来的 size 为准。
RK3566/RK3568
| 芯片平台 | 模型输出精度类型 | 输出维度 | 设置输出 Layout | Channel 对齐要求 | H*W 对齐要求 |
|---|---|---|---|---|---|
| RK3566/RK3568 | int8 | 4 | NCHW | 无 | 无 |
| RK3566/RK3568 | int8 | 4 | NHWC | 8 对齐 | 无 |
| RK3566/RK3568 | int8 | 4 | NC1HWC2 | 最后一层卷积类算子:16 对齐;非卷积类:8 对齐 | 4 对齐 |
| RK3566/RK3568 | int8 | 4 | UNDEFINE | 无 | 无 |
| RK3566/RK3568 | float16 | 4 | NCHW | 无 | 无 |
| RK3566/RK3568 | float16 | 4 | NHWC | 4 对齐 | 无 |
| RK3566/RK3568 | float16 | 4 | NC1HWC2 | 最后一层卷积类算子:8 对齐;非卷积类:4 对齐 | 4 对齐 |
| RK3566/RK3568 | float16 | 4 | UNDEFINE | 无 | 无 |
| RK3566/RK3568 | 无限制 | 非4维 | UNDEFINE | 无 | 无 |
RK3588
| 芯片平台 | 模型输出精度类型 | 输出维度 | 设置输出 Layout | Channel 对齐要求 | H*W 对齐要求 |
|---|---|---|---|---|---|
| RK3588 | int8 | 4 | NCHW | 无 | 无 |
| RK3588 | int8 | 4 | NHWC | 16 对齐 | 无 |
| RK3588 | int8 | 4 | NC1HWC2 | 最后一层卷积类算子:32 对齐;非卷积类:16 对齐 | 4 对齐 |
| RK3588 | int8 | 4 | UNDEFINE | 无 | 无 |
| RK3588 | float16 | 4 | NCHW | 无 | 无 |
| RK3588 | float16 | 4 | NHWC | 8 对齐 | 无 |
| RK3588 | float16 | 4 | NC1HWC2 | 最后一层卷积类算子:16 对齐;非卷积类:8 对齐 | 4 对齐 |
| RK3588 | float16 | 4 | UNDEFINE | 无 | 无 |
| RK3588 | 无限制 | 非4维 | UNDEFINE | 无 | 无 |
RV1103/RV1106
| 芯片平台 | 模型输出精度类型 | 输出维度 | 设置输出 Layout | Channel 对齐要求 | H*W 对齐要求 |
|---|---|---|---|---|---|
| RV1103/RV1106 | int8 | 4 | NC1HWC2 | 最后一层卷积类算子:32 对齐;非卷积类:16 对齐 | 4 对齐 |
| RV1103/RV1106 | int8 | 4 | NHWC | 无 | 无 |
RK3562
| 芯片平台 | 模型输出精度类型 | 输出维度 | 设置输出 Layout | Channel 对齐要求 | H*W 对齐要求 |
|---|---|---|---|---|---|
| RK3562 | int8 | 4 | NCHW | 无 | 无 |
| RK3562 | int8 | 4 | NHWC | 无 | 无 |
| RK3562 | int8 | 4 | NC1HWC2 | 最后一层卷积类算子:32 对齐;非卷积类:16 对齐 | 4 对齐 |
| RK3562 | int8 | 4 | UNDEFINE | 无 | 无 |
| RK3562 | float16 | 4 | NCHW | 无 | 无 |
| RK3562 | float16 | 4 | NHWC | 无 | 无 |
| RK3562 | float16 | 4 | NC1HWC2 | 最后一层卷积类算子:16 对齐;非卷积类:8 对齐 | 4 对齐 |
| RK3562 | float16 | 4 | UNDEFINE | 无 | 无 |
| RK3562 | 无限制 | 非4维 | UNDEFINE | 无 | 无 |
RK3576/RV1126B
| 芯片平台 | 模型输出精度类型 | 输出维度 | 设置输出 Layout | Channel 对齐要求 | H*W 对齐要求 |
|---|---|---|---|---|---|
| RK3576/RV1126B | int8 | 4 | NCHW | 无 | 无 |
| RK3576/RV1126B | int8 | 4 | NHWC | 无 | 无 |
| RK3576/RV1126B | int8 | 4 | NC1HWC2 | 最后一层卷积类算子:32 对齐;非卷积类:16 对齐 | 4 对齐 |
| RK3576/RV1126B | int8 | 4 | UNDEFINE | 无 | 无 |
| RK3576/RV1126B | float16 | 4 | NCHW | 无 | 无 |
| RK3576/RV1126B | float16 | 4 | NHWC | 无 | 无 |
| RK3576/RV1126B | float16 | 4 | NC1HWC2 | 最后一层卷积类算子:16 对齐;非卷积类:8 对齐 | 4 对齐 |
| RK3576/RV1126B | float16 | 4 | UNDEFINE | 无 | 无 |
| RK3576/RV1126B | 无限制 | 非4维 | UNDEFINE | 无 | 无 |
RK2118
| 芯片平台 | 模型输出精度类型 | 输出维度 | 设置输出 Layout | Channel 对齐要求 | H*W 对齐要求 |
|---|---|---|---|---|---|
| RK2118 | float16 | 4 | NC1HWC2 | 最后一层卷积类算子:8 对齐;非卷积类:4 对齐 | 4 对齐 |
| RK2118 | float16 | 4 | NHWC | 无 | 无 |
| RK2118 | float16 | 非4维 | UNDEFINE | 无 | 无 |
RV1103B/RV1106B
| 芯片平台 | 模型输出精度类型 | 输出维度 | 设置输出 Layout | Channel 对齐要求 | H*W 对齐要求 |
|---|---|---|---|---|---|
| RV1103B/RV1106B | int8 | 4 | NC1HWC2 | 最后一层卷积类算子:8 对齐;非卷积类:8 对齐 | 4 对齐 |
| RV1103B/RV1106B | int8 | 4 | NHWC | 无 | 无 |
特殊说明
dilated_kernel_h
dilated_kernel_h = kernel_h * dilations_h - dilations_h + 1
dilated_kernel_w
dilated_kernel_w = kernel_w * dilations_w - dilations_w + 1