
ArmSoM-Plattformreferenz mit vollständigem technischen Rockchip-Inhalt. Board, SoC, SDK/BSP, Kernel und Audiohardware/-bibliotheken prüfen; keine Zusage für alle Boards. Ergebnisse und Protokolle sind keine ArmSoM-Tests. Keine Befehle oder Hardwarevalidierung ausgeführt.
Quelle V1.7.0 beschreibt VQE-Schnittstellen, Module und Parameter; Geltung alle Serien/allgemein. Chinesisch verwendet chinesische Bilder, die übrigen englische Originale. Tests fanden im Rockchip-Studio statt und sind lediglich Quellenreferenzen.
1. Überblick
1.1 Audioalgorithmus-Funktionen
Der Mikrofonarray-Algorithmus umfasst AEC, BF, ANR und AGC. AEC entfernt vom Mikrofon aufgenommenen Lautsprecherschall; BF verstärkt Sprache und unterdrückt kohärente sowie Umgebungsgeräusche; ANR reduziert Umgebungsrauschen; AGC hebt den Sprachpegel an.
2. Audioalgorithmus
Mehrmikrofonverarbeitung dient hauptsächlich Echounterdrückung und Sprachverbesserung.
2.1 Audioalgorithmus-Module
Der vollständige Algorithmus enthält die in Abbildung 1 gezeigten Module:
2.1.1 Hilfsmodule
Hilfsmodule sind High pass-Filter, pre-emphasis und de-emphasis. Der Hochpass entfernt niederfrequentes Schaltungsrauschen; Pre-Emphasis hebt hochfrequente Sprachenergie und deren Übertragungs-SNR an, De-Emphasis stellt das Spektrum am Ausgang wieder her.
2.1.2 AECModul
AEC besteht aus MDF und Delay. MDF unterdrückt lineares Echo; Delay schätzt die Verzögerung zwischen Rückführreferenz und Mikrofonsignal.
2.1.3 BeamformingModul
Beamforming (BF) enthält FAST_AEC, WAKEUP, ANR, Dereverb, AES, AGC, CNG, DTD, Howling, EQ und DOA.
FAST_AEC: lineare Rest echounterdrückung. WAKEUP: RK-spezifisches Aufwecken durch ein Schlüsselwort. ANR: Unterdrückung von Umgebungs-, Wind- und Impulsgeräuschen. Dereverb: Nachhallentfernung. AES: weitere Rest echounterdrückung. GSC: Strahlformung, bei Mehrmikrofoneingang standardmäßig aktiv; zusätzliche Fix/GSC/CHN_SELECT aktivieren feste Richtung/Nachfilterung/angepasste Mic-Erweiterung. AGC: Sprachpegelregelung. CNG: Komfortgeräusch. DTD: Doppelsprecherkennung. Howling: Rückkopplungsunterdrückung. EQ: Frequenzbandverstärkung. DOA: Schallquellenrichtung. AINR: KI-Unterdrückung aller Geräusche außer menschlicher Stimme.
2.2 Audioalgorithmus-Ablauf
Das Mikrofonarray bietet zwei Sprachpfade.
2.2.1 Aufweckpfad
Der Aufweckpfad ermöglicht Geräteantwort und Ortung und liefert Audio aus der Position des Sprechers; siehe Abbildung 1.
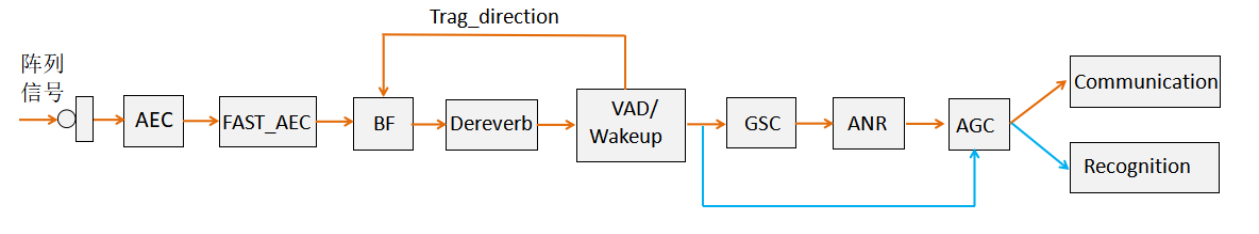
Abbildung 1. Aufweckpfad
-
Nach der Array-Aufnahme entfernt AEC lineares Echo, anschließend unterdrückt FAST_AEC innerhalb BF weiteres Echo.
-
Der feste Strahl liefert verstärkte Sprache.
-
Dereverb entfernt verbleibenden Nachhall.
-
Wakeup bestimmt die Quellenposition.
-
Die lokalisierte Sprache wird durch GSC nachgefiltert. Hinweis: Der blau markierte Cloud-Erkennungspfad leitet sie direkt zum AGC-Ausgang.
-
ANR reduziert weiteres Rauschen der verarbeiteten Sprache.
-
AGC verstärkt die Sprache für die Übertragung zur Gegenstelle.
2.2.2 Gesprächspfad
Der Gesprächspfad führt kein Aufwecken durch; abgesehen von Wakeup ähneln seine Module dem Aufweckpfad. Siehe Abbildung 2.
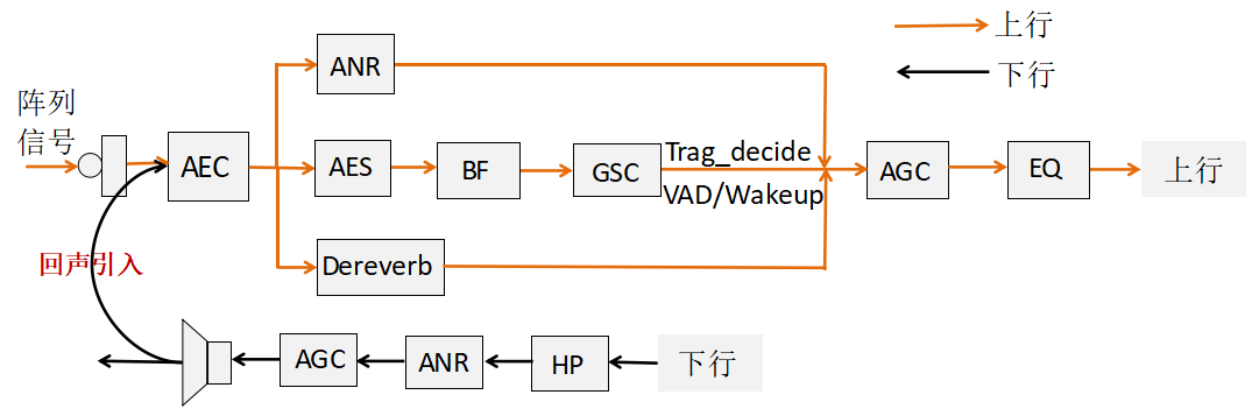
Abbildung 2. Gesprächspfad
-
Nach der Aufnahme entfernt AEC lineares Echo.
-
ANR/AINR, Dereverb und AES schätzen Rauschen/Nachhall und unterdrücken Restecho.
-
Beamforming liefert verbesserte Sprache und unterstützt Quellenortung sowie gerichtete Aufnahme.
-
AGC und EQ verstärken die Sprache vor der Übertragung zur Gegenstelle.
2.3 Ergebnisse des Audioalgorithmus
2.3.1 AECModulergebnisse
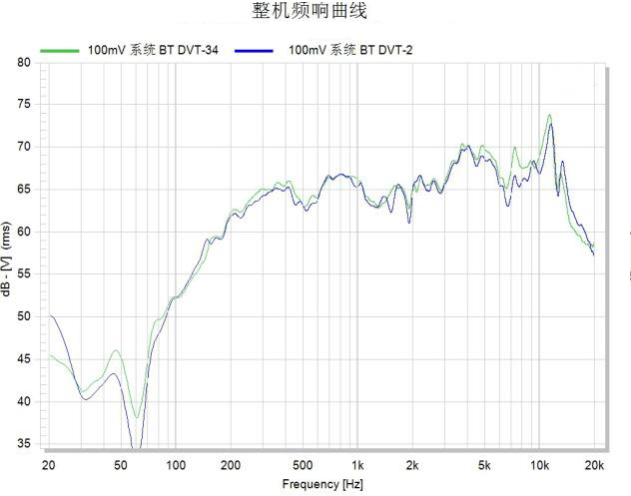
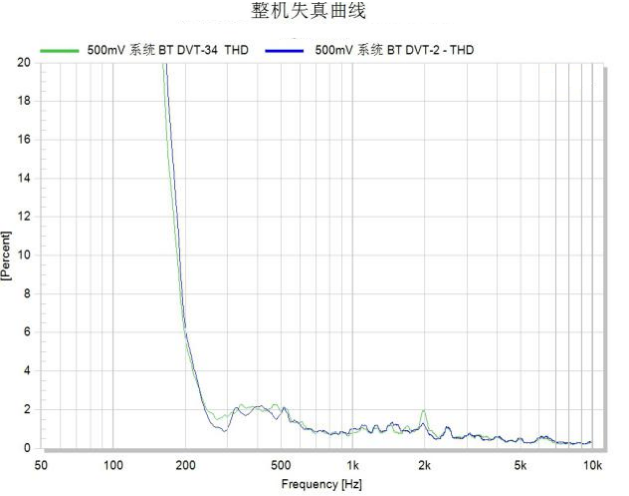
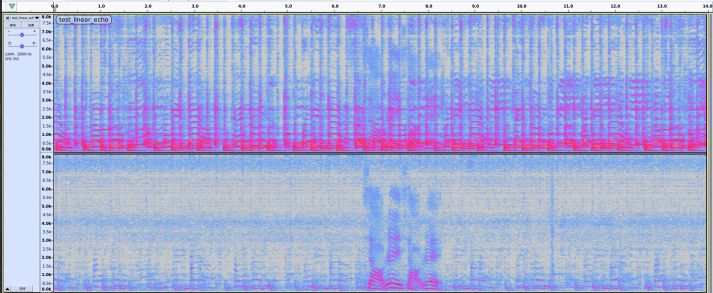
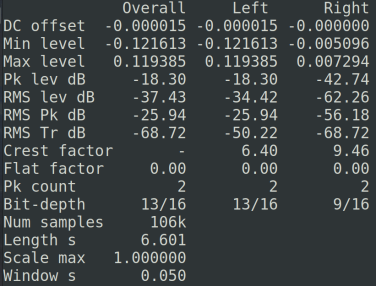
Es folgen Ergebnisse beider Mehrmikrofonpfade. Verwendet wurden WV2215-Lautsprecher, MSM261D4030H1CPM-Mikrofon und das Rockchip-Studio. Abbildung 3 zeigt Frequenzgang und Verzerrung des WV2215. Getestet wurde Aufwecken mit Rauschen: linker Kanal Eingang, rechter Kanal verarbeiteter Ausgang. Links sind Frequenzdarstellungen, rechts Zeitbereichsstatistiken im reinen Rauschabschnitt.
Lineare Echounterdrückung: Die Aufnahme stammt nicht aus einer professionellen Akustikumgebung und enthält Umgebungsrauschen; nur Referenzergebnisse. Abbildung 4 zeigt lineare Echounterdrückung mit durchschnittlich etwa 30dB. Anschließend folgt nichtlineare Unterdrückung.
Nichtlineare Unterdrückung: ebenfalls keine professionelle Akustikumgebung, nur Referenzergebnisse. Abbildung 5 zeigt nichtlineare Echounterdrückung.
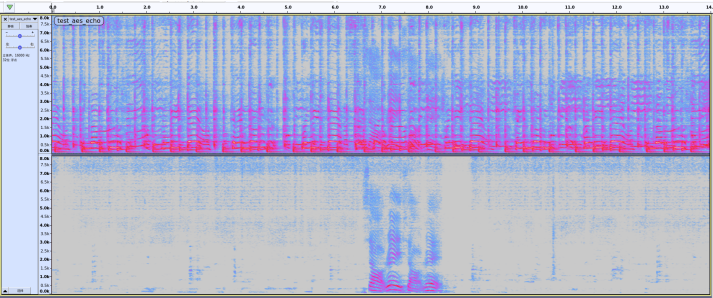
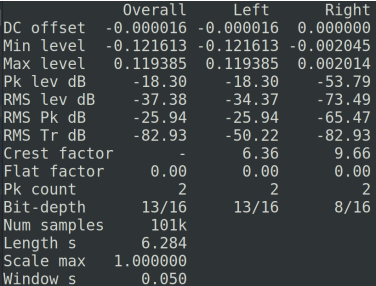
In diesem Szenario beträgt die mittlere Echounterdrückung etwa 40dB.
2.3.2 BFModulergebnisse
Der Störtest fand im Rockchip-Studio statt. Testquelle: 70dB in 1m, Abstand zum Array 5m. Störquelle: 64dB in 1m, Abstand zum Array 1m. Es folgen Aufweckergebnisse in üblicher Umgebung, nur als Referenz.
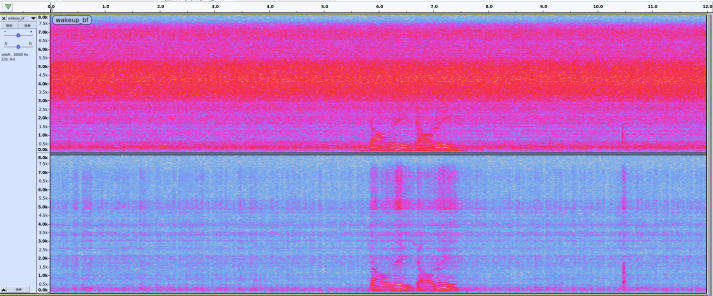
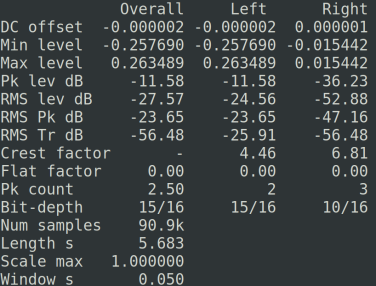
Abbildung 6. Aufweckpfad: durchschnittlich etwa 28dB Hintergrundrauschunterdrückung.
Hinweis: Aufwecken nutzt nur einen festen Strahl, um Sprachschäden zu vermeiden. Es folgen Referenzergebnisse des Gesprächspfads in üblicher Umgebung.
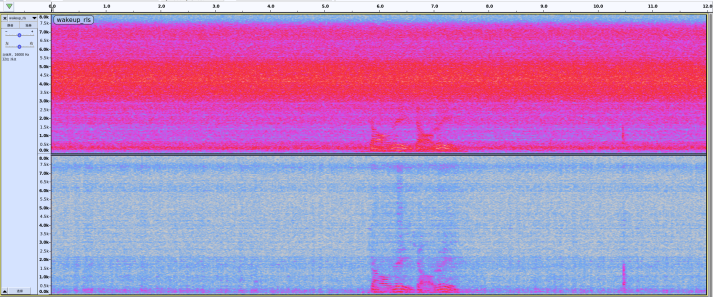
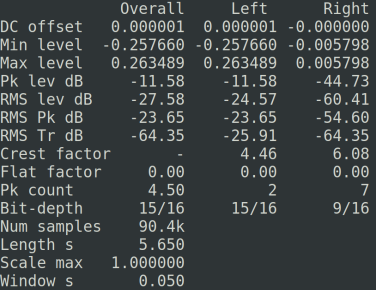
Abbildung 7. Gesprächspfad: durchschnittlich etwa 36dB Hintergrundrauschunterdrückung.
3. Aufruf der Audioalgorithmus-Schnittstellen
Aufrufablauf der Bibliothek:
-
Offene Mikrofonalgorithmusparameter einstellen. AEC hängt von Produktakustik, Bauteilen und Anforderungen ab. Zur Erstintegration können Standardwerte verwendet und anschließend nach Ergebnis angepasst werden. Parameter in rkaudio_preprocess.h ändern und dessen Pfad bei der Initialisierung übergeben.
-
Initialisierung nach Gesprächsbeginn, vor der frameweisen Verarbeitung. Aufruf von rkaudio_preprocess_init:
st_ptr = rkaudio_preprocess_init(mSampleRate, mBitPerSample, num_src_channel,
num_ref_channel, ¶m);
mSampleRate unterstützt 8kHz, 16kHz, 24kHz, 32kHz, 44.1kHz und 48kHz; mBitPerSample beträgt 16bit; num_src_channel ist die Mic-Kanalzahl, num_ref_channel die Rückführkanalzahl, param enthält später beschriebene Einstellungen aus rkaudio_preprocess.h. Die Initialisierung setzt interne Parameter und reserviert Speicher. Bei Erfolg wird st_ptr zurückgegeben, andernfalls NULL.
- Echtzeitverarbeitung je Frame. Bei 16ms und 16k enthält jeder Frame 256 Abtastwerte. Aufruf von rkaudio_preprocess_short:
out_size = rkaudio_preprocess_short(st_ptr, (short*)in, out, in_size / 2, &is_wakeup);
st_ptr stammt aus der Initialisierung; in ist der Eingang in byte, out der Ausgang in short. in_size ist die Bytezahl je Frame: 256 * num_channel * 2.
- Nach dem Gespräch Speicher mit rkaudio_preprocess_destory(st_ptr) und rkaudio_param_deinit(¶m) freigeben.
4. Parameterabstimmung
Arrayparameter werden in rkaudio_preprocess.h eingestellt.
4.1 globale ModuleParametereinstellungen
Hauptgruppen sind AEC über rkaudio_aec_param_init() und BF über rkaudio_preprocess_param_init(). Es folgen Grundeinstellungen der Eingangskanalzahlen.
#define NUM_CHANNEL         4  /* 设置总通道数,即mic通道以及回采通道之和 */
#define NUM_REF_CHANNEL     2  /* 设置回采通道数,该处设置2回采通道 */
#define NUM_DROP_CHANNEL    0  /* 设置不处理的回采通道数,置0没有丢弃,置为N(N>0)时丢弃回采通路的最后N
路 */
#define REF_POSITION        0  /* 回采位置,0为回采通道位于mic数据最前⾯,1则在最后⾯ */
static short Array[NUM_CHANNEL] = { 0, 1, 2, 3};  /* 设置通道顺序,⽤于不规则⻨克⻛调整 */
4.2 AECModulParametereinstellungen
AEC wird über rkaudio_aec_param_init() eingestellt. model_aec_en steuert Untermodulschalter wie EN_DELAY und EN_ARRAY_RESET; Details in den Codekommentaren.
param->pos               /* 回采通道所在位置,通过宏REF_POSITION赋值 */
param->drop_ref_channel  /* 不处理的回采通道数,通过宏NUM_DROP_CHANNEL赋值 */
param->model_aec_en      /* 置0表⽰不开除了线性AEC以外的⼦模块,置EN_DELAY开启延迟估计,软回采必须开
启,置EN_ARRAY_RESET开启输⼊⾳频通道顺序重排功能 */
param->delay_len         /* 延迟估计不开时为默认硬回采延迟点,延迟估计打开时为起始延迟估计点 */
param->look_ahead        /* 缓存⻨克⻛端数据⻓度,除⾮已知采集⻨克⻛信号晚于回采信号可配置,其余情况默认
置0 */
param->Array_list        /* 配置⾳频通道顺序,通过数组Array赋值 */
param->filter_len        /* 配置线性AEC滤波器⻓度,设置越⻓对于回声估计越准确,但收敛速度相应越慢且算⼒
越⼤。⼀般可配置为2/4/6/8 */
param->delay_para = rkaudio_delay_param_init() /* 延时估计⼦模块参数设置 */
4.3 VerzögerungsschätzungsmodulParametereinstellungen
Delay wird über rkaudio_delay_param_init() konfiguriert:
param->MaxFrame      /* 延时估计最⻓估计帧数,⼀般场景建议设为16 */
param->LeastDelay    /* 延时估计最短估计帧数,MaxFrame没有特别⼤时建议设为0 */
param->JumpFrame     /* 初始跳过帧数,⼀般设为12 */
param->DelayOffset   /* offset帧数,⽤于防⽌延时估计过⼤导致⻨克⻛信号晚于回采信号,⼀般设为1 */
param->MicAmpThr     /* mic端最⼩能量阈值,低于该值不更新延时估计结果,⼀般设为50 */
param->RefAmpThr     /* ref端最⼩能量阈值,低于该值不更新延时估计结果,⼀般设为50 */
param->StartFreq     /* 延时估计起始频段的频率,⼀般选择语⾳集中频段,根据实际收⾳效果调整,⼀般设为500
*/
param->EndFreq       /* 延时估计终⽌频段的频率,⼀般选择语⾳集中频段,根据实际收⾳效果调整,⼀般设为4000
*/
param->SmoothFactor  /* 平滑系数,⼀般取值为[0.95,1),越⾼延时估计结果越稳定,越低延时估计结果更新越快,
⼀般设为0.97/0.99 */
4.4 BFModulParametereinstellungen
BF umfasst EN_Fastaec, EN_Wakeup, EN_Dereverberation, EN_AES, EN_Agc, EN_Anr, EN_STDT, EN_CNG, EN_EQ, EN_HOWLING, EN_DOA, EN_WIND, EN_AINR und weitere Untermodule; siehe Kommentare.
typedef enum RKPreprocessEnable_
{
    EN_Fastaec = 1 << 0,          /* 线性残留回声消除模块,该功能⽤于唤醒通路进⼀步消除回声 */
    EN_Wakeup = 1 << 1,           /* 唤醒模块 */
    EN_Dereverberation = 1 << 2,  /* 去混响模块 */
    EN_Nlp = 1 << 3,              /* ⾮线性残留回声消除模块,该功能⽤于通话通路进⼀步消除回声(改模块已
弃⽤) */
    EN_AES = 1 << 4,              /* ⾮线性残留回声消除模块 */
    EN_Agc = 1 << 5,              /* ⾃动增益控制模块 */
    EN_Anr = 1 << 6,              /* 噪声抑制模块 */
    EN_GSC = 1 << 7,              /* 波束后滤波模块,⽤于进⼀步消除噪声,视实际效果决定是否打开 */
    GSC_Method = 1 << 8,          /* 关闭则GSC采⽤LMS⽅法,打开GSC采⽤RLS⽅法,RLS算⼒⾼于LMS算法
*/
    EN_Fix = 1 << 9,              /* 启⽤固定⽅向波束 */
    EN_STDT = 1 << 10,            /* 单双讲检测模块 */
    EN_CNG = 1 << 11,             /* 舒适度噪声模块 */
    EN_EQ = 1 << 12,              /* EQ调节模块 */
    EN_CHN_SELECT = 1 << 13,      /* ⽤于定制化扩展MIC需求场景 */
    EN_HOWLING = 1 << 14,         /* 去啸叫模块,视实际场景需求决定是否打开 */
    EN_DOA = 1 << 15,             /* 声源定位模块,⽤于估计声源⽅向,视实际场景需求决定是否打开 */
    EN_WIND = 1 << 16,            /* 去⻛噪模块,视实际场景需求决定是否打开 */
    EN_AINR = 1 << 17,            /* AI降噪模块,若开启该模块则ANR模块将强制关闭 */
} RKPreprocessEnable;
Gesamtkonfiguration von BF über rkaudio_preprocess_param_init():
param->model_bf_en  /* ⼦模块开关,置0表⽰bf模块在⾮多⻨情况下没有开启任何模块,当在多⻨情况下会默认跑波
束模块,其余⼦模块可根据需要⾃⾏开关 */
param->Targ = 0;  /* 当EN_Fix打开时,设置拾⾳⽅向 */
param->ref_pos = REF_POSITION;  /* 回采通道所在位置,通过宏REF_POSITION赋值 */
param->num_ref_channel = NUM_REF_CHANNEL;  /* 回采总通道数,通过宏NUM_REF_CHANNEL赋值 */
param->drop_ref_channel = NUM_DROP_CHANNEL;  /* 不处理的回采通道数,通过宏NUM_DROP_CHANNEL赋值 */
param->anr_para = rkaudio_anr_param_init_tx();         /* ANR模块参数配置 */
param->dereverb_para = rkaudio_dereverb_param_init();  /* 去混响模块参数配置 */
param->aes_para = rkaudio_aes_param_init();            /* AES模块参数配置 */
param->dtd_para = rkaudio_dtd_param_init();            /* DTD模块参数配置 */
param->agc_para = rkaudio_agc_param_init();            /* AGC模块参数配置 */
param->cng_para = rkaudio_cng_param_init();            /* CNG模块参数配置 */
param->eq_para = rkaudio_eq_param_init();              /* EQ模块参数配置 */
param->howl_para = rkaudio_howl_param_init_tx();       /* 啸叫模块参数配置 */
param->doa_para = rkaudio_doa_param_init();            /* DOA模块参数配置 */
4.5 ANRModulParametereinstellungen
ANR reduziert Sprachumgebungsrauschen und wird über rkaudio_anr_param_init() konfiguriert:
param->noiseFactor     /* 噪声估计⽔平,⼀般取值范围在[0.5f,1.5f],越⼤噪声消除越⼲净 */
param->swU             /* 噪声估计帧⻓时间⽚,⼀般取值范围[2,20],设置越⼤对平稳噪声估计越准确,对突变噪
声收敛越慢;反之对突变噪声收敛越快但容易造成语⾳过消 */
param->PsiMin          /* 语⾳存在概率判断阈值,取值范围[0.0f,1.0f],,设置越⼤,噪⾳消除效果越强 */
param->PsiMax          /* 语⾳存在概率判断阈值,取值范围[0.0f,1.0f],设置越⼤,噪⾳消除效果越强 */
param->fGmin           /* 噪声消除最⼩值,取值范围[0.0f,1.0f],设置越⼩,噪⾳消除效果越强 */

param->Sup_Freq1       /* 恒频噪声抑制点1,取值范围[0,1/2*sample rate],始终抑制设置点噪声 */
param->Sup_Freq2       /* 恒频噪声抑制点2,取值范围[0,1/2*sample rate],始终抑制设置点噪声*/
param->Sup_Energy1     /* 恒频噪声抑制点1对应的能量阈值,⼀般取值100000,当频点能量超出该值时会对恒频噪
声的估计进⾏更新 */
param->Sup_Energy2     /* 恒频噪声抑制点1对应的能量阈值,⼀般取值100000,当频点能量超出该值时会对恒频噪
声的估计进⾏更新 */

param->InterV          /* 取帧间隔,⼀般取值范围[2,20],设置越⼤估计的噪声越平稳,类似swU功能 */
param->BiasMin         /* 噪声补偿,⼀般取值范围[1.0f, 2.0f],设置越⼤噪声消除效果越强 */
param->UpdateFrm       /* 快速收敛⻓度,⼀般设置为15,在开头15帧快速收敛 */
param->NPreGammaThr    /* 纯噪声概率估计阈值,⼀般取值范围(3.0f,5.0f),设置越⼤噪声消除效果越强 */
param->NPreZetaThr     /* 纯噪声概率估计阈值,⼀般取值范围(1.0f,3.0f),设置越⼤噪声消除效果越强 */
param->SabsGammaThr0   /* 语⾳不存在概率估计阈值,⼀般取值范围(0.5f,1.5f),设置越⼤噪声消除效果越强*/
param->SabsGammaThr1   /* 语⾳不存在概率估计阈值,⼀般取值范围(2.f,4.0f),设置越⼤噪声消除效果越强*/
param->InfSmooth       /* 输⼊信号平滑系数,取值范围(0.0f,1.0f) */
param->ProbSmooth      /* 语⾳存在概率平滑系数,取值范围(0.0f,1.0f) */
param->CompCoeff       /* 噪声补偿,⼀般取值范围[1.0f, 2.0f],对于低于平均噪声估计的频段进⾏补偿,设置
越⼤噪声消除效果越强 */
param->PrioriMin       /* 先验信噪⽐最⼩值,取值范围(0.0f, 0.5f),设置越⼤噪声消除效果越弱 */
param->PostMax         /* 后验信噪⽐最⼤值,⼀般设为40 */
param->PrioriRatio     /* 先验信噪⽐平滑系数,取值范围(0.0f,1.0f),设置越⼤噪声消除效果越强 */
param->PrioriRatioLow  /* 先验信噪⽐平滑系数,取值范围(0.0f,1.0f),设置越⼤噪声消除效果越强 */
param->SplitBand       /* 分频段index,取值范围[0,32],对于低于该index的先验信噪⽐⽤PrioriRatioLow
进⾏平滑,反之⽤PrioriRatio */
param->PrioriSmooth    /* 先验信噪⽐平滑系数,取值范围(0.0f,1.0f),设置越⼤噪声消除效果越强 */
param->TranMode        /* 冲击噪声开关,置0表⽰关闭,置1表⽰使⽤检测消除⽅法,置2表⽰使⽤估计消除⽅法 */
4.6 AINRModulParametereinstellungen
AINR erweitert klassisches ANR und unterdrückt instationäre Geräusche wie Wind und Impulse besser bei natürlicherem Klang. AINR und ANR ergänzen sich und können einzeln oder gemeinsam arbeiten.
param->mode = 2;          /* 后处理模式,可选模式1和2,默认模式2。模式1的语⾳保护及平滑⼤于模式2,适合远
场⼩语⾳场景;模式2降噪深度⼤于模式1,适合⼤背噪场景 */
param->alpha1 = 0.35;     /* 平滑系数,⼀般设为0.35,取值范围[0,0.65] */
param->mini_gain = 0.01;  /* 环境⾳保留占⽐,取值范围 [0.0,1.0],⼀般设置范围[0.005,0.1],取值越⼤环
境⾳保留越⼤ */
param->pregain = 1.0;     /* 输⼊⾳频送⼊AINR前的预增益,默认值1.0,前端增益过低或过⾼导致效果异常时可
增⼤或减⼩该值 */
/* 以下为保留参数作为扩展⽤ */
param->alpha2 = 0;        /* 保留参数 */
param->preserve1 = 0.0;   /* 保留参数,mode==1时该参数作为噪声⻔限,数值越⼤噪声消除越多,建议取值:1.0
*/
param->preserve2 = 0.0;   /* 保留参数,mode==1时该参数作为语⾳⻔限,数值越⼩语⾳保留越多,建议取值范
围:[4,6] */
param->preserve3 = 0;     /* 保留参数 */
param->preserve4 = 0;     /* 保留参数 */
4.7 NachhallentfernungParametereinstellungen
Nachhallentfernung wird über rkaudio_dereverb_param_init() konfiguriert:
param->rlsLg       /* RLS滤波器阶数,⽤于唤醒模块去混响,⼀定范围内,阶数越⼤,去混响效果越强,算⼒消耗越
⼤,建议取值:4 */
param->curveLg     /* 分布曲线阶数,⽤于通话模块去混响,阶数越⼤,去混响效果越强,越容易过消,建议取值:10
*/
param->delay       /* RLS滤波器延时,决定早期混响保留程度,建议取值:2 */
param->forgetting  /* RLS滤波器遗忘因⼦,因⼦越⼩,rls去混响能⼒越强,越容易过消,建议范围:0.98-0.999
*/
param->T60         /* 混响时间估计值(单位:s),越⼤,去混响能⼒越强,但是越容易过消除,低混响场景建议取值
0.68,中⾼混响场景建议取值1.5 */
param->coCoeff     /* 互相⼲性调整系数,防⽌过消除,越⼩能⼒越强,低混响场景建议取值2,中⾼混响场景建议取
值1 */
4.8 AESModulParametereinstellungen
AES dient nichtlinearer Verarbeitung und wird über rkaudio_aes_param_init() konfiguriert.
param->Beta_Up        /* 上升速度,该值越⼤则⾮线性抑制越强,建议0.001-0.01之间  */
param->Beta_Down      /* 下降速度,该值越⼤则⾮线性抑制越弱,建议0.001-0.01之间  */
param->Beta_Up_Low    /* 低频段上升速度,特性以及取值同Beta_Up */
param->Beta_Down_Low  /* 低频段下降速度,特性以及取值同Beta_Down */
param->low_freq       /* 低频分段 */
param->high_freq      /* ⾼频分段 */
param->THD_Flag       /* 置1开启谐波失真抑制,置0则关闭 */
param->HARD_Flag      /* 置1开启Hard模式,对于回声消除抑制更强,但也有可能造成语⾳过消 */
int i, j;

/**
 * 3列分别对应低频分段、中频分段、⾼频分段(由上⾯的low_freq以及high freq设置
 * 第⼀⾏表⽰各频段残留回声的⽐例最⼩值,⼀般建议取值范围[1.0f, 5.0f],设置越⼤,回声消除效果越强
 * 第⼆⾏表⽰各频段消除残留回声的⽐例,⼀般建议取值范围[1.0f, 3.0f],设置越⼤,回声消除效果越强
 */
param->LimitRatio[2][3]

/**
 * 谐波抑制频段,最多设置4个频段,不需要时该⾏可以全置0
 * 每⼀⾏表⽰⼀个频段,第⼀列表⽰频段起始点,第⼆列表⽰频段终⽌点。取值范围均为[0,1/2*sample rate]
 */
param->ThdSplitFreq[4][2]

/**
 * 谐波抑制程度,对应上表的四个频段,配置的对应消除⽐例,当上⾯有全0⾏时,该表对应⾏的设置也将⽆效
 * 从第⼀列到最后⼀列分别表⽰频段内有可能成为⼆次到⼗⼀次谐波时消除相应基频的⽐例,⼀般建议取值范围
 * [0.001f,1.0f],设置越⼤,消除效果越强
 */
param->ThdSupDegree[4][10]

/**
 * 配置为Hard模式的频段以及计算平均增益的频段,第⼀列表⽰起始,第⼆列表⽰终⽌,取值范围均为
 * [0,1/2*sample rate],配置为Hard模式的频段最多设置4个,最后⼀⾏为计算平均增益的频段,
 * 该频段将在下⼀个参数HardThreshold中进⾏使⽤
 */
param->HardSplitFreq[5][2]

/**
 * Hard模式开启阈值,4个阈值分别对应上个参数配置的4个频段
 * 使⽤平均增益频段和该参数配置的阈值进⾏对⽐,当平均增益低于阈值时,对应的频段会开启Hard模式
 */
param->HardThreshold[4]
4.9 AGCModulParametereinstellungen
AGC verstärkt Sprache und wird über rkaudio_agc_param_init() konfiguriert:
param->attack_time = 400.0;   /* 建议范围:20~600ms。触发时间,即AGC增益上升所需要的时间 */
param->release_time = 400.0;  /* 建议范围:20~600ms。施放时间,即AGC增益下降所需要的时间 */
param->max_gain = 30.0;       /* 建议范围:0~50dB。最⼤增益,同时也是线性段增益 */
param->max_peak = -3.0;       /* 取值范围:0~-87dB。经AGC处理后,输出语⾳的最⼤能量 */
param->fRth0 = -65.0f;        /* 取值范围:0~-87dB。噪声⻔阈值,低于该值的语⾳不被增益 */
param->fRth1 = -60.0f;        /* 取值范围:0~-87dB。扩张段结束能量dB阈值,⾼于该值的语⾳以max_gain增
益 */
param->fRth2 = -35.0f;        /* 取值范围:0~-87dB。压缩段起始能量dB阈值,⾼于该值的语⾳增益逐渐下降⾄
0dB */
Hinweis 1: Im Kompressionsbereich muss fRth2 + max_gain kleiner als 0dB und max_peak sein, sonst tritt Clipping auf. Hinweis 2: Die aufgeführten AGC-Parameter sind gültig; alle anderen sind veraltet. Frühere Versionen können sie aus Kompatibilitätsgründen enthalten, spätere Versionen entfernen sie schrittweise.
4.10 KomfortgeräuschParametereinstellungen
CNG fügt beim Gespräch Komfort-Weißrauschen hinzu, ist nur in der Aufnahmeverarbeitung vorhanden und normalerweise ausgeschaltet.
param->fSmoothAlpha  /* 取值范围:0.0f~1.0f,施加舒适噪声平滑度,默认0.92 */
param->fSpeechGain   /* 取值范围:0.0f~1.0f,施加舒适噪声语⾳纹理模拟程度,默认0.3 */
param->fGain         /* 建议范围:0~50dB,施加舒适噪声幅度⽐例,默认2 */
param->fMpy          /* 建议范围:0~50dB,⽩噪随机数⽣成幅度,默认5 */
4.11 DTDModulParametereinstellungen
DTD erkennt Einzel- oder Doppelsprechen.
param->ksiThd_high = 0.70f  /* 单双讲判决阈值,ceil阈值,⾼于该阈值判断为单讲 */
param->ksiThd_low = 0.50f;  /* floor阈值,低于该阈值判断为单讲 */
Hinweis: Dies ist der Anfangsschwellwert; der Algorithmus aktualisiert ihn adaptiv.
4.12 empfohlene Parameter
Empfohlene Aufweckparameter:
param->model_bf_en = EN_Wakeup | EN_Fastaec | EN_STDT | EN_Agc;
Empfohlene Gesprächsparameter:
param->model_bf_en = EN_Fastaec | EN_STDT | EN_AES | EN_Anr | EN_Dereverberation | EN_Agc;